التعلّم شبه الخاضع للإشراف وذاتي الإشراف: ما دور الإجابات المرجعية؟
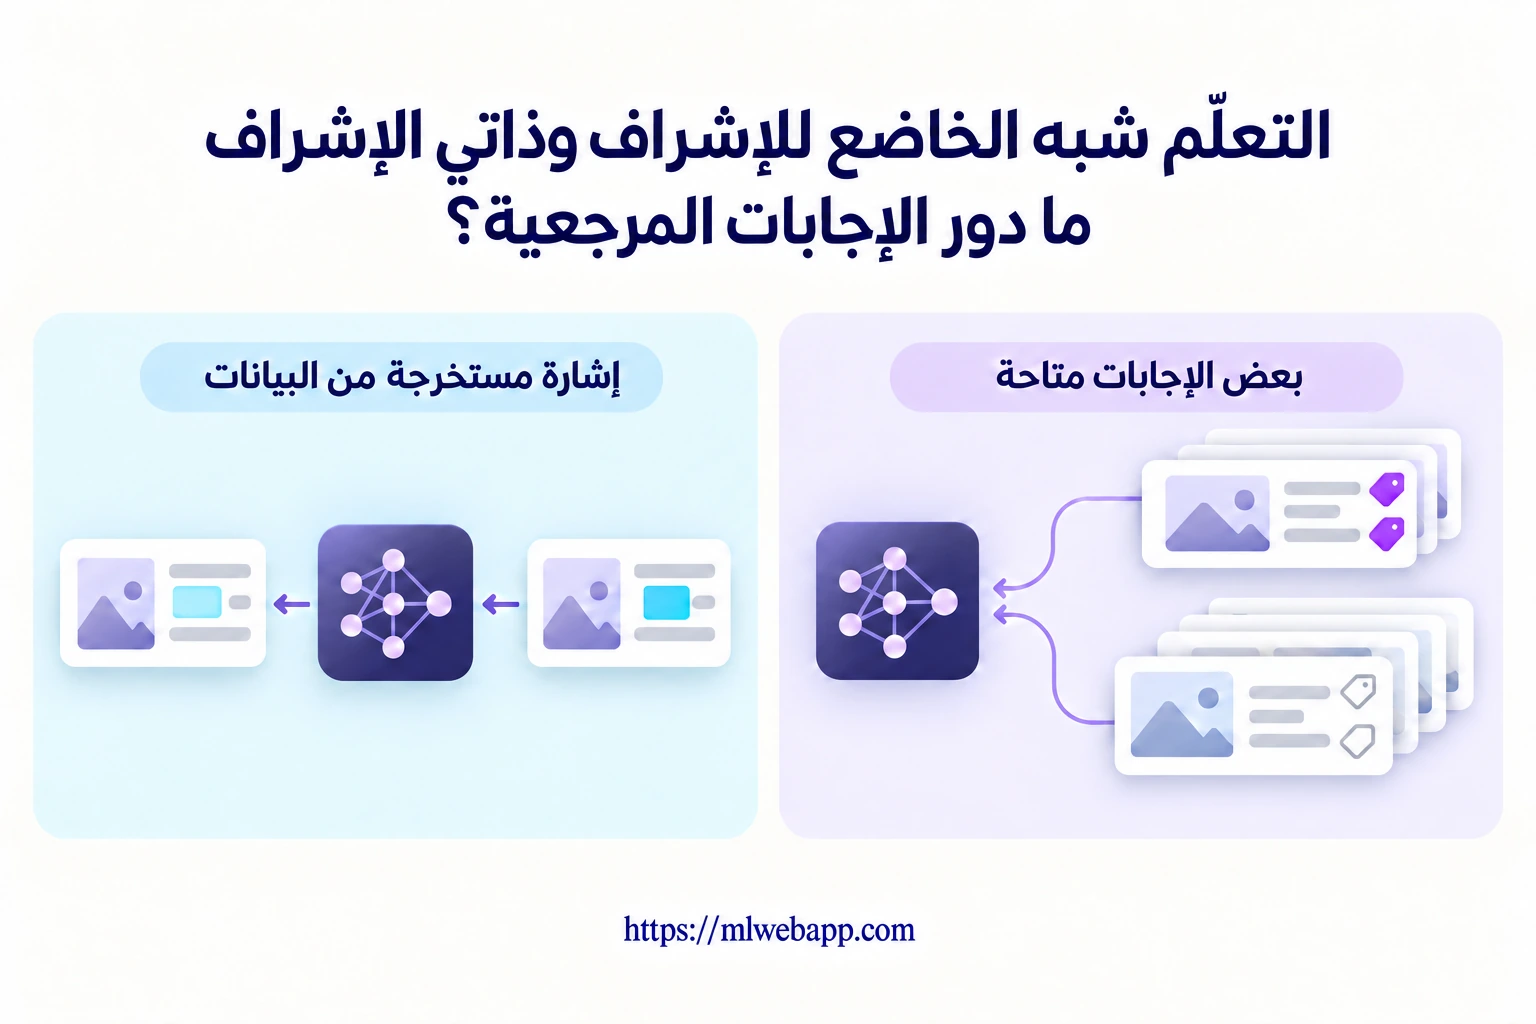
يستخدم التعلّم شبه الخاضع للإشراف (semi-supervised learning) أمثلة تتوفر إجاباتها وأخرى لا تتوفر إجاباتها. أما التعلّم ذاتي الإشراف (self-supervised learning) فيبني هدفًا للتدريب من البيانات نفسها، مثل إعادة بناء قيمة أُخفيت مؤقتًا. يتعلق الفرق بمصدر الإجابات المستخدمة أثناء التدريب. ويمكن الجمع بين النهجين للاستفادة من بيانات لا تتوفر إجابات مرجعية إلا لجزء منها.
يحدّد الاختيار بين الانحدار، التصنيف والتجميع المهمة المطلوب إنجازها. ثم نحتاج إلى فحص البيانات المتاحة: كيف يتعلّم النموذج إذا كانت خصائص الملاحظات معروفة، بينما تغيب الإجابة المطلوبة عن بعضها؟ ستتعرّف إلى الفرق بين الإجابات المرجعية المتاحة، والتنبؤات التي يُعاد استخدامها أثناء التدريب، والإجابات التي تُبنى من المدخلات، ثم تحدّد طريقة تقييم مناسبة.
قبل أن تبدأ. تمثّل كل ملاحظة صفًا في البيانات، وخصائصها هي المعلومات التي تصفها. أما المتغير الهدف فهو الإجابة التي يتعلّم النموذج التنبؤ بها. يمكنك مراجعة دور المتغير الهدف في التعلّم الخاضع للإشراف وغير الخاضع للإشراف. وتستخدم الأمثلة حقولًا من مجموعة بيانات Student Performance Factors المعتمدة.
محتويات المقال
الإجابات المرجعية وإشارة التعلّم
الإجابة المرجعية هي القيمة المعروفة المرتبطة بمثال في مهمة محددة، ويُستخدم لها المصطلح الإنجليزي label. في مجموعة بيانات التصنيف المستخدمة في هذه الأمثلة، Result هو اسم المتغير الهدف، بينما تكون الإجابة المرتبطة بالصف إحدى القيمتين Success أو Fail. إذن، يشير المصطلح هنا إلى قيمة تخصّ المثال، وليس إلى اسم العمود.
في الانحدار، تكون الإجابة المرجعية قيمة عددية، تُسمّى غالبًا قيمة المتغير الهدف. وتستخدم مجموعة بيانات الانحدار في المشروع Exam_Score بوصفه المتغير الهدف الوحيد. لذلك، فإن مسألة توفر الإجابات تخصّ أيضًا التنبؤ بكمية عددية.
معاملات النموذج هي القيم التي يعدّلها أثناء التدريب. أما إشارة التعلّم فهي المعلومات التي توجّه هذه التعديلات. في التعلّم الخاضع للإشراف، تُقارَن التنبؤات بالإجابات المتاحة. وقد تأتي هذه الإجابات من قياس، أو سجل، أو مراجعة الأمثلة وتحديد الفئة التي ينتمي إليها كل منها؛ ولا يشترط أن يُدخلها شخص واحدةً تلو الأخرى. وتبقى جودتها وملاءمتها بحاجة إلى التحقق.
يُقصد بعبارة «دون إجابة مرجعية» دائمًا غياب الإجابة الخاصة بالمهمة المدروسة. فقد يتضمن الصف ساعات الدراسة ونسبة الحضور من دون الفئة المطلوب التنبؤ بها، ولا يعني ذلك أنه صف فارغ. أما غياب قيمة من المدخلات، مثل ساعات النوم، فيطرح سؤالًا مختلفًا: ما المعلومات التي يتلقاها النموذج لوصف هذه الحالة؟
التعلّم شبه الخاضع للإشراف: أمثلة بإجابات مرجعية وأخرى دونها
يجمع التعلّم شبه الخاضع للإشراف بين ملاحظات بإجابات مرجعية وملاحظات دون إجابات مرجعية لتعلّم المهمة المطلوبة. توفّر الأولى إجابات مرجعية، وقد تساعد الثانية على الاستفادة من أوجه التشابه بين الملاحظات. تعرض وثائق scikit-learn عن التعلّم شبه الخاضع للإشراف هذا الإطار، وتوضّح أن فائدته تعتمد على افتراضات عن البيانات. فقد تفترض طريقة تعتمد على التجاور أن الملاحظات المتقاربة تنتمي غالبًا إلى الفئة نفسها. لكن التشابه وحده لا يضمن صحة هذا الافتراض.
لنأخذ مجموعة بيانات التصنيف التي تضم Result بوصفه المتغير الهدف الوحيد، وقد مُلئ مسبقًا بـ Success أو Fail. لفهم الفكرة، افترض أن التدريب لا يستطيع الوصول إلا إلى بعض هذه الإجابات المرجعية. تبقى الصفوف الأخرى متاحة بمدخلاتها، لكن إجاباتها تُحجب عن التدريب. ندرس هذه الحالة على نسخة عمل، مع إبقاء البيانات المرجعية دون تغيير.
يتيح إخفاء إجابات معروفة محاكاة عدم توفرها أثناء التدريب. في الواقع، قد تصل بعض الإجابات بعد وصول المدخلات، أو تتطلب تحققًا إضافيًا. وتعتمد فائدة النهج على سبب عدم توفر الإجابات المرجعية، وجودة الإجابات المرجعية المتاحة، والمعلومات التي تضيفها الملاحظات غير المصحوبة بإجابات مرجعية. تساعد هذه المحاكاة على دراسة الطريقة. أما أي خفض فعلي في الجهد اللازم لتوفير الإجابات المرجعية، فيحتاج إلى قياس مستقل.
إحدى الطرق الممكنة هي استخدام إجابات مؤقتة يقترحها النموذج، وتُعرف باسم pseudo-labeling: يقترح نموذج أولي فئات لملاحظات لا تتوفر إجاباتها المرجعية، ثم تُستخدم بعض هذه المقترحات بوصفها إجابات مؤقتة أثناء التدريب. وتكرّر طريقة self-training هذا الإجراء: التدريب على الأمثلة المتاحة، ثم اختيار بعض التنبؤات، ثم إعادة تدريب النموذج باستخدام هذه المعلومات الإضافية.
ومن الأفكار الأخرى مطالبة النموذج بإنتاج تنبؤات متسقة عندما تخضع المدخلات لتحويل يُفترض أن يحافظ على فئتها. يُعرف هذا الأسلوب باسم consistency regularization، وفيه يُضاف قيد إلى التدريب للحدّ من التغيّرات غير المبرّرة في التنبؤات. تجمع طريقة FixMatch التي اقترحها Sohn وزملاؤه بين هذه الفكرة والإجابات المؤقتة. ويعتمد التحويل المناسب على المجال؛ فتغيير قيمة مرتبطة بالدراسة عشوائيًا لا يضمن بقاء معنى الحالة كما هو.
كيف تختار الإجابات المؤقتة؟ من الخيارات قبول التنبؤات التي تتجاوز ثقتها عتبة محددة، أو اختيار عدد من التنبؤات الأعلى ثقة في كل دورة، كما توضّح وثائق scikit-learn. تحدّد هذه القاعدة ما يُضاف إلى التدريب؛ ولا تثبت صحة الإضافات. ويمكن إبقاء بعض الصفوف دون إجابة مؤقتة عندما لا تستوفي شرط الاختيار. قارن قواعد الاختيار باستخدام مجموعة التحقق، وافحص الفئات التي يكثر قبولها، لأن كثرة المقترحات وحدها ليست دليلًا على فائدتها.
لا يقتصر التعلّم شبه الخاضع للإشراف على الإجابات المؤقتة. فبعض الطرق تستخدم علاقات التجاور بين الملاحظات، وأخرى تفرض اتساق التنبؤات. ويبقى السؤال في جميع الحالات: هل تساعد المعلومات التي تضيفها الأمثلة غير المصحوبة بإجابات مرجعية على تعلّم التنبؤ بالمتغير الهدف فعلًا؟
التعلّم ذاتي الإشراف: بناء مهمة من البيانات
يبني التعلّم ذاتي الإشراف هدفًا للتدريب من معلومات موجودة أصلًا في البيانات. ولا تتطلب هذه المرحلة إجابات مرجعية مُقدَّمة للمهمة النهائية. ويؤكد تعريف CNIL بناء مهام الإشراف انطلاقًا من البيانات نفسها.
لنأخذ مدخلات إحدى ملاحظات المسار فقط: Hours_Studied = 23، Attendance = 84 وSleep_Hours = 7. يمكننا إخفاء قيمة Sleep_Hours مؤقتًا، ثم مطالبة النموذج بإعادة بنائها من المعلومات الظاهرة. كانت الإجابة المرجعية، وهي 7، معروفة قبل الإخفاء؛ ولم يخترعها النموذج. أثناء التدريب، تُقارَن إعادة البناء المقترحة بالقيمة المحفوظة، ويُستخدم الفرق لتعديل معاملات النموذج.
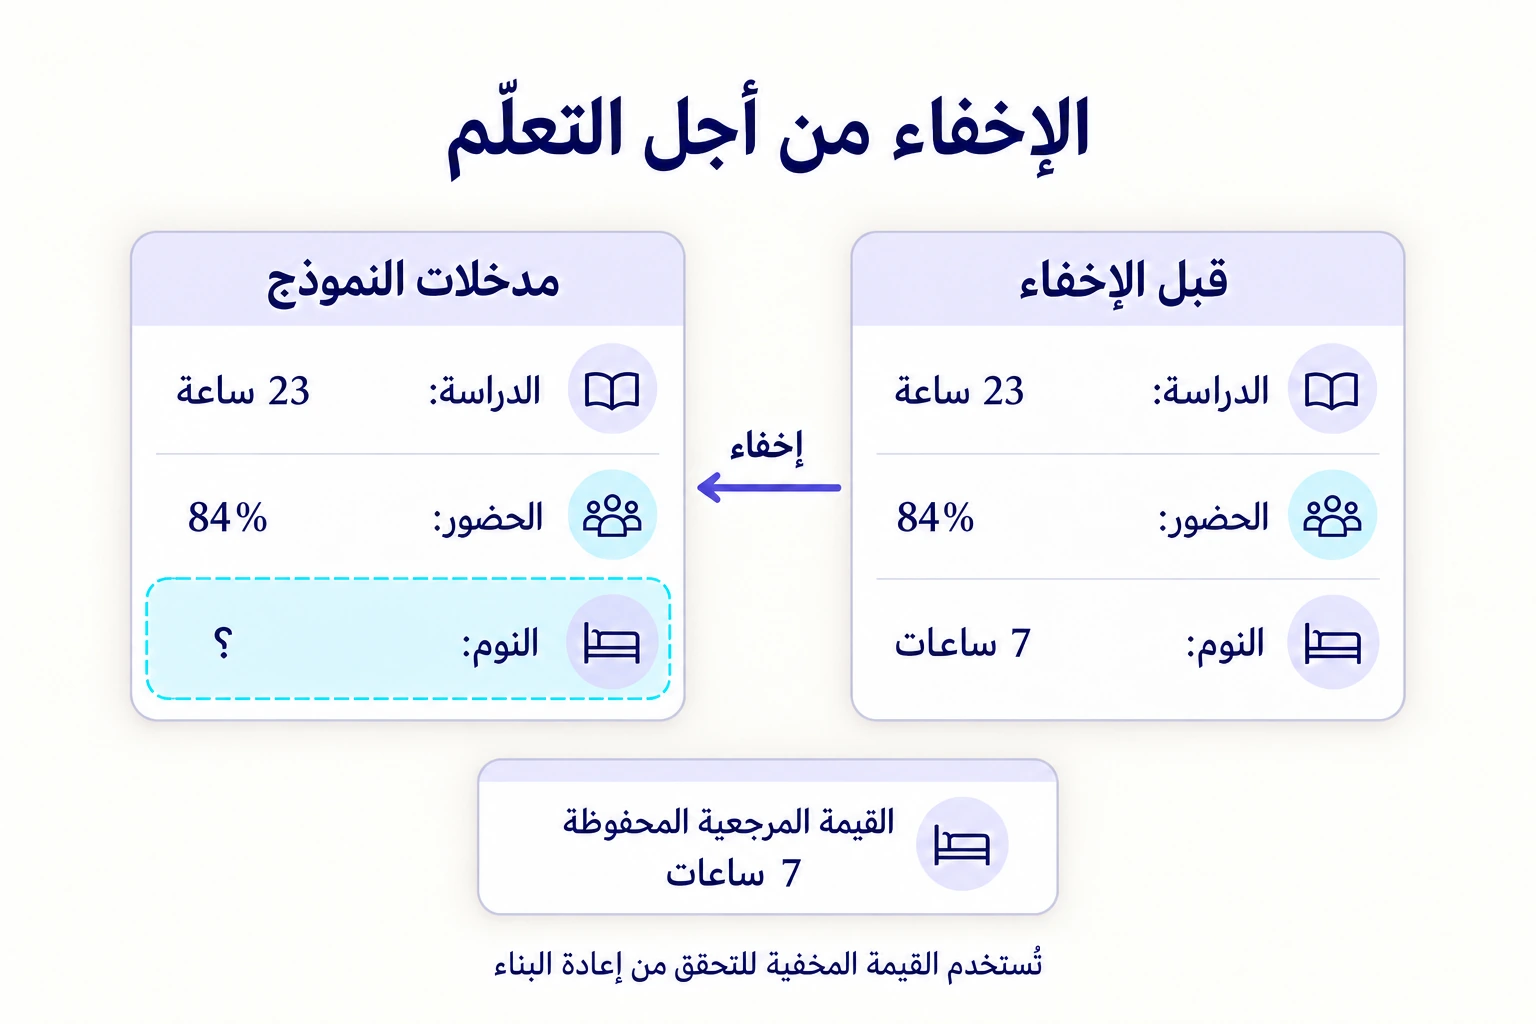
تمثّل إعادة البناء هذه مهمة مساعدة، تُسمّى أحيانًا pretext task؛ ونستخدمها لتعلّم تمثيل للبيانات. والتمثيل المتعلَّم مجموعة قيم عددية تُحسب من المدخلات بواسطة تحويل يتعلّمه النموذج أثناء التدريب. في مثالنا، يصف هذا التمثيل الملاحظة بصورة تختلف عن أعمدتها الأصلية. وقد يحتفظ بأنماط مفيدة لمهمة أخرى، لكن هذه الفائدة تحتاج إلى التحقق.
في البيانات الجدولية، أي البيانات المنظّمة في صفوف وأعمدة، تدرس أبحاث VIME التي قدّمها Yoon وزملاؤه إعادة بناء القيم وتحديد الحقول التي عُدّلت، ضمن أهداف أخرى. ويبيّن هذا المثال إمكان تطبيق التعلّم ذاتي الإشراف على هذا النوع من البيانات.
الإخفاء ليس الهدف الوحيد الممكن. ففي التعلّم التبايني، يتدرّب النموذج على إنتاج تمثيلات متشابهة للأمثلة التي ينبغي ربطها، وتمثيلات مختلفة للأمثلة التي ينبغي التمييز بينها. وفي إعداد شائع للتعلّم ذاتي الإشراف، تُعامَل نسختان من الملاحظة نفسها بوصفهما زوجًا يُراد تقريب تمثيليه، حتى إن اختلف مظهرهما بعد التحويل. تعرض المراجعة البحثية التي أعدّها Liu وزملاؤه عدة عائلات من أهداف التعلّم ذاتي الإشراف. لذلك، فإن اختيار ما ينبغي للتمثيل الاحتفاظ به جزء من تصميم عملية التعلّم.
مقارنة النهجين واستخداماتهما
عند المقارنة بين التعلّم شبه الخاضع للإشراف والتعلّم ذاتي الإشراف، نحتاج إلى تحديد مصدر الإشارة والمرحلة المقصودة. يصف الأول استخدام أمثلة بإجابات مرجعية وأخرى دون إجابات مرجعية معًا لتعلّم المهمة المطلوبة. أما الثاني فيصف كيفية بناء هدف للتدريب من البيانات. ويمكن لنظام واحد الجمع بينهما.
| النهج | الإجابة المستخدمة أثناء التدريب | دور البيانات |
|---|---|---|
| خاضع للإشراف | تتوفر قيمة المتغير الهدف لأمثلة التدريب. | تعلّم العلاقة بين المدخلات والمتغير الهدف مباشرة. |
| شبه خاضع للإشراف | تتوفر قيمة المتغير الهدف لبعض الأمثلة. | استخدام أمثلة لا تتوفر إجاباتها أيضًا لتعلّم المهمة. |
| ذاتي الإشراف | يُبنى الهدف من البيانات نفسها. | تعلّم تمثيل، مثل إعادة بناء قيمة أُخفيت من المدخلات. |
| التجميع غير الخاضع للإشراف | لا تُقدَّم فئات مرجعية. | استكشاف مجموعات وفق الخصائص المختارة. |
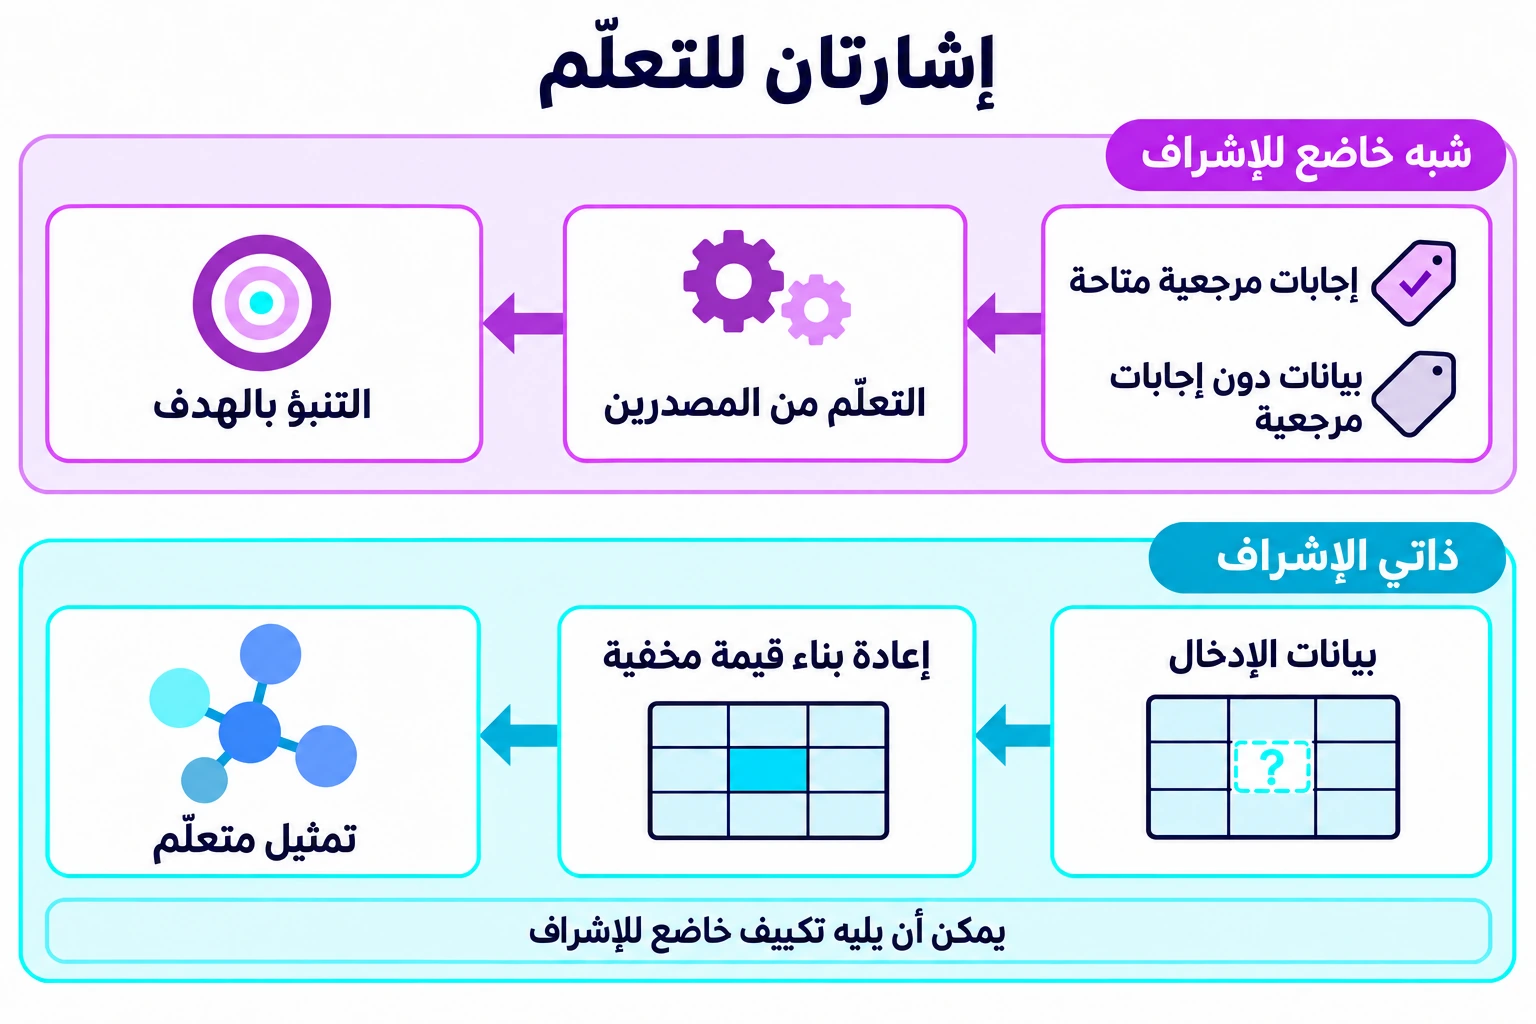
يختلف تصنيف التعلّم ذاتي الإشراف باختلاف المؤلفين. فبعضهم يدرجه ضمن التعلّم غير الخاضع للإشراف، لأن هدفه الأولي لا يتطلب إجابات مرجعية خارجية. ويعرضه جيرون بوصفه فئة مستقلة، لأن التدريب يستخدم مع ذلك قيمًا مستهدفة تُبنى من البيانات (الفصل 1، ص. 16). ولفهم أي طريقة، حدّد دائمًا الإجابات التي تُستخدم للتعلّم والمرحلة التي تُستخدم فيها.
متى تساعد البيانات غير المصحوبة بإجابات مرجعية؟
زيادة عدد الصفوف لا تضمن نموذجًا أفضل. فلكي يفيد التعلّم شبه الخاضع للإشراف، يجب أن تضيف الملاحظات غير المصحوبة بإجابات مرجعية معلومات مناسبة للحالات المراد معالجتها. وإذا كانت تصف أوضاعًا مختلفة جدًا، فقد توجّه الأنماط المتعلَّمة النموذج في اتجاه غير مناسب.
في مثال التصنيف، ينبغي أن تتيح الملاحظات ذات الإجابات المرجعية للنموذج تعلّم التمييز بين الفئتين. ولا يتطلب ذلك تساوي عدد الأمثلة في كل فئة. فإذا كانت أمثلة Fail نادرة أو غائبة، فقد يميل النموذج إلى Success. وقد تعزّز إجاباته المؤقتة هذا الاختلال في التوازن. لذلك، افحص الأخطاء في كل فئة، بدل الاكتفاء بالنسبة الإجمالية للإجابات الصحيحة.
في التعلّم ذاتي الإشراف، تنتقل الصعوبة إلى ملاءمة المهمة المساعدة. فقد تساعد إعادة بناء ساعات النوم على تعلّم بعض العلاقات بين المدخلات. لكن ذلك لا يثبت فائدة التمثيل في التنبؤ بفئة أو درجة. وقد تُحل مهمة شديدة السهولة من دون تعلّم العلاقات المهمة للاستخدام النهائي.
في مشروع الانحدار، تتوفر قيم سابقة للمتغير الهدف. لذلك، من المعقول البدء بنموذج مرجعي خاضع للإشراف وقياس أخطائه. أما اللجوء إلى تدريب مسبق أكثر تعقيدًا، فيحتاج إلى سبب محدد ومقارنة في الظروف نفسها. ولا يكفي اسم الطريقة وحده لتبرير إضافتها إلى التطبيق.
تقييم المهمة النهائية بالرجوع إلى إجابات مرجعية
المهمة النهائية، وتُسمّى أيضًا downstream task، هي المهمة التي ستُستخدم نتيجتها. فإعادة بناء مدخل مخفي بصورة صحيحة والتنبؤ الصحيح بـResult هدفان مختلفان. يصف خطأ إعادة البناء الأداء في المهمة المساعدة، ولا يقيس مباشرة جودة نموذج التصنيف النهائي.
التعميم هو قدرة النموذج على معالجة ملاحظات جديدة لم تُستخدم في تدريبه. لتقييم هذه القدرة، خصّص مجموعة اختبار قبل إعداد البيانات وتدريب النماذج. فلا تُستخدم ملاحظاتها في التدريب المسبق ذاتي الإشراف، أو التدريب بإجابات مؤقتة، أو اختيار الإعدادات. وتبقى إجاباتها مخفية حتى التقييم النهائي. يساعد هذا الفصل على منع تسرّب البيانات الذي توضّحه وثائق scikit-learn، وهو تأثير معلومات محفوظة للتقييم في بناء النموذج.
تُستخدم مجموعة التحقق (validation set) لمقارنة الخيارات أثناء التطوير، مثل الطريقة، أو عدد الإجابات المؤقتة المقبولة، أو إعدادات النموذج. ثم تُستخدم مجموعة الاختبار لقياس أداء النظام المختار. وينبغي أن تمثّل بيانات التحقق والاختبار الحالات التي يُتوقع أن يعالجها التطبيق (جيرون، الفصل 1، ص. 37). وإذا رجعت إلى الاختبار مرارًا لاختيار إحدى النسخ، فستؤثر نتائجه في قراراتك، ولن تعود نتيجته تقييمًا نهائيًا مستقلًا عن التطوير.
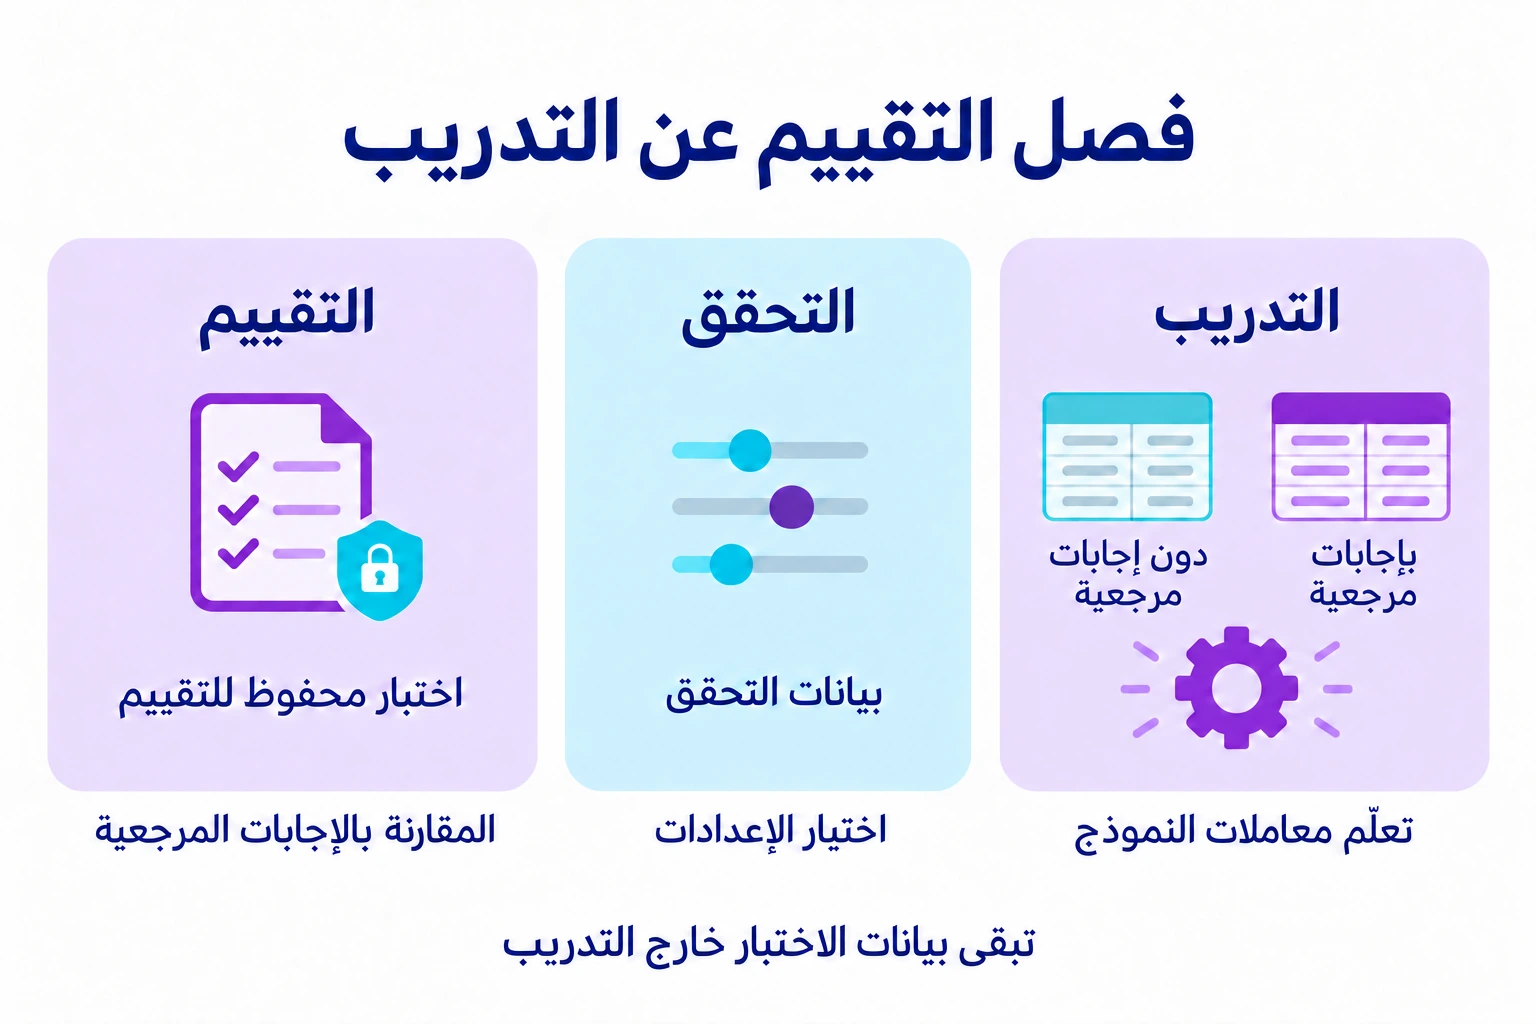
تستخدم بعض البروتوكولات، المعروفة باسم بروتوكولات transductive، مدخلات الحالات المراد التنبؤ بإجاباتها، مع إبقاء إجاباتها المرجعية مخفية. وتهدف إلى استكمال إجابات تلك المجموعة المحددة، بدل تقييم الأداء على حالات جديدة تمامًا. لذلك، يجب توضيح البروتوكول عند مقارنة الطرق في الظروف نفسها. أما هنا، فنقيّم التعميم على حالات جديدة.
لتقييم ما تضيفه طريقة شبه خاضعة للإشراف، قارنها بنموذج خاضع للإشراف تدرب على الأمثلة ذات الإجابات المرجعية نفسها. ولتقييم تمثيل متعلَّم ذاتيًا، افحص أداء المهمة النهائية مع هذا التدريب المسبق ومن دونه. في مجموعة بيانات التصنيف، تبقى الإجابات المرجعية هي القيم المتاحة في Result؛ واستبدالها بإجابات النموذج يُفسد المقارنة.
لتنظيم المقارنة عمليًا، دوّن ما يمكن لكل مرحلة الوصول إليه: مدخلات التدريب، والإجابات المرجعية المتاحة، والصفوف الإضافية دون إجابات، وبيانات التحقق والاختبار. احتفظ بالتقسيم نفسه عند مقارنة النماذج، وبالإجابات المرجعية نفسها لتدريب التصنيف. عندئذ يمكن تفسير الفرق في النتائج على ضوء التغيير الذي اختبرته، مثل إضافة الصفوف غير المصحوبة بإجابات أو استخدام التدريب المسبق. وإذا منحت أحد النماذج إجابات مرجعية إضافية، فقد تغير شرط المقارنة أيضًا.
افصل كذلك بين تعلّم تحويل للبيانات وتطبيقه. فإذا احتاجت الطريقة إلى متوسطات أو مقاييس تُحسب من الصفوف، فتعلّمها من بيانات التدريب ثم استخدم القيم المحفوظة لتحويل بيانات التحقق والاختبار. إعادة حسابها على مجموعة الاختبار تسمح لمعلومات منها بالتأثير في النظام. وتوضح وثائق منع تسرّب البيانات أن هذا الاحتياط يشمل إعداد المدخلات، حتى عندما لا تُستخدم إجابات الاختبار صراحةً.
وعند قراءة المقارنة، اربط كل نتيجة بالسؤال الذي تقيسه: هل تحسّن التنبؤ في المهمة النهائية؟ أم انخفض خطأ إعادة البناء فقط؟ افحص أيضًا أخطاء كل فئة وعدد الحالات التي يستند إليها التقييم. وقد تبدو النسبة الإجمالية جيدة مع استمرار الإخفاق في الفئة النادرة. تساعد هذه الخطوات على تفسير النتائج وربطها بظروف التدريب التي أُجريت فيها المقارنة.
تمرين: حدّد مصدر إشارة التعلّم
لكل حالة، حدّد إطار التعلّم، ومصدر الإجابة المستخدمة للمقارنة، واحتياطًا ينبغي اتخاذه. يمكنك الإجابة على الورق.
- يتعلّم نموذج التنبؤ بـ
Resultباستخدام الملاحظات التي تتوفر له إجاباتها المرجعية فقط. - تُستخدم الملاحظات ذات الإجابات المرجعية نفسها، ثم تُضاف صفوف أخرى بمدخلاتها والفئات المؤقتة التي اقترحها نموذج أولي.
- تُخفى
Sleep_Hoursفي بعض المدخلات، ثم تُقارَن إعادة البناء بالقيمة المعروفة قبل الإخفاء. - بعد هذا التدريب المسبق على المدخلات، يُكيَّف النموذج للتصنيف باستخدام الإجابات المرجعية المتاحة في
Result. - يُقاس الأداء النهائي بمقارنة التنبؤات بإجابات مؤقتة أنتجها النموذج نفسه.
اعرض الإجابات مع الشرح
- تعلّم خاضع للإشراف. الإجابة المرجعية المستخدمة للمقارنة هي القيمة المتاحة في
Result. ولا يستفيد التدريب هنا من أمثلة إضافية دون إجابات مرجعية. - تعلّم شبه خاضع للإشراف باستخدام الإجابات المؤقتة. بعض الإجابات متاح، وبعضها الآخر تنبؤات مؤقتة. ينبغي التحقق من طريقة اختيارها ومن خطر تعزيز الأخطاء الأولية.
- تعلّم ذاتي الإشراف. تأتي الإجابة من المدخل الأصلي قبل الإخفاء. وهي معروفة لمهمة إعادة البناء، من دون إجابة مرجعية خارجية للتصنيف.
- تدريب مسبق ذاتي الإشراف، ثم تكييف خاضع للإشراف. للمرحلتين هدفان مختلفان. قيّم الأداء في مهمة التصنيف النهائية باستخدام إجابات مرجعية محفوظة للتقييم.
- تقييم غير كافٍ. الاتفاق مع الإجابات المؤقتة التي أنتجها النموذج نفسه لا يثبت صحة الفئات المتنبأ بها. نحتاج إلى إجابات مرجعية لم تُستخدم في التدريب.
التباسات ينبغي تجنّبها
الخلط بين self-training والتعلّم ذاتي الإشراف. يشير الاسم الأول هنا إلى إجراء شبه خاضع للإشراف، يُعيد استخدام التنبؤات بوصفها إجابات مؤقتة. أما self-supervised learning فيبني هدفه من البيانات. وتشابه الاسمين بالإنجليزية لا يجعلهما قابلين للتبادل.
فهم كلمة «ذاتي» على أنها غياب للاختيارات البشرية. يختار الإنسان البيانات، والمهمة المساعدة، والتحويلات وظروف التقييم. ويعدّل النموذج معاملاته وفق هذا الهدف؛ ولا يقرر بنفسه ما سيكون مفيدًا في التطبيق.
الخلط بين الإخفاء وغياب البيانات فعلًا. للتحقق من إعادة البناء، يجب أن تكون القيمة المخفية معروفة قبل التمرين. فالخلية الفارغة في الملف لا توفّر هذا المرجع. ولا يمكن قياس الخطأ بالنسبة إلى قيمة لم تُرصد أصلًا.
ما ينبغي تذكّره
يستخدم التعلّم شبه الخاضع للإشراف إجابات مرجعية متاحة لبعض الأمثلة، إلى جانب المعلومات الموجودة في ملاحظات أخرى. ويبني التعلّم ذاتي الإشراف مهمة تدريب من البيانات نفسها. ويمكن الجمع بينهما، على أن تُقاس فائدتهما وفق مهمة نهائية وإجراء تقييم محددين بوضوح.
المصادر وقراءات إضافية
Aurélien Géron، Hands-On Machine Learning with Scikit-Learn and PyTorch، الطبعة الأولى، أكتوبر 2025، إصدار 22 أكتوبر 2025: الفصل 1، الصفحات 14–16 و35–37؛ الفصل 8، ص. 264؛ الفصل 11، الصفحات 383–388؛ الفصل 16، الصفحات 670–671. تعرض هذه المقاطع أطر التعلّم، وself-training، والتدريب المسبق، والتكييف والتعلّم التبايني.
- scikit-learn، التعلّم شبه الخاضع للإشراف: الإطار العام، وself-training وlabel propagation؛ منع تسرّب البيانات.
- CNIL، تعريف التعلّم ذاتي الإشراف بالفرنسية.
- Kihyuk Sohn وزملاؤه، FixMatch: Simplifying Semi-Supervised Learning with Consistency and Confidence، NeurIPS، 2020.
- Jinsung Yoon، Yao Zhang، James Jordon وMihaela van der Schaar، VIME: Extending the Success of Self- and Semi-supervised Learning to Tabular Domain، NeurIPS، 2020.
- Xiao Liu وزملاؤه، Self-supervised Learning: Generative or Contrastive، نسخة المراجعة البحثية لعام 2021.
- Student Performance Factors، Kaggle: مصدر مجموعة البيانات المستخدمة في المسار. جرى التحقق من أسماء الحقول وقيم المثال في المصنف المحلي.
