Apprentissage supervisé et non supervisé : comprendre le rôle de la cible
La différence entre apprentissage supervisé et non supervisé tient à ce qui guide l’apprentissage. Dans le premier cas, chaque exemple utilisé pour apprendre est accompagné d’une réponse connue : la cible, c’est-à-dire la valeur que l’on souhaite prédire. Dans le second, aucune cible n’est fournie pour guider cette analyse ; la méthode recherche des structures dans les données. La présence d’une colonne « note » dans un tableau ne décide donc pas, à elle seule, du type d’apprentissage.
Avec les mêmes informations scolaires, vous pouvez chercher à estimer une note finale ou à regrouper des observations qui se ressemblent. Ces questions conduisent à deux façons différentes d’utiliser les données. À la fin de cette leçon, vous saurez reconnaître une cible, la séparer des variables d’entrée et expliquer ce qui change lorsqu’on apprend sans cible. Cette distinction reprend les cadres d’apprentissage présentés par Google.
Sommaire
Lire un tableau : distinguer les entrées et la cible
Une observation est un exemple décrit par les données : ici, une ligne consacrée à un élève. Une variable est une caractéristique enregistrée dans une colonne, comme le nombre d’heures d’étude ou la note finale. Les variables d’entrée, souvent notées X, sont les informations que vous fournissez au modèle. La cible est généralement notée y. Ces notations sont notamment celles du glossaire de scikit-learn.
Prenons la première observation de la feuille « Données ». Si notre question est « Peut-on estimer la note finale à partir des heures d’étude, de la présence et des notes précédentes ? », les rôles se répartissent ainsi :
| Variable et rôle | Valeur observée |
|---|---|
Hours_StudiedEntrée : heures d’étude. | 23 heures par semaine |
AttendanceEntrée : proportion de cours suivis. | 84 % |
Previous_ScoresEntrée : notes aux examens précédents. | 73 points |
Exam_ScoreCible : note finale. | 67 points |
Les trois entrées décrivent cette observation ; la valeur 67 fournit la réponse enregistrée. Elle n’est pas une estimation produite par un modèle. Lors de l’apprentissage, il faut conserver cette correspondance entre une ligne de X et sa valeur de y : associer les entrées d’un élève à la note d’un autre reviendrait à apprendre sur des réponses mal attribuées.
Le mot « entrée » décrit un usage, pas une cause. Choisir les heures d’étude comme entrée ne démontre pas qu’une modification de ces heures provoquerait une variation précise de la note. L’exemple définit une question de prédiction ; établir une relation causale exige une démarche supplémentaire.
L’apprentissage supervisé : apprendre avec des réponses connues
En apprentissage supervisé, le modèle apprend à partir d’exemples dont les entrées et les réponses sont connues. L’entraînement est cette étape d’apprentissage : les valeurs de y fournissent une référence pour ajuster la relation entre les entrées et la sortie. Dans notre exemple, le modèle reçoit plusieurs observations avec leurs heures d’étude, leur présence, leurs notes précédentes et leur note finale. Il cherche une relation permettant d’estimer cette dernière à partir des entrées.
Le terme « supervisé » ne signifie pas qu’une personne corrige chaque prédiction à la main pendant l’entraînement. La supervision vient des réponses associées aux exemples. Elles peuvent déjà se trouver dans le fichier, comme Exam_Score. La documentation de scikit-learn sur l’apprentissage supervisé rassemble les méthodes qui exploitent ce cadre.
La cible peut être une quantité ou une catégorie
Si vous voulez estimer la note finale en points, la cible est une quantité numérique : la tâche est une régression. Si vous souhaitez prédire une catégorie définie à l’avance, la tâche est une classification. Les deux relèvent de l’apprentissage supervisé, parce que les réponses attendues sont disponibles pour les exemples d’entraînement.
Une réponse de classification est souvent appelée une étiquette : elle indique la catégorie associée à une observation.
Prenons un exemple de classification. Sa cible est Result, déjà remplie avec Success (réussite) ou Fail (échec). Les heures d’étude, la présence et les notes précédentes peuvent servir d’entrées. Le modèle apprend à prévoir la catégorie fournie.
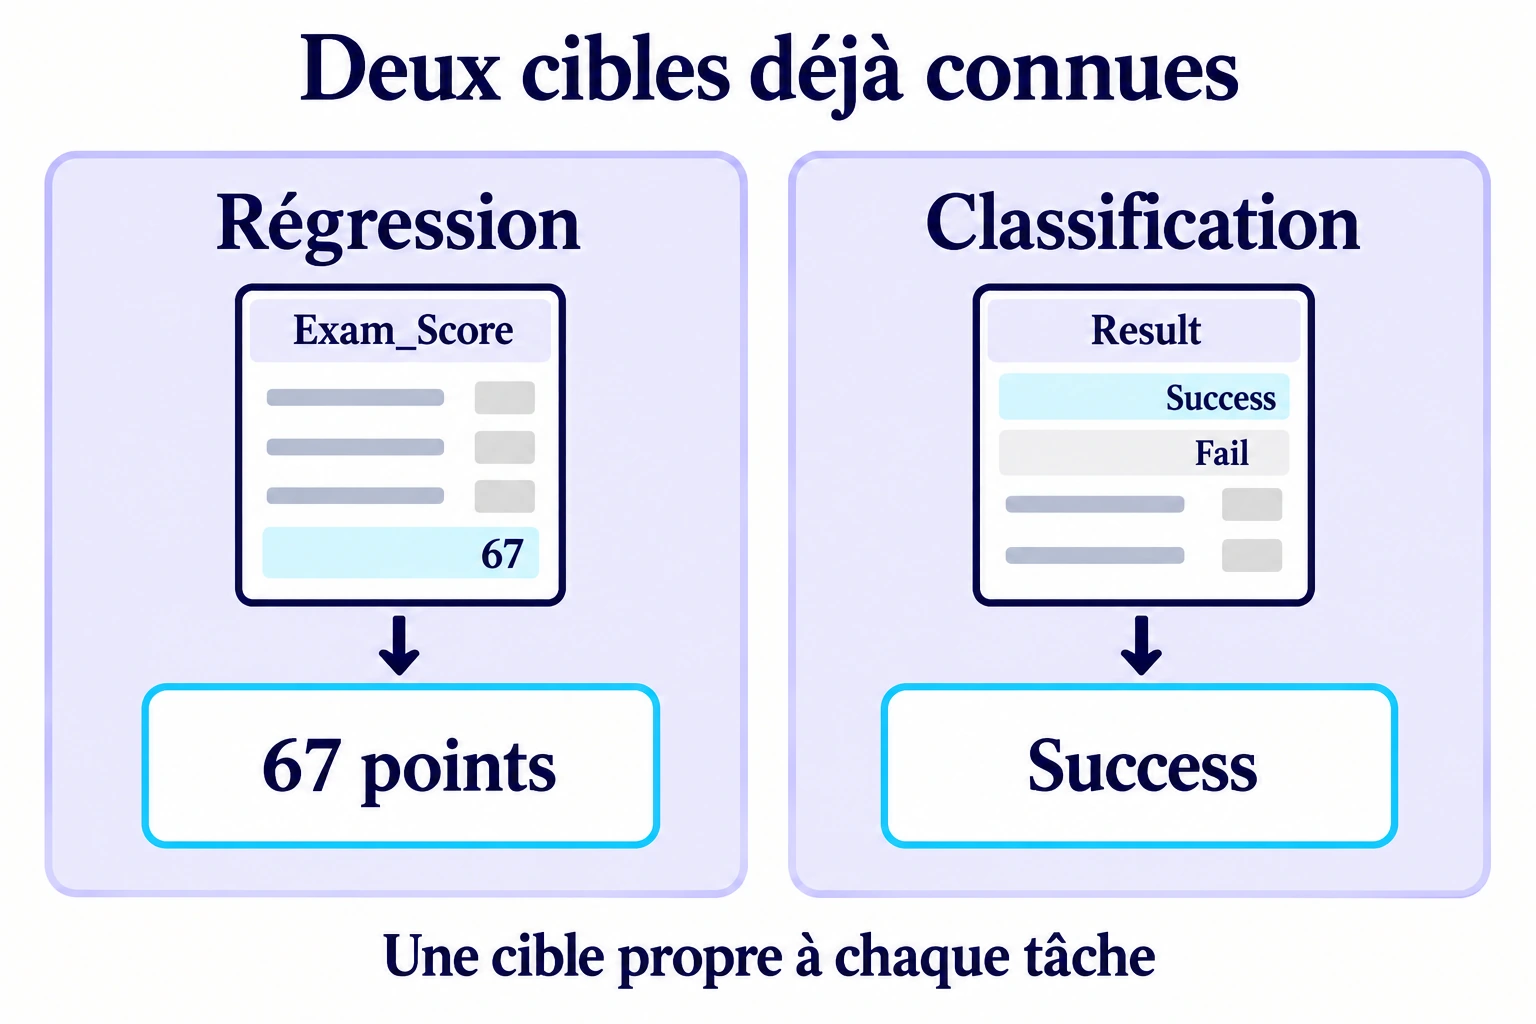
Result pour la classification.Le choix entre quantité et catégorie dépend de la réponse utile au projet. Il ne suffit pas de constater que les données contiennent des nombres : une catégorie peut être codée par un nombre, et une note entière peut servir de cible de régression.
La cible devient inconnue au moment de prédire
La prédiction consiste à utiliser le modèle appris sur de nouvelles entrées. Pour estimer une note avant l’examen, vous fournissez les informations disponibles à ce moment-là, sans la note finale que vous cherchez justement à obtenir. Le modèle renvoie une estimation, dont l’exactitude reste à évaluer.
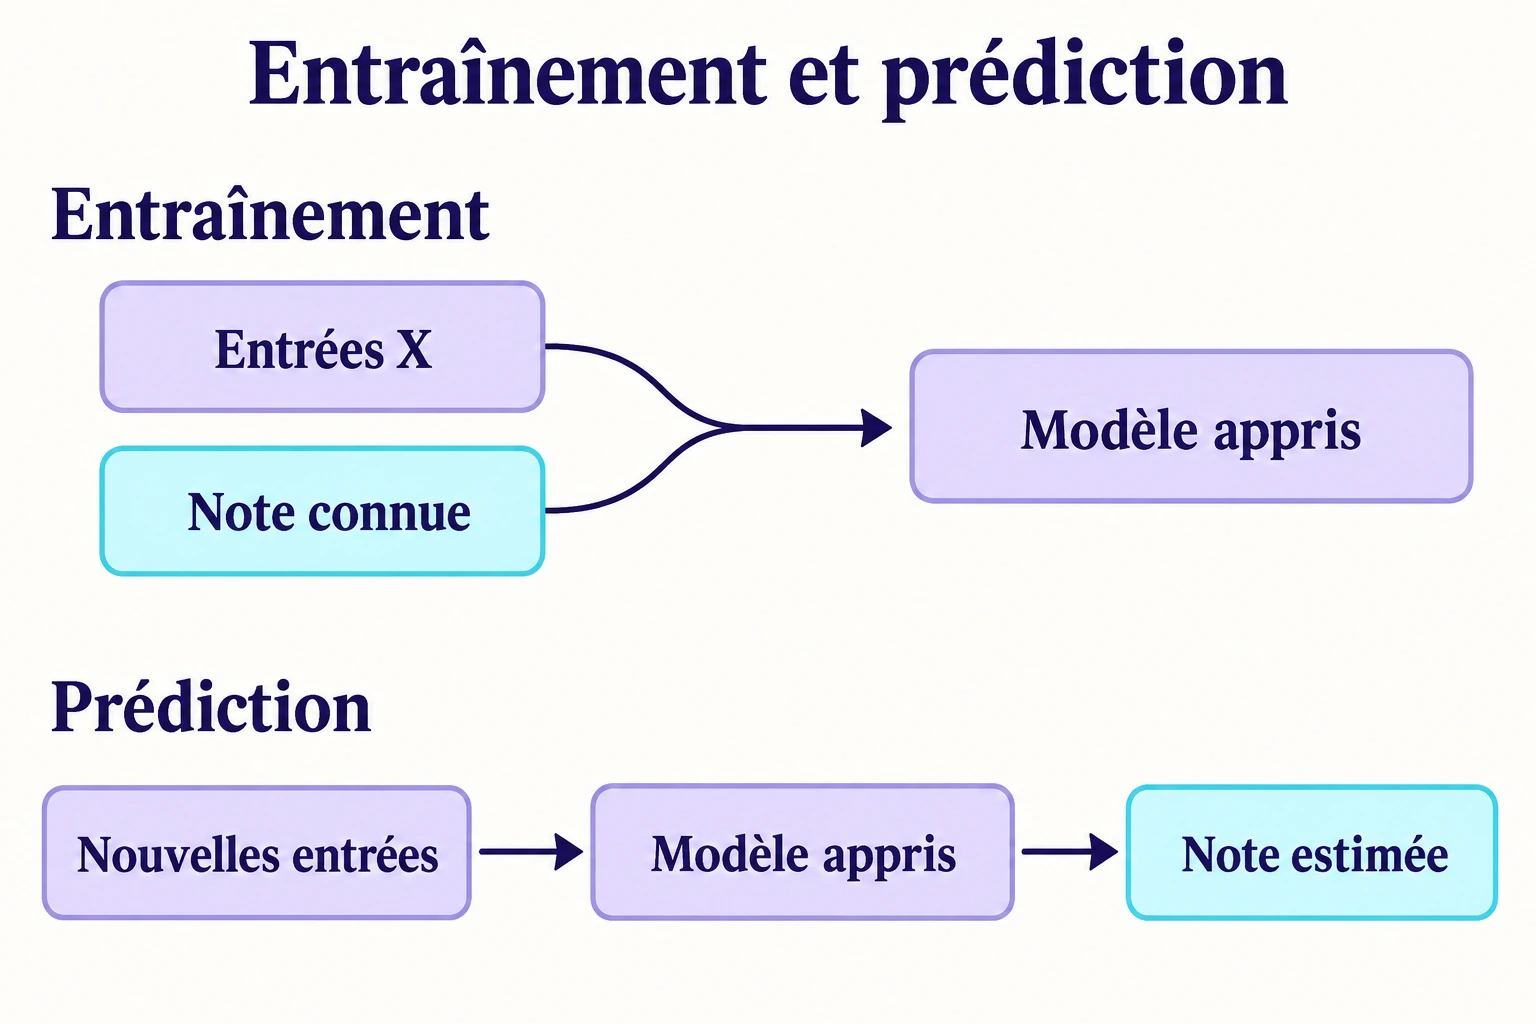
Dans une application, un formulaire pourrait donc demander les heures d’étude, le taux de présence et les notes précédentes, puis afficher une estimation de la note finale. Il ne demanderait pas cette note finale à l’utilisateur : elle constitue précisément la réponse recherchée.
L’absence de y pour ce nouvel élève ne transforme pas le modèle en méthode non supervisée. Il a été entraîné avec des réponses connues. Pour mesurer sa capacité à prédire, on réserve aussi des observations dont la cible est connue, mais que le modèle n’a pas utilisées pour apprendre ; leurs cibles servent ensuite à comparer les estimations aux valeurs enregistrées.
Les données utilisées pour choisir un modèle ou régler ses paramètres doivent être distinguées des données de test final. Ces dernières servent à estimer les performances après les choix de modélisation. Les consulter à répétition pour améliorer le modèle ferait perdre au test son rôle de vérification indépendante.
L’apprentissage non supervisé : rechercher des structures sans cible
En apprentissage non supervisé, aucune réponse cible n’est fournie pour orienter l’apprentissage de cette analyse. La méthode examine les entrées afin d’y rechercher une organisation, par exemple des observations proches ou une représentation plus compacte. La documentation de scikit-learn présente plusieurs tâches de ce type, dont le regroupement et la réduction des dimensions.
Reprenons les informations d’entrée avec une autre question : « Quelles observations se ressemblent selon leurs heures d’étude et leur taux de présence ? » Pour cette analyse, X contient Hours_Studied et Attendance. Aucune colonne cible n’est fournie pour guider la constitution des groupes.
Le regroupement, ou clustering, rassemble des observations selon un critère de similarité. Les groupes sont produits par la méthode ; leurs noms et leur interprétation ne sont pas donnés comme réponses au départ. Dire qu’un groupe est composé de « bons élèves » sur la seule base des heures d’étude et de la présence ajouterait un jugement que l’analyse ne démontre pas.
La réduction des dimensions cherche, quant à elle, à représenter les données avec moins de variables, tout en conservant autant d’information utile que possible. Certaines méthodes construisent de nouvelles variables à partir des variables initiales. Ce type de méthode peut faciliter l’exploration ou la visualisation ; il ne fournit pas nécessairement de groupes. L’apprentissage non supervisé dépasse donc le simple regroupement.
Comparer apprentissage supervisé et non supervisé
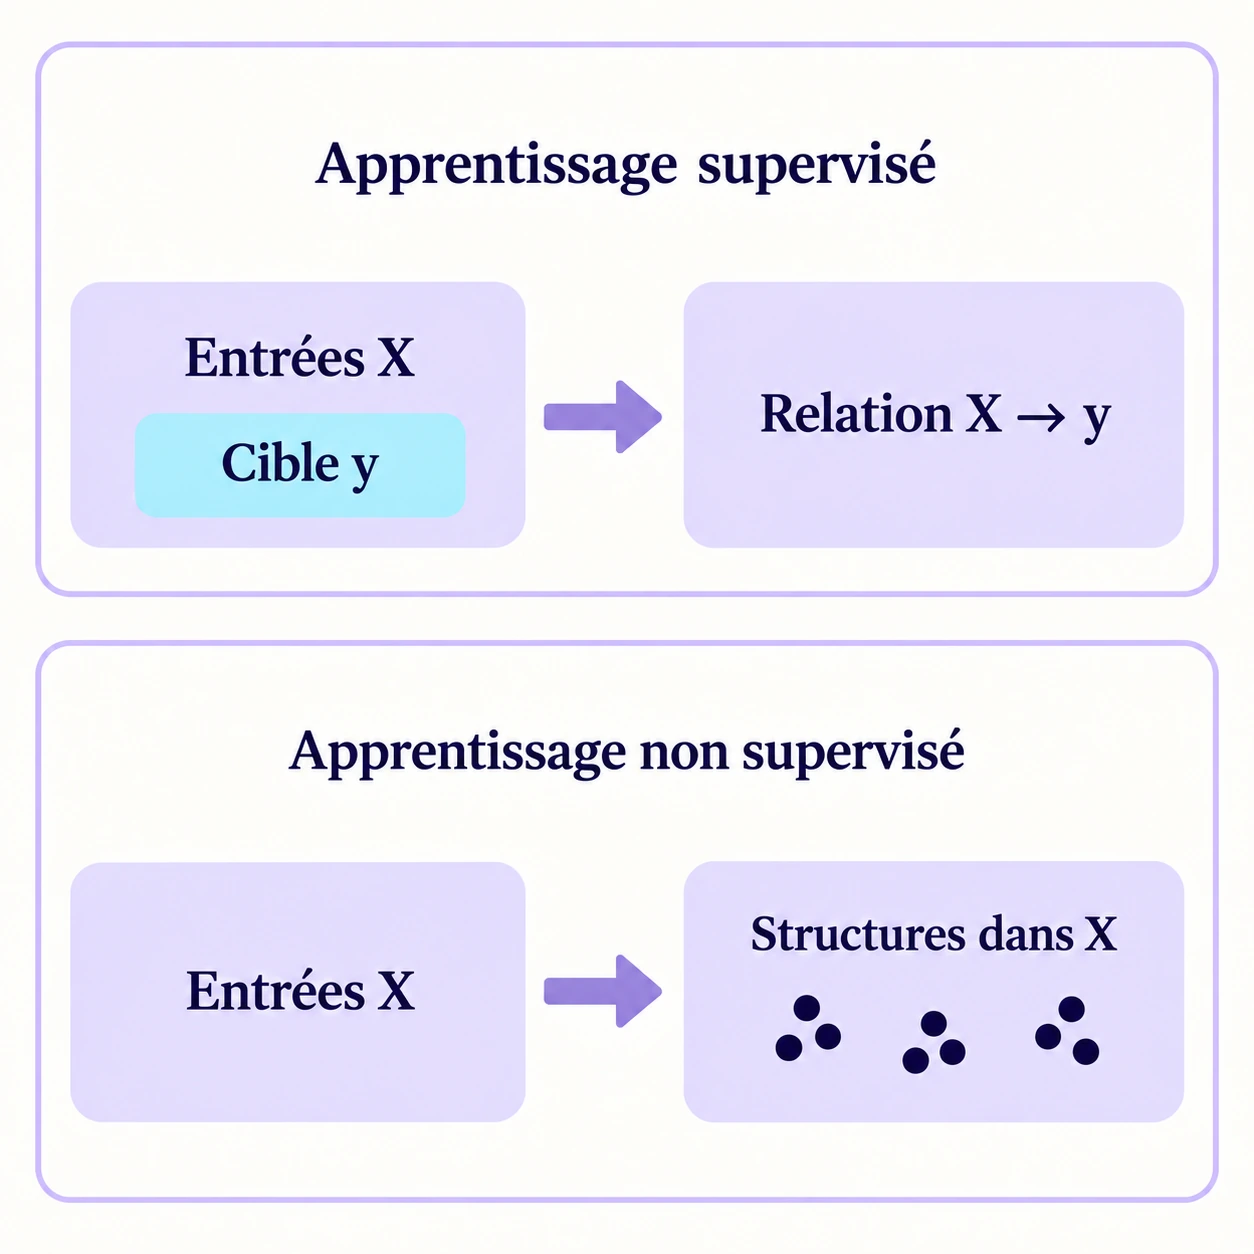
| Supervisé | Non supervisé |
|---|---|
| Question. Quelle réponse prédire à partir des entrées ? | Question. Quelle organisation rechercher dans les entrées ? |
| Cible. Réponse connue associée aux exemples d’entraînement. | Cible. Aucune cible fournie pour guider cette analyse. |
| Exemple. Estimer la note finale à partir d’informations disponibles avant l’examen. | Exemple. Regrouper selon les heures d’étude et la présence. |
| Vérification. Comparer les prédictions aux cibles d’observations non utilisées pour apprendre. | Vérification. Examiner la cohérence, la séparation et la stabilité des structures obtenues, selon la tâche. |
Un regroupement peut être évalué même sans catégories de référence : on peut examiner la proximité des observations d’un même groupe, la séparation entre groupes ou la stabilité lorsque les données et les réglages varient. Des catégories connues peuvent aussi servir de comparaison après le regroupement, sans avoir guidé sa construction. La documentation sur l’évaluation des regroupements distingue ces situations. Un indicateur favorable ne prouve toutefois pas que les groupes correspondent à des catégories scolaires utiles.
Choisir le cadre à partir de votre question
Commencez par formuler la sortie attendue, avant de choisir un algorithme. Les recommandations de Google sur le cadrage d’un problème insistent notamment sur la cible et sur les données disponibles au moment de prédire.
- Définissez le résultat recherché. Voulez-vous une note estimée, une catégorie déterminée à l’avance ou une organisation des observations ?
- Vérifiez les réponses disponibles. Pour apprendre à prédire la note finale, il faut des exemples accompagnés de cette note. Un objectif de prédiction sans réponses exploitables ne devient pas automatiquement un projet de regroupement.
- Sélectionnez les entrées utilisables. Pour une prédiction avant l’examen, retenez des informations réellement disponibles avant cet examen.
- Prévoyez la vérification. Décidez comment vous examinerez les erreurs de prédiction ou l’utilité des structures obtenues. La méthode devra être jugée sur la question qu’elle est censée résoudre.
Si seules certaines observations possèdent une cible, d’autres cadres existent, comme l’apprentissage semi-supervisé, qui utilise des exemples avec et sans réponse connue.
Exercice : reconnaître le rôle de la cible
Pour chaque situation, indiquez le cadre d’apprentissage, les entrées et le rôle de Exam_Score. Justifiez votre réponse en une phrase.
- Vous utilisez les heures d’étude, la présence et les notes précédentes pour apprendre à estimer la note finale, connue dans les exemples d’entraînement.
- Vous rassemblez les observations selon leurs heures d’étude et leur présence, sans fournir leurs notes finales à la méthode de regroupement.
- Un modèle entraîné avec les notes finales reçoit les entrées d’une nouvelle observation dont la note finale n’est pas encore connue.
- Après avoir constitué les groupes de la deuxième situation, vous consultez les notes finales pour mieux décrire chaque groupe.
Voir la correction expliquée
- Apprentissage supervisé. X contient les heures d’étude, la présence et les notes précédentes ; y correspond à
Exam_Score. La réponse connue guide l’apprentissage. La cible est numérique : il s’agit d’une régression. - Apprentissage non supervisé. X contient les heures d’étude et la présence.
Exam_Scoren’intervient pas dans la construction des groupes ; aucune catégorie attendue n’est fournie. - Prédiction par un modèle supervisé. Les entrées ont la même définition qu’à l’entraînement, et la note finale est la valeur à estimer. Son absence pour cette nouvelle observation ne change pas le cadre dans lequel le modèle a appris.
- Description après un regroupement non supervisé. Les notes finales apportent une information supplémentaire pour interpréter les groupes déjà constitués. Si vous utilisez ensuite ces notes pour choisir ou modifier le regroupement, elles commencent à guider vos choix ; il faut expliciter cette nouvelle démarche.
Les erreurs fréquentes autour de la cible
Laisser la cible ou une information qui la révèle dans les entrées
Dans le jeu de régression, fournir Exam_Score parmi les entrées pour prédire cette même note donne déjà la réponse au modèle. Dans le jeu de classification, le même problème apparaît si Result est fourni pour prédire Result. La cible de chaque tâche doit rester hors de X : elle est inconnue au moment prévu de la prédiction. C’est une fuite de données. Voir documentation de scikit-learn sur les fuites de données.
La vérification concerne aussi les colonnes dérivées de la cible et les informations recueillies après l’examen. Séparer X et y exige donc de comprendre les champs, pas seulement de retirer une colonne portant un nom particulier.
Déduire le cadre du contenu du fichier
Un tableau contenant des notes peut servir à une analyse non supervisée si ces notes ne guident pas l’analyse. À l’inverse, des catégories déjà connues ne servent pas nécessairement d’entrées : elles peuvent devenir la cible d’une classification. Le rôle des colonnes découle de la question et de leur usage.
Confondre les groupes découverts et les classes définies
Dans le jeu de classification, les catégories Success et Fail sont déjà renseignées dans Result. Les groupes formés selon les heures d’étude et la présence proviennent, eux, d’une méthode de regroupement. Leur attribuer ensuite des noms ne les transforme pas rétroactivement en réponses fournies à l’entraînement.
À retenir et prochaine étape du projet
L’apprentissage supervisé exploite des réponses connues pour apprendre à prédire une cible. L’apprentissage non supervisé recherche des structures sans cible fournie pour guider cette analyse. Les mêmes données peuvent servir aux deux cadres ; la question posée et le rôle des colonnes permettent de les distinguer.
Sources et ressources pour approfondir
- Aurélien Géron, Hands-On Machine Learning with Scikit-Learn and PyTorch, O’Reilly, première édition, première version du 22 octobre 2025. Chapitre 1, « Training Supervision », p. 10–16, et « Testing and Validating », p. 35–37 ; chapitre 2, notations des entrées et de la cible, p. 45–46, et mise à l’échelle, p. 77–78 ; chapitre 8, évaluation et limites du regroupement, p. 256–259. Ressources officielles de l’auteur.
- Google — Qu’est-ce que le machine learning ? : présentation des cadres d’apprentissage, de la régression et de la classification.
- scikit-learn — définition de la cible, puis apprentissage supervisé et apprentissage non supervisé : terminologie et panorama des méthodes.
- Google — Définir une problématique liée au ML : préciser la sortie attendue et les données utilisables.
- scikit-learn — évaluer un regroupement et éviter les fuites de données : approfondissements techniques après les notions de cette leçon.
- Student Performance Factors — Lai Ng., Kaggle : source des données. Les noms, unités et valeurs utilisés ici ont été vérifiés le 14 octobre 2026 dans les feuilles « Données » et « Description des champs » de StudentPerformanceFactors.xlsx.
