IA, machine learning, deep learning et IA générative : les bases
L’intelligence artificielle (IA) est le domaine général. Le machine learning apprend à partir de données ; le deep learning est une famille de ces méthodes. L’IA générative désigne la production de contenu, comme un texte ou une image. Pour comprendre leurs différences, nous allons suivre un même problème : estimer une note d’examen à partir d’informations disponibles avant de connaître cette note.
Nous commencerons par ce que le logiciel doit faire, puis nous verrons comment il apprend et comment vérifier sa réponse. Vous pourrez ensuite situer le deep learning et comprendre le rôle d’un assistant génératif dans une application. Aucun code n’est nécessaire pour cette première leçon.
Sommaire
1. IA et machine learning : partir d’un problème concret
L’intelligence artificielle regroupe des approches qui permettent à des systèmes d’effectuer notamment des tâches de reconnaissance, de raisonnement, de prévision ou de production de contenu. L’OCDE précise le fonctionnement d’un système d’IA : à partir d’entrées et d’objectifs, il déduit comment produire des sorties, telles que des prédictions ou des recommandations. L’IA peut s’appuyer sur des connaissances organisées par des personnes ou sur un apprentissage à partir de données.
Dans notre exemple, nous connaissons les heures d’étude, le taux de présence en cours et les notes précédentes. Nous cherchons à estimer la note finale avant qu’elle soit connue. Estimer signifie ici fournir une valeur approchée : le logiciel ne peut pas connaître le résultat avec certitude.
Une règle s’écrit ; un modèle s’apprend
Si vous demandez « Signalez les lignes où la présence est inférieure à 80 % », vous avez déjà donné le critère. Le logiciel applique une règle explicite. Dans les deux premières lignes du fichier, la présence vaut 84 % puis 64 % : seule la seconde est signalée. Le seuil de 80 % est choisi pour cet exemple.
Pour estimer une note, la relation est moins évidente. Comment combiner les heures d’étude, la présence et les notes précédentes ? Le machine learning, ou apprentissage automatique, consiste à construire une relation à partir d’exemples. Cette relation est portée par un modèle, une représentation mathématique qui transforme des informations d’entrée en une réponse. Voir l’introduction de Google au machine learning.
La personne choisit le problème, les données et la méthode. La procédure d’apprentissage ajuste le modèle à partir des exemples. Nous allons détailler cet ajustement dans la section 3 ; pour l’instant, retenez que la relation utilisée pour estimer la note vient des données.
La figure 1 compare l’origine de la logique dans ces deux démarches. Leurs objectifs diffèrent : signaler une faible présence et estimer une note ne sont pas deux réponses interchangeables au même problème.
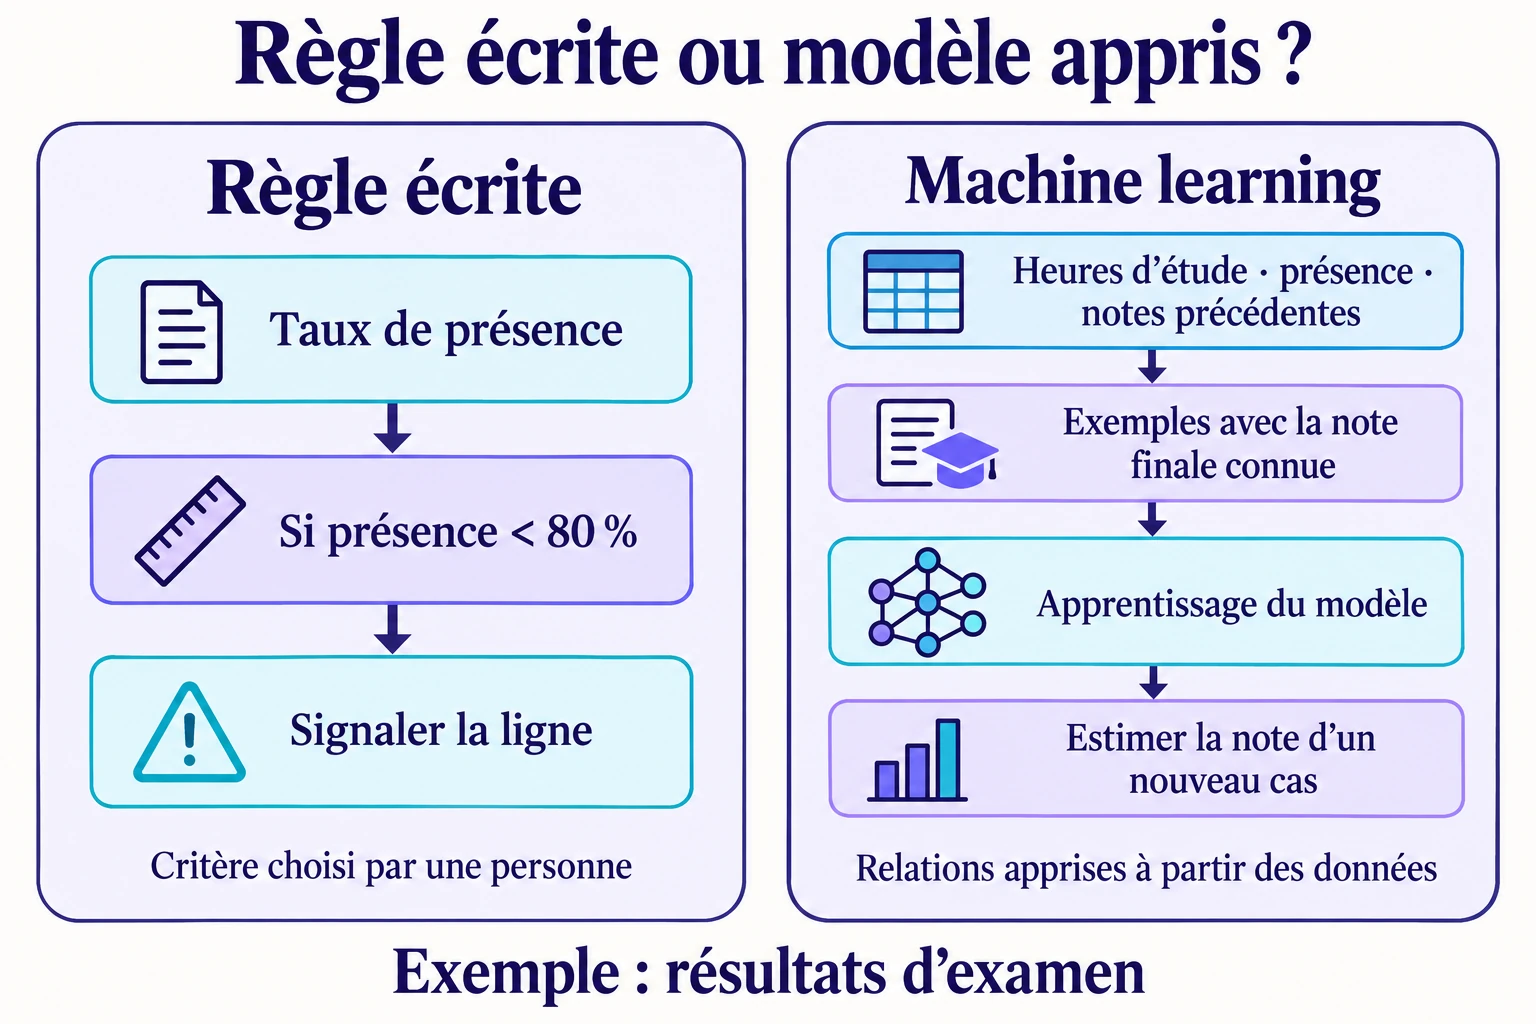
Une application peut réunir les deux : une règle vérifie que le pourcentage saisi est compris entre 0 et 100, puis le modèle utilise les informations valides pour estimer la note. Un calcul automatisé, comme la moyenne d’une colonne, ne suffit donc pas à caractériser un système d’IA.
2. Régression ou classification : préciser la réponse recherchée
Avant d’apprendre une relation, il faut préciser ce que le modèle reçoit et ce qu’il doit produire. Une variable d’entrée est une information fournie au modèle. La cible est ce que l’on cherche à prévoir. Dans notre premier exemple, les trois entrées sont les heures d’étude, la présence et les notes précédentes ; la cible est la note finale.
| Colonne et signification | Valeur connue | Rôle |
|---|---|---|
Hours_StudiedHeures d’étude par semaine | 23 heures | Entrée |
AttendancePourcentage de cours suivis | 84 % | Entrée |
Previous_ScoresNotes aux examens précédents | 73 points | Entrée |
Exam_ScoreNote à l’examen final | 67 points | Cible |
Les 67 points sont une valeur du fichier. Pendant l’apprentissage, cette réponse connue permet de vérifier ce que le modèle estime. Quand nous utiliserons le modèle sur une nouvelle situation, nous lui fournirons seulement les entrées : la note finale sera précisément la réponse recherchée. Si vous souhaitez consulter la source de ces exemples, le classeur du parcours est disponible.
Estimer une note : la régression
Une régression estime une quantité numérique. Notre question est : « Quelle note finale peut-on prévoir ? » La réponse attendue est une note en points. Pour juger sa qualité, nous comparerons les notes estimées aux notes effectivement présentes dans des exemples réservés à l’évaluation.
Prévoir une catégorie : la classification
Une classification prévoit l’appartenance à une catégorie définie à l’avance. Dans notre jeu de classification, la cible est Result, déjà renseignée avec Success (réussite) ou Fail (échec). Le modèle apprend à prévoir cette catégorie à partir des entrées. Ce jeu est distinct du jeu de régression, dont la cible est une note.
Voici deux observations du jeu de classification. Pour la première, les heures d’étude valent 23, la présence 84 % et les notes précédentes 73 ; Result est renseigné avec Success. Pour une autre observation, ces entrées valent 13, 69 % et 68 ; Result contient Fail. Le modèle apprend à prévoir ces étiquettes déjà fournies à partir des trois entrées.
La figure 2 compare deux tâches séparées : estimer une note en régression et prévoir la catégorie Result en classification. Les étiquettes Success et Fail sont déjà présentes dans les exemples d’apprentissage. Elles sont inconnues pour les nouveaux cas à prédire ; la cible ne fait donc pas partie des entrées du modèle.
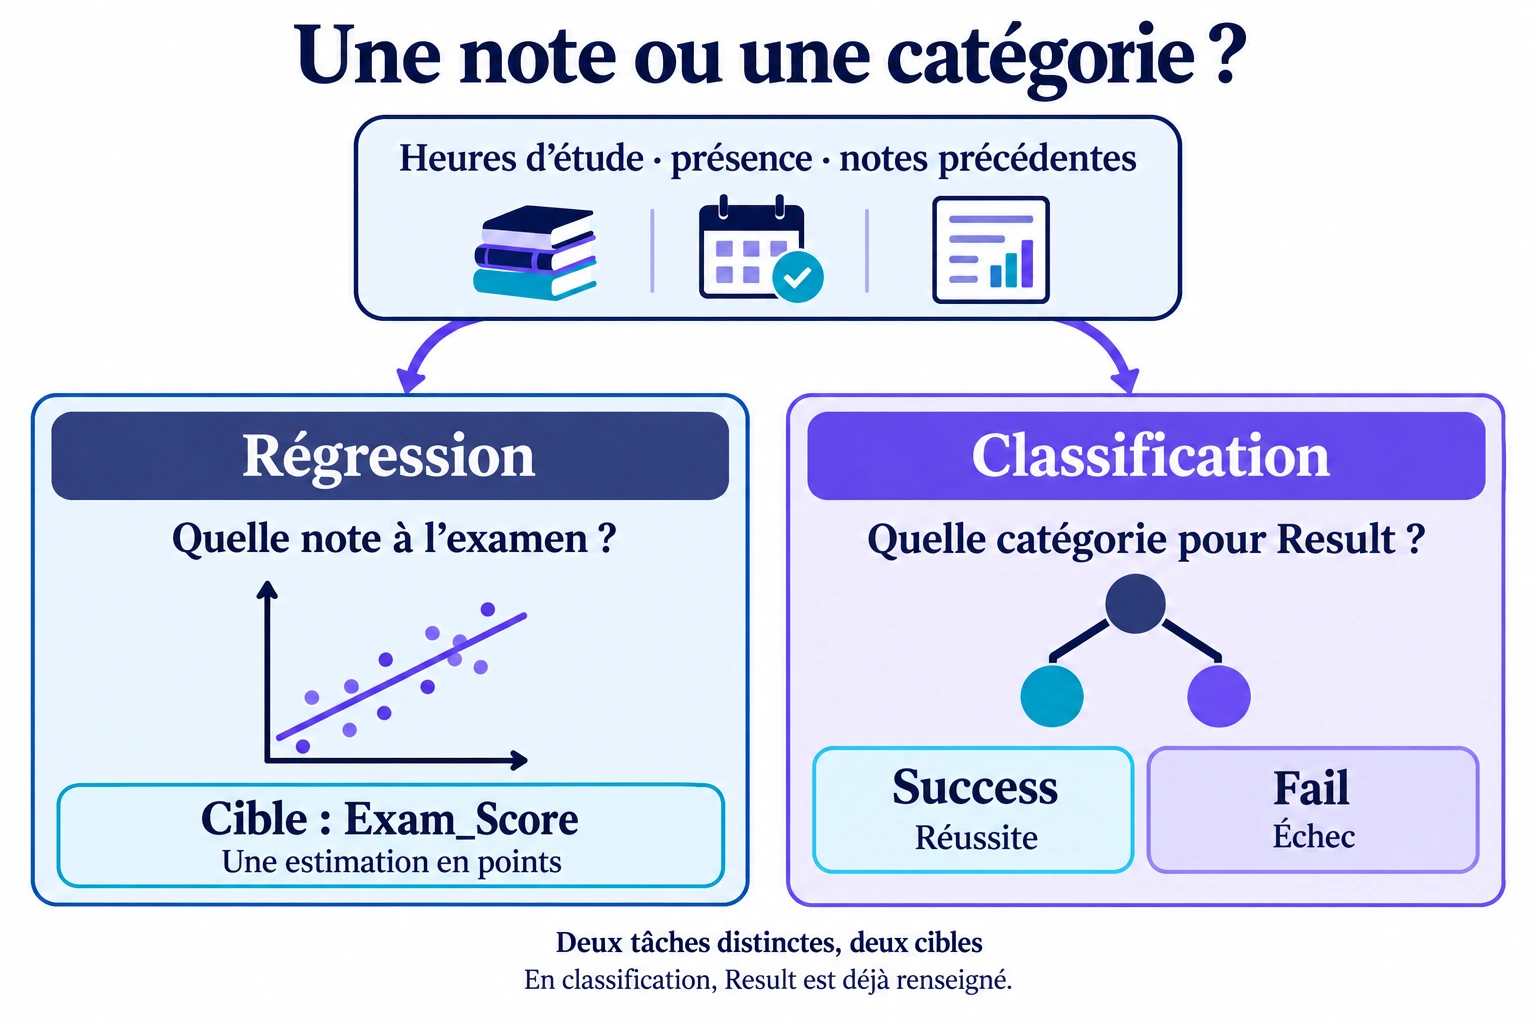
Une classification à deux catégories est dite binaire. Un modèle peut aussi estimer une probabilité avant d’attribuer une catégorie ; nous reviendrons sur cette nuance dans les compléments. Pour la suite de la leçon, gardons notre premier objectif : estimer une note.
3. Comment un modèle apprend, puis s’utilise
Nos exemples contiennent les entrées et la réponse connue. C’est l’apprentissage supervisé : la réponse sert de référence pendant l’apprentissage. « Supervisé » décrit donc les exemples disponibles ; « régression » décrit la réponse que nous voulons produire. Un même modèle peut accomplir une régression en apprenant de manière supervisée.
Entraîner : ajuster la relation à partir des exemples
Imaginons un modèle qui combine nos trois entrées avec des coefficients. Ces coefficients sont des paramètres : des valeurs qui déterminent comment le modèle calcule sa réponse. L’entraînement consiste à les ajuster en utilisant les exemples et leurs notes finales connues.
La procédure calcule des estimations, les compare aux réponses connues, puis modifie les paramètres pour réduire une mesure des écarts. Cette mesure est appelée fonction de perte. Un algorithme d’apprentissage est la procédure de calcul qui organise cet ajustement ; le modèle entraîné est le résultat obtenu. Le glossaire de Google précise ce vocabulaire.
Avec une régression linéaire, la réponse est construite à partir d’une somme pondérée des entrées, à laquelle s’ajoute une constante. « Pondérée » signifie que chaque entrée est multipliée par un coefficient. Avec une seule entrée, cette relation correspond à une droite ; avec plusieurs entrées, elle combine leurs contributions. Cette méthode est une possibilité, pas la définition de toute régression. Voir la présentation de la régression linéaire.
Évaluer : vérifier sur des exemples qui n’ont pas servi à apprendre
Retrouver les notes des exemples d’entraînement ne suffit pas. Nous réservons d’autres lignes, avec leurs réponses, pour mesurer les erreurs du modèle. Nous lui donnons leurs entrées, puis nous comparons ses estimations aux notes connues. C’est l’évaluation.
Nous cherchons à généraliser : obtenir des estimations utiles sur des situations absentes de l’entraînement. Si le modèle s’adapte trop aux particularités de ses exemples et fonctionne mal sur les autres, il y a surapprentissage. La leçon de Google sur la généralisation approfondit cette difficulté.
Il faut aussi un point de comparaison. Une référence simple pourrait toujours annoncer la note médiane des exemples d’entraînement. La médiane est la valeur qui partage leurs notes ordonnées en deux moitiés. Un modèle plus élaboré doit apporter un gain mesuré par rapport à cette référence, sur les mêmes cas d’évaluation.
Prédire : appliquer le modèle entraîné à un nouveau cas
Nous pouvons ensuite fournir les heures d’étude, la présence et les notes précédentes d’un cas dont la note finale n’est pas connue. Le modèle utilise ses paramètres appris pour produire une estimation. C’est la prédiction, également appelée inférence.
Dans ce contexte, « prédire » signifie estimer une réponse inconnue ; il ne s’agit pas nécessairement d’un événement futur. Cette utilisation ne déclenche pas automatiquement un nouvel apprentissage. Une application peut traiter de nombreuses demandes avec le même modèle entraîné.
Entrées et notes connues : ajuster le modèle.
Exemples réservés : mesurer les erreurs.
Nouvelles entrées : estimer une note inconnue.
Une estimation reste incertaine, même après une évaluation satisfaisante. Une association entre heures d’étude et note finale ne prouve pas non plus qu’ajouter une heure d’étude causerait une hausse donnée. Prévoir une valeur et démontrer une cause sont deux objectifs différents.
4. Deep learning : une famille de méthodes de machine learning
Nous avons défini la tâche et les trois moments de la vie du modèle. Nous pouvons maintenant choisir une méthode. Le deep learning, ou apprentissage profond, utilise des réseaux de neurones comportant plusieurs couches de traitement. Il appartient au machine learning : les paramètres s’apprennent eux aussi à partir de données.
Un réseau de neurones artificiels est un modèle composé d’unités de calcul reliées entre elles. Une couche regroupe des unités qui transforment les valeurs reçues et transmettent leurs résultats à la couche suivante. Les paramètres du réseau, souvent appelés poids, déterminent ces transformations. Le terme « neurone » désigne ici une unité mathématique, pas un neurone biologique.
Pour estimer notre note, les valeurs d’entrée passent par plusieurs transformations successives avant d’atteindre la sortie. Les couches intermédiaires apprennent des combinaisons numériques utiles à la tâche. Ces façons de coder l’information sont des représentations apprises. Elles ne correspondent pas nécessairement à des notions humaines comme « effort » ou « motivation ». Le principe est développé par LeCun, Bengio et Hinton (2015) et dans le cours de Google sur les réseaux de neurones.
La tâche reste une régression si la sortie est une note. Remplacer une régression linéaire par un réseau profond change la méthode, pas la question. De même, un réseau profond peut réaliser une classification s’il prévoit une catégorie.
Le deep learning sert aussi à traiter des images, du texte et du son. Pour notre tableau, sa complexité ne garantit pas de meilleures estimations : il faudra comparer les méthodes sur les mêmes exemples réservés, puis tenir compte des erreurs, de la rapidité et des ressources nécessaires.
5. IA générative : produire du contenu
L’IA générative produit du contenu à partir de régularités apprises dans des données. Elle peut générer du texte, des images ou du son. Ce terme décrit ce que le système produit ; il ne désigne pas une méthode unique. Les grands modèles génératifs actuels s’appuient notamment sur le deep learning.
Changeons maintenant le besoin : nous voulons expliquer les colonnes à la personne qui utilise l’application. Nous pouvons fournir la description des champs et une consigne : « Expliquez la différence entre heures d’étude et taux de présence. » Cette consigne est souvent appelée prompt.
Un grand modèle de langage, ou LLM, est un modèle entraîné sur de grandes quantités de texte pour traiter et produire du langage. Il pourrait rédiger l’explication à partir des définitions fournies. Nous utiliserions alors un modèle déjà entraîné ; nous n’entraînerions pas un grand modèle de langage à partir de nos 6 607 lignes.
| Fonction | Entrée | Sortie attendue |
|---|---|---|
| Estimer la note | Heures d’étude, présence, notes précédentes | Une note en points : régression |
| Expliquer les champs | Descriptions des colonnes et consigne | Un texte : génération |
Une réponse bien rédigée peut contenir une affirmation fausse ou une source inventée : on parle souvent d’hallucination. Nous devons donc vérifier le texte dans le document d’origine. Si l’assistant explique une note estimée, il ne doit pas lui attribuer des causes que le modèle n’a pas démontrées. Voir la présentation des modèles de langage.
Situer les quatre notions après les exemples
La figure 3 reprend maintenant les termes rencontrés. Le machine learning appartient à l’IA ; le deep learning appartient au machine learning. L’IA générative désigne une capacité de production : une partie des modèles profonds est générative, et d’autres modèles génératifs existent sans réseau profond.
Le domaine : reconnaître, raisonner, planifier, produire…
Une approche : apprendre des relations à partir d’exemples (des données).
Une famille de modèles : des réseaux de neurones à plusieurs couches.
Créer du texte, des images, du son… C’est ici que se situent les grands modèles de langage génératifs et les modèles de diffusion courants.
Le deep learning a aussi des usages non génératifs, comme estimer une note à partir d’un tableau.
Des modèles peuvent aussi apprendre à générer des exemples sans utiliser de réseau de neurones profond.
Un réseau profond qui estime une note relève donc du deep learning et réalise une régression. Un grand modèle de langage génératif relève du deep learning et produit du texte. « Deep learning » et « génératif » répondent à deux questions différentes : quelle méthode est utilisée, et quelle sortie est produite ?
6. Du modèle à une application web
Le modèle est une composante de l’application. La figure 4 présente le workflow, c’est-à-dire l’enchaînement du travail nécessaire pour passer d’un besoin à un outil utilisable. L’entraînement et l’évaluation que nous avons expliqués occupent deux étapes de cet ensemble.
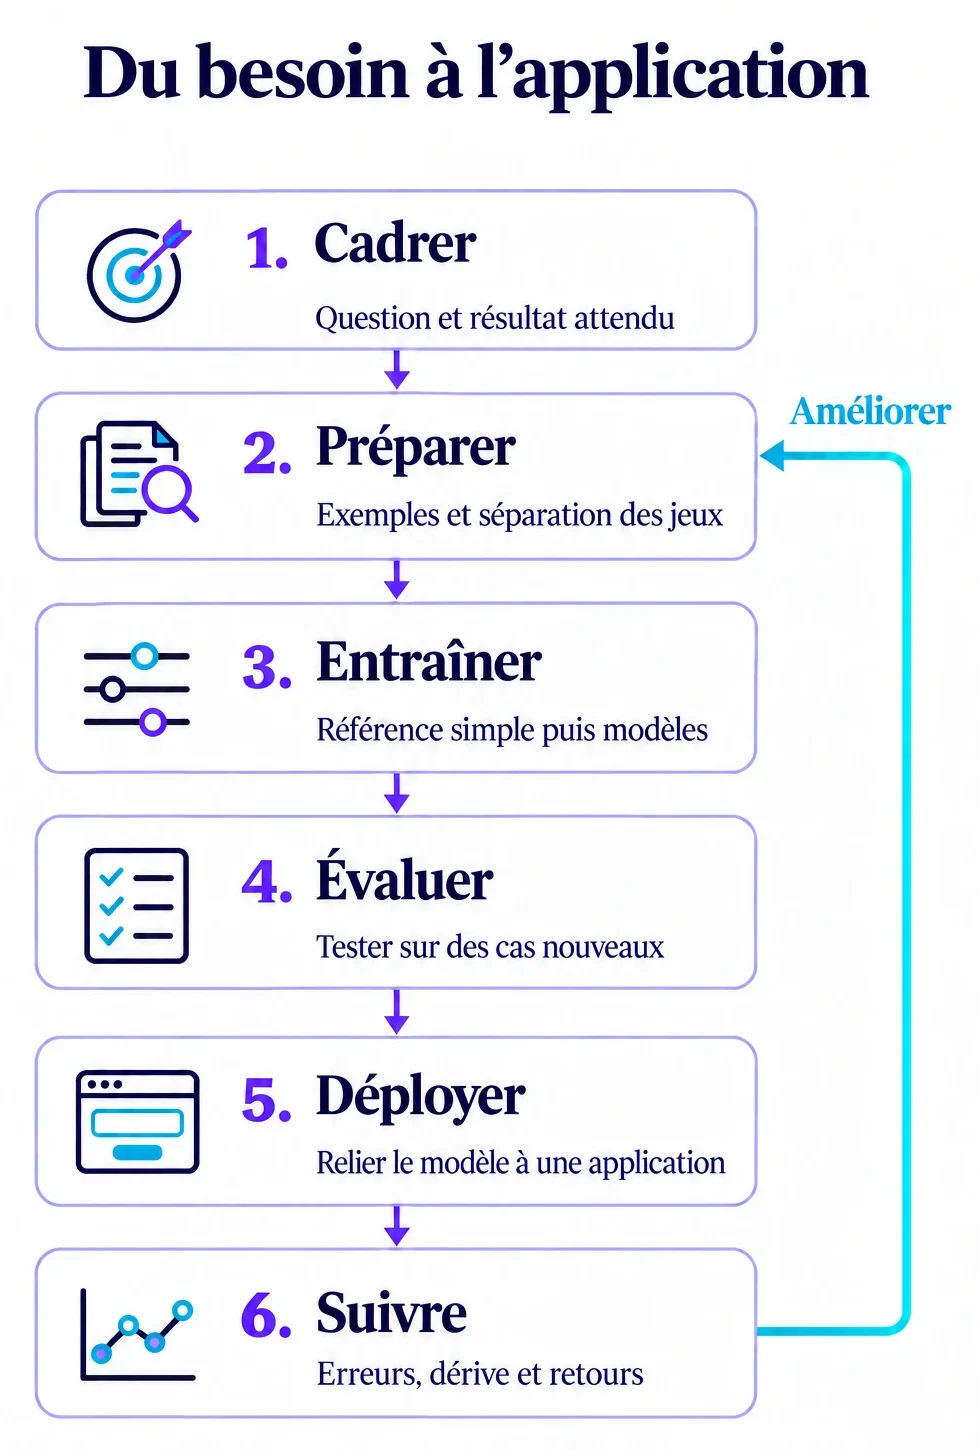
- Cadrer. Définir la sortie recherchée, les informations connues au moment de la demande et les erreurs acceptables. Ici : une note estimée à partir de trois entrées.
- Préparer. Vérifier les définitions, les unités et la qualité des données. Séparer les exemples avant d’ajuster les transformations et le modèle.
- Entraîner. Construire une référence simple, puis apprendre les paramètres des modèles à comparer.
- Évaluer. Mesurer les erreurs sur des cas réservés. Examiner aussi les gros écarts et les situations moins bien représentées.
- Déployer. Mettre le modèle à disposition de l’application, avec les transformations nécessaires pour préparer ses entrées.
- Suivre. Contrôler le fonctionnement et, lorsque les vraies notes deviennent disponibles, l’évolution des erreurs. Un changement de population ou de contexte peut rendre les anciennes relations moins pertinentes : c’est une forme de dérive.
Une fois le modèle disponible, chaque demande suit un circuit plus court : l’utilisateur saisit les informations, l’application les vérifie, le modèle estime la note et l’écran affiche le résultat. Ce circuit utilise le modèle ; il ne recommence pas les six étapes du projet à chaque clic.
Saisir les heures d’étude, la présence et les notes précédentes.
Vérifier les valeurs, les préparer et appliquer le modèle.
Présenter la note estimée et ses limites.
L’interface peut communiquer avec un service par une API, une interface d’échange entre logiciels. L’application doit aussi gérer les saisies invalides, les délais et les indisponibilités. La documentation de Google sur les systèmes de machine learning en production décrit ce travail autour du modèle.
Notre application de parcours servira à comprendre cette démarche. Le classeur ne suffit pas à valider son usage pour prendre des décisions sur des personnes. Si nous ajoutons un assistant génératif, nous devrons également vérifier la fidélité de ses explications aux documents fournis.
7. Vérifiez votre compréhension
Répondez d’abord avec vos propres mots, puis ouvrez la correction. Les cinq situations reprennent les distinctions qui permettent de lire la suite du parcours.
1. Signaler une présence inférieure à 80 % : faut-il apprendre un modèle ?
Une règle suffit : le critère est déjà connu. Elle signalera notamment la présence de 64 % de la deuxième ligne. Elle ne prédit pas la note finale. L’apprentissage devient une autre démarche lorsque nous cherchons à estimer cette note à partir d’exemples.
2. Les 67 points de la première ligne sont-ils une prédiction ?
Non : c’est la note connue dans le fichier. Elle sert de réponse de référence pendant l’apprentissage ou l’évaluation, selon l’ensemble auquel appartient cette ligne. Une prédiction serait une valeur calculée par un modèle ; aucun résultat de modèle n’est présenté ici.
3. Un réseau profond apprend avec les notes connues et estime une note : comment décrire ce travail ?
La tâche est une régression, car la sortie est une quantité. L’apprentissage est supervisé, car les exemples contiennent les réponses. La méthode relève du deep learning, car elle utilise un réseau profond. Ces descriptions se complètent ; il n’est pas nécessaire d’en choisir une seule.
4. Le modèle retrouve les notes d’entraînement : cela prouve-t-il sa fiabilité ?
Non. Il faut mesurer ses erreurs sur des cas réservés, vérifier que la réponse n’est pas cachée dans les entrées et comparer les résultats à une référence simple. Il faut ensuite tester le circuit de l’application, notamment les saisies et l’affichage.
5. L’assistant rédige une explication des colonnes : estime-t-il aussi la note ?
Rédiger cette explication relève de la génération de texte. Estimer la note est une autre fonction, que nous confierions au modèle de régression évalué. Le texte doit rester fidèle aux descriptions et ne pas inventer une cause aux résultats.
8. À retenir et prochaine étape
Pour comprendre un système, partez de sa question, de ses entrées et de sa sortie. Vous pouvez alors décrire la tâche, le mode d’apprentissage et la méthode utilisée.
- IA : le domaine général. Machine learning : apprendre une relation à partir de données.
- Régression : estimer une quantité. Classification : prévoir une catégorie. Supervisé : apprendre avec des réponses connues.
- Deep learning : une famille de méthodes de machine learning. IA générative : produire du contenu, souvent avec ces méthodes.
- Entraîner, évaluer, prédire : ajuster le modèle, mesurer ses erreurs sur des cas réservés, puis l’appliquer à une nouvelle situation.
9. Compléments et ressources pour approfondir
La rubrique Comprendre l’IA prolonge cette introduction avec les types d’apprentissage, les métriques d’évaluation selon la tâche et les limites des modèles. Ses sujets suivent un ordre de lecture et les articles disponibles sont indiqués. Les compléments ci-dessous restent utiles lorsque vous rencontrez ces notions.
Pourquoi distinguer entraînement, validation et test ?
L’entraînement ajuste les paramètres. La validation permet de comparer les réglages ou les modèles pendant le développement. Le test sert à l’évaluation finale, une fois les choix fixés. Réutiliser sans cesse les résultats du test pour choisir le modèle ferait perdre à cet ensemble son rôle d’évaluation indépendante. Les transformations apprises sur les données se règlent elles aussi sans utiliser les réponses du test. Voir les ensembles d’entraînement, de validation et de test.
Classification : pourquoi peut-on obtenir une probabilité ?
Un modèle peut estimer la probabilité de la catégorie Success, puis lui appliquer un seuil de décision. Ce seuil porte sur une probabilité ; les catégories de Result sont déjà renseignées dans les données d’apprentissage. Le modèle ne construit pas ces étiquettes. La calibration consiste à vérifier si les probabilités annoncées correspondent aux fréquences observées sur de nombreux cas. Une sortie numérique n’en fait donc pas automatiquement une régression. Voir les seuils de classification et la calibration.
Quelles autres tâches et quels autres modes d’apprentissage existent ?
Le regroupement, ou clustering, cherche des ressemblances sans recevoir de catégories à prévoir. On pourrait regrouper les lignes selon les heures d’étude, la présence et le sommeil. C’est un exemple d’apprentissage non supervisé : on cherche une structure sans réponses cibles fournies. Ces groupes doivent ensuite être interprétés. Voir la documentation sur le regroupement.
La détection d’anomalies repère l’inhabituel. La valeur 101 de Exam_Score, présente dans le fichier, invite à vérifier l’échelle et la source ; elle ne doit pas être supprimée automatiquement. Une règle peut suffire à la signaler, tandis qu’un modèle peut chercher des combinaisons inhabituelles. Voir la détection d’anomalies.
La recommandation propose des éléments jugés pertinents. Recommander une ressource d’étude demanderait des informations sur les ressources et leurs usages, absentes de ce tableau. L’apprentissage par renforcement apprend une stratégie d’action à partir de retours et de récompenses. Le nombre de séances de tutorat ne décrit pas une succession d’actions et de retours : le classeur seul ne permet pas cette démonstration. Ces notions répondent à des questions distinctes ; le renforcement est un mode d’apprentissage. Voir les modes d’apprentissage.
Que montre un graphique des heures d’étude et des notes ?
La figure 5 présente les 100 premières lignes du classeur. Chaque point turquoise associe des heures d’étude à une note connue.
Comment lire la droite rouge ? C’est une droite de régression linéaire : pour un nombre d’heures donné, sa hauteur indique la note estimée par un modèle qui utilise uniquement les heures d’étude. Elle est ajustée sur les 100 points affichés en minimisant la somme des carrés des écarts verticaux entre les notes observées et la droite, selon la méthode des moindres carrés décrite par le NIST.
Sa légère pente ascendante résume la tendance dans cet extrait. Les points au-dessus ou au-dessous montrent que les notes réelles diffèrent de cette estimation. Cette relation ne prouve pas qu’étudier davantage cause une hausse de la note ; la fiabilité du modèle sur de nouveaux cas reste à évaluer.
Comment un modèle de langage produit-il du texte ?
Il traite le texte en unités appelées tokens : mots, morceaux de mots ou caractères selon le système. Un mécanisme courant consiste à apprendre à prévoir le token suivant à partir du texte précédent. La réponse d’apprentissage est alors tirée du texte lui-même : c’est l’apprentissage autosupervisé. Pendant la génération, le modèle produit progressivement une suite de tokens. Ces mécanismes expliquent une partie de ses capacités, sans garantir la vérité du texte obtenu. Voir le cours sur les grands modèles de langage.
Des usages récents à comprendre après les bases
Multimodalité, RAG, agents et modèles locaux : repères au 8 octobre 2026
Multimodalité. Un modèle traite plusieurs types d’informations, par exemple du texte et une image. Une interface pourrait accepter une capture du tableau et une question sur une colonne. Les calculs fiables doivent cependant repartir des cellules. La documentation de Gemma présente des capacités qui varient selon les modèles.
RAG. La génération augmentée par la recherche retrouve des passages dans des documents et les fournit au modèle pour préparer une réponse. Un assistant pourrait rechercher la définition d’une colonne dans le dictionnaire du classeur. Cela apporte du contexte à la réponse sans nécessairement réentraîner le modèle, et sans supprimer toutes les erreurs. Voir l’explication de Google Cloud.
Agents. Un assistant peut choisir des étapes et utiliser des outils pour poursuivre un objectif, par exemple consulter une définition puis faire compter les cellules vides par un outil de calcul. Il faut vérifier les résultats et les accès. Ce fonctionnement n’est pas, à lui seul, une démonstration d’apprentissage par renforcement. Voir la distinction entre workflows et agents chez Anthropic.
Modèles locaux. Certaines tailles de modèles permettent une exécution sur un ordinateur compatible. Un tel modèle pourrait expliquer les descriptions des colonnes. Les besoins en mémoire et les capacités varient ; les autres composants de l’application peuvent encore transmettre des données. Voir les caractéristiques de Gemma.
Sources et ordre de lecture conseillé
- Pour consolider les bases : l’introduction au machine learning, puis les chapitres utiles du Machine Learning Crash Course de Google. Le glossaire sert à retrouver un terme au moment où vous en avez besoin.
- Pour organiser un projet : formuler le problème et conduire un projet de machine learning.
- Pour les définitions de référence : OCDE (2024), Explanatory memorandum on the updated OECD definition of an AI system, OECD Artificial Intelligence Papers, n° 8, DOI : 10.1787/623da898-en ; LeCun, Y., Bengio, Y. et Hinton, G. (2015), Deep learning, Nature, 521, p. 436–444, DOI : 10.1038/nature14539.
- Pour les données de cette leçon : Student Performance Factors — Lai Ng., Kaggle. Les valeurs présentées ont été vérifiées dans les feuilles « Données » et « Description des champs » de StudentPerformanceFactors.xlsx le 8 octobre 2026.
