Types, mutabilité et copies en Python : éviter les modifications involontaires
La mutabilité en Python explique pourquoi une modification de liste peut se retrouver sous plusieurs noms de variables. L’instruction b = a ne copie pas l’objet désigné par a : elle associe un autre nom au même objet. Pour préparer des données sans modifier leur état de départ, vous devez donc distinguer une affectation, une copie superficielle et une copie profonde.
Cet article approfondit les bases de Python. Vous apprendrez à repérer un objet mutable, à vérifier si deux noms désignent le même objet et à choisir une copie adaptée à une liste ou à un dictionnaire contenant une liste. Cette compréhension vous servira avant de transformer les données utilisées par un modèle de machine learning.
Avant de commencer
Vous devez savoir affecter une valeur à une variable, accéder à un élément de liste et appeler une fonction. Si votre environnement n’est pas encore prêt, suivez le guide Installer Python avec uv, VS Code et Jupyter. Ouvrez/Créez ensuite MutabiliteCopiesPython.ipynb, sélectionnez le noyau Python de votre projet en haut à droite de VS Code et exécutez les cellules dans l’ordre.
Le notebook utilise uniquement Python et le module standard copy. Les exemples ont été exécutés avec Python 3.14.8.
Sommaire
Objets, types et mutabilité en Python
Un objet est une valeur manipulée par Python, accompagnée d’un type et d’une identité. Le type détermine les opérations possibles : additionner deux entiers, ajouter un élément à une liste ou rechercher une clé dans un dictionnaire. L’identité distingue cet objet des autres, même lorsque leurs valeurs sont égales. Ces notions sont définies dans le modèle de données officiel de Python.
Un objet est mutable si son état peut être modifié après sa création. Une liste conserve ainsi son identité lorsque vous changez un de ses éléments ou son ordre.
Un objet immuable ne permet pas cette modification : pour utiliser une autre valeur, vous réaffectez le nom de la variable à un autre objet. L’immuabilité concerne l’objet, pas le nom qui le désigne.
| Types | objets mutables et immuables |
|---|---|
int, float, bool, str | Ces objets sont immuables. Un nom de variable peut toutefois être réaffecté. |
list | La liste est mutable : éléments, longueur et ordre peuvent changer. |
dict | Un dictionnaire est mutable : vous pouvez ajouter ou supprimer des entrées, ou modifier la valeur associée à une clé. |
set | L’ensemble est mutable : vous pouvez ajouter ou retirer un élément. |
tuple | Le tuple est immuable. Un objet mutable qu’il contient peut néanmoins être modifié. |
La fonction type() permet de reconnaître le type d’un objet. Dans la première cellule, .__name__ affiche simplement le nom de ce type. Le tuple scores_reference conserve les cinq scores de départ ; les exemples suivants créent leurs listes à partir de cette référence.
# Créer un tuple de scores de référence
scores_reference = (67, 61, 74, 71, 70)

# Afficher le type d’un score, du tuple et de sa conversion en liste
print("score :", type(scores_reference[0]).__name__)
print("collection :", type(scores_reference).__name__)
print("liste :", type(list(scores_reference)).__name__)score : int
collection : tuple
liste : listRéaffecter un nom ne modifie pas un entier
Au départ, score_initial et score_selectionne valent tous les deux 67. Lorsque score_selectionne prend la valeur 74, score_initial reste à 67. En Python, réaffecter une variable ne modifie pas l’objet auquel elle faisait référence.
# Conserver une référence au premier score
score_initial = scores_reference[0]
score_selectionne = score_initial

# Réaffecter le second nom à un autre score
score_selectionne = scores_reference[2]

# Afficher les valeurs associées aux deux noms
print("initial :", score_initial)
print("sélectionné :", score_selectionne)initial : 67
sélectionné : 74Pourquoi deux variables peuvent partager une liste
Une référence permet à un nom ou à un conteneur de désigner un objet. Après notes_a_trier = notes_examens, les deux noms donnent accès à la même liste. Cet autre nom est parfois appelé un alias. Le module copy rappelle explicitement que l’affectation ne copie pas les objets.
L’opérateur is compare l’identité de deux objets. La méthode .sort() trie une liste en place, c’est-à-dire en modifiant l’objet existant. Vous pouvez donc constater le partage avant le tri, puis observer son effet sous le nom d’origine.
# Créer une liste et lui donner un second nom
notes_examens = list(scores_reference)
notes_a_trier = notes_examens

# Vérifier que les deux noms désignent le même objet
print("même objet :", notes_a_trier is notes_examens)

# Trier la liste en place, puis observer la liste d’origine
notes_a_trier.sort()
print("liste d’origine :", notes_examens)même objet : True
liste d’origine : [61, 67, 70, 71, 74]La sortie True confirme que les deux noms désignent le même objet. Le tri donne [61, 67, 70, 71, 74], y compris lorsque vous affichez notes_examens. Si vous vouliez conserver l’ordre des lignes du classeur, cette affectation ne convenait pas. Le tri n’a pas changé les scores, mais il a changé leur ordre dans la liste de travail.
Créer une copie de liste adaptée
La méthode .copy() crée une copie superficielle : un nouveau conteneur est construit, mais les objets qu’il contient restent référencés. Vous pouvez aussi copier une liste avec list(notes_examens) ou notes_examens[:]. Ces opérations ont la même limite pour une liste contenant d’autres objets mutables.
Pour notre liste d’entiers, une copie superficielle suffit à préserver la liste d’origine lors d’un tri. Les entiers sont immuables ; les deux listes disposent chacune de leur propre ordre d’éléments. Comparez les valeurs avec == et les identités avec is avant de modifier la copie.
# Créer la liste d’origine et une copie indépendante
notes_examens = list(scores_reference)
notes_triees = notes_examens.copy()

# Comparer les valeurs et l’identité des deux listes
print("mêmes valeurs :", notes_triees == notes_examens)
print("même objet :", notes_triees is notes_examens)

# Trier la copie, puis afficher les deux listes
notes_triees.sort()
print("origine :", notes_examens)
print("copie triée :", notes_triees)mêmes valeurs : True
même objet : False
origine : [67, 61, 74, 71, 70]
copie triée : [61, 67, 70, 71, 74]Les deux listes commencent avec les mêmes valeurs : == renvoie True. Ce sont pourtant deux objets distincts : is renvoie False. Après le tri, l’ordre d’origine est conservé sous notes_examens. Remplacer un entier dans la copie préserverait également l’élément correspondant de l’autre liste.
Un tuple peut contenir un objet mutable
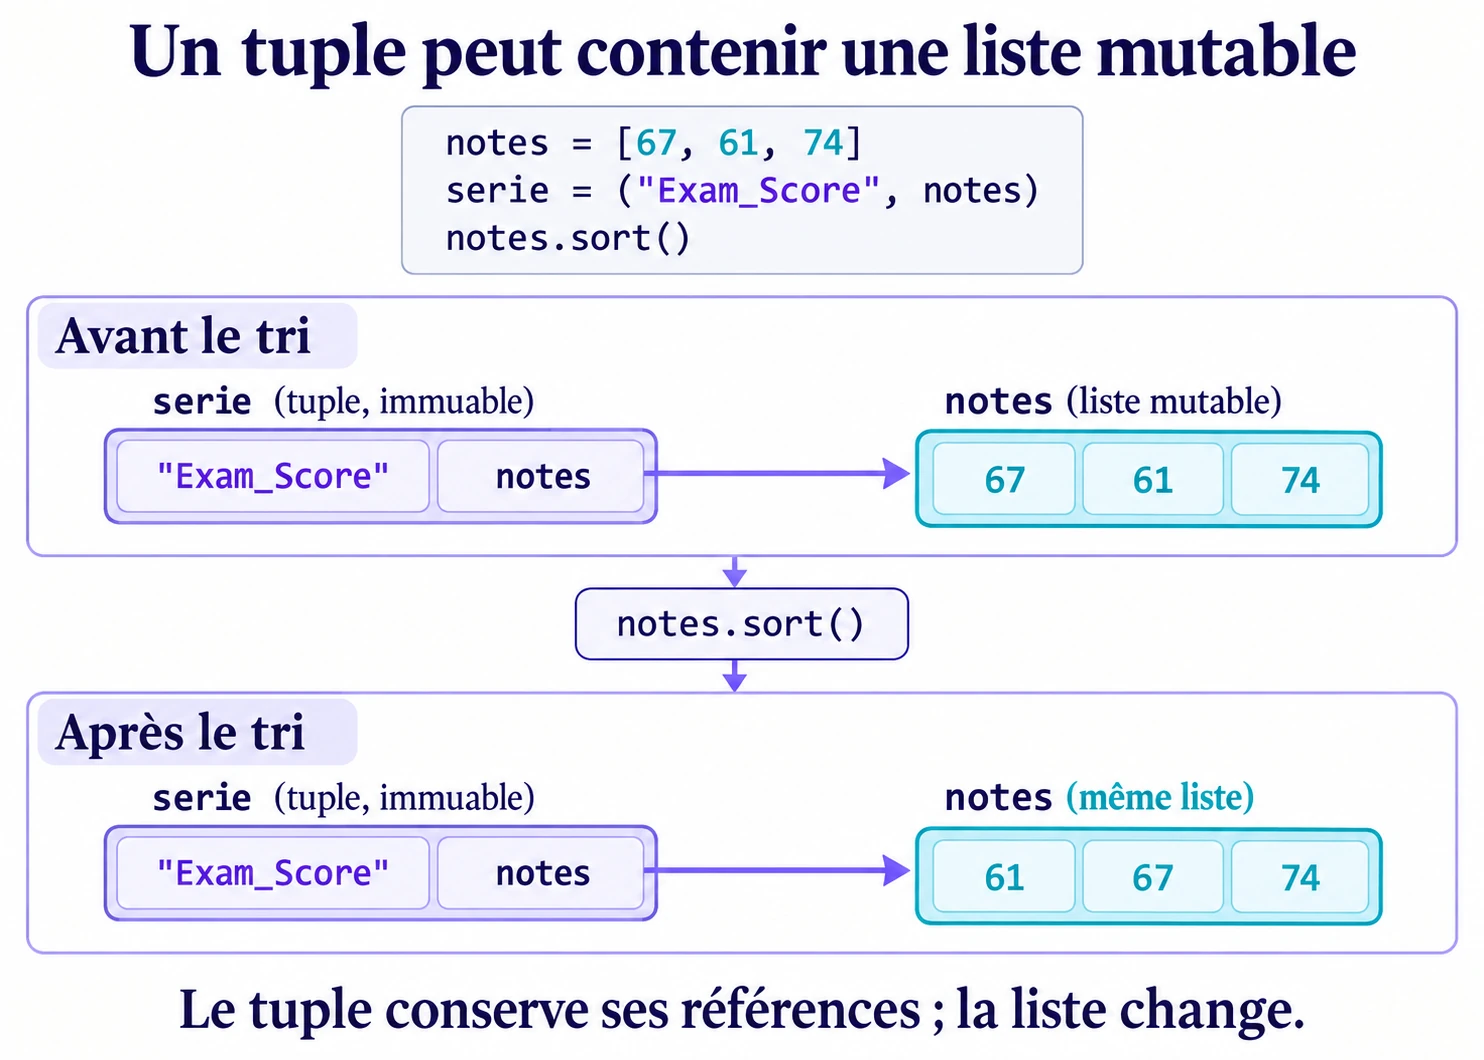
L’immuabilité d’un tuple fixe les références de ses éléments. Elle ne rend pas immuable la liste vers laquelle l’un d’eux renvoie. Dans l’exemple suivant, le tuple contient le nom de la colonne et une liste de trois scores. Trier cette liste modifie donc ce que vous observez en affichant le tuple.
# Placer une liste dans un tuple
notes = list(scores_reference[:3])
serie = ("Exam_Score", notes)

# Modifier la liste contenue dans le tuple
notes.sort()

# Afficher le tuple et vérifier que la liste est partagée
print(serie)
print("liste partagée :", serie[1] is notes)('Exam_Score', [61, 67, 74])
liste partagée : TrueLe tuple conserve ses deux éléments : la chaîne "Exam_Score" et la référence à la liste. Vous ne pouvez pas remplacer directement serie[1] par une autre liste, mais vous pouvez modifier la liste déjà désignée par cet élément. C’est pourquoi transformer une liste en tuple n’isole pas automatiquement les objets qu’elle contient.
Un tuple peut contenir un objet mutable
Les ensembles (set) en Python
En Python, un ensemble (appelé set en anglais) est une collection d’éléments sans doublons. Contrairement à une liste, un ensemble ne garantit pas l’ordre de ses éléments. Pour créer un ensemble, on place ses éléments entre accolades {}, séparés par des virgules. Dans notre exemple, champs_a_verifier contient deux noms de champs : Hours_Studied et Attendance. La méthode .add() permet d’ajouter un troisième champ, Exam_Score.
Un ensemble est mutable : on peut ajouter ou supprimer des éléments après sa création. Python propose également frozenset, une version immuable de l’ensemble. Les structures de données du tutoriel officiel présentent ces usages.
# Créer un ensemble (set) contenant deux champs
champs_a_verifier = {"Hours_Studied", "Attendance"}

# Ajouter un nouveau champ à l’ensemble
champs_a_verifier.add("Exam_Score")

# Compter les éléments
print("nombre de champs :", len(champs_a_verifier))

# Vérifier la présence d’un champ
print("Exam_Score présent :", "Exam_Score" in champs_a_verifier)nombre de champs : 3
Exam_Score présent : TrueCopie superficielle ou profonde d’un dictionnaire
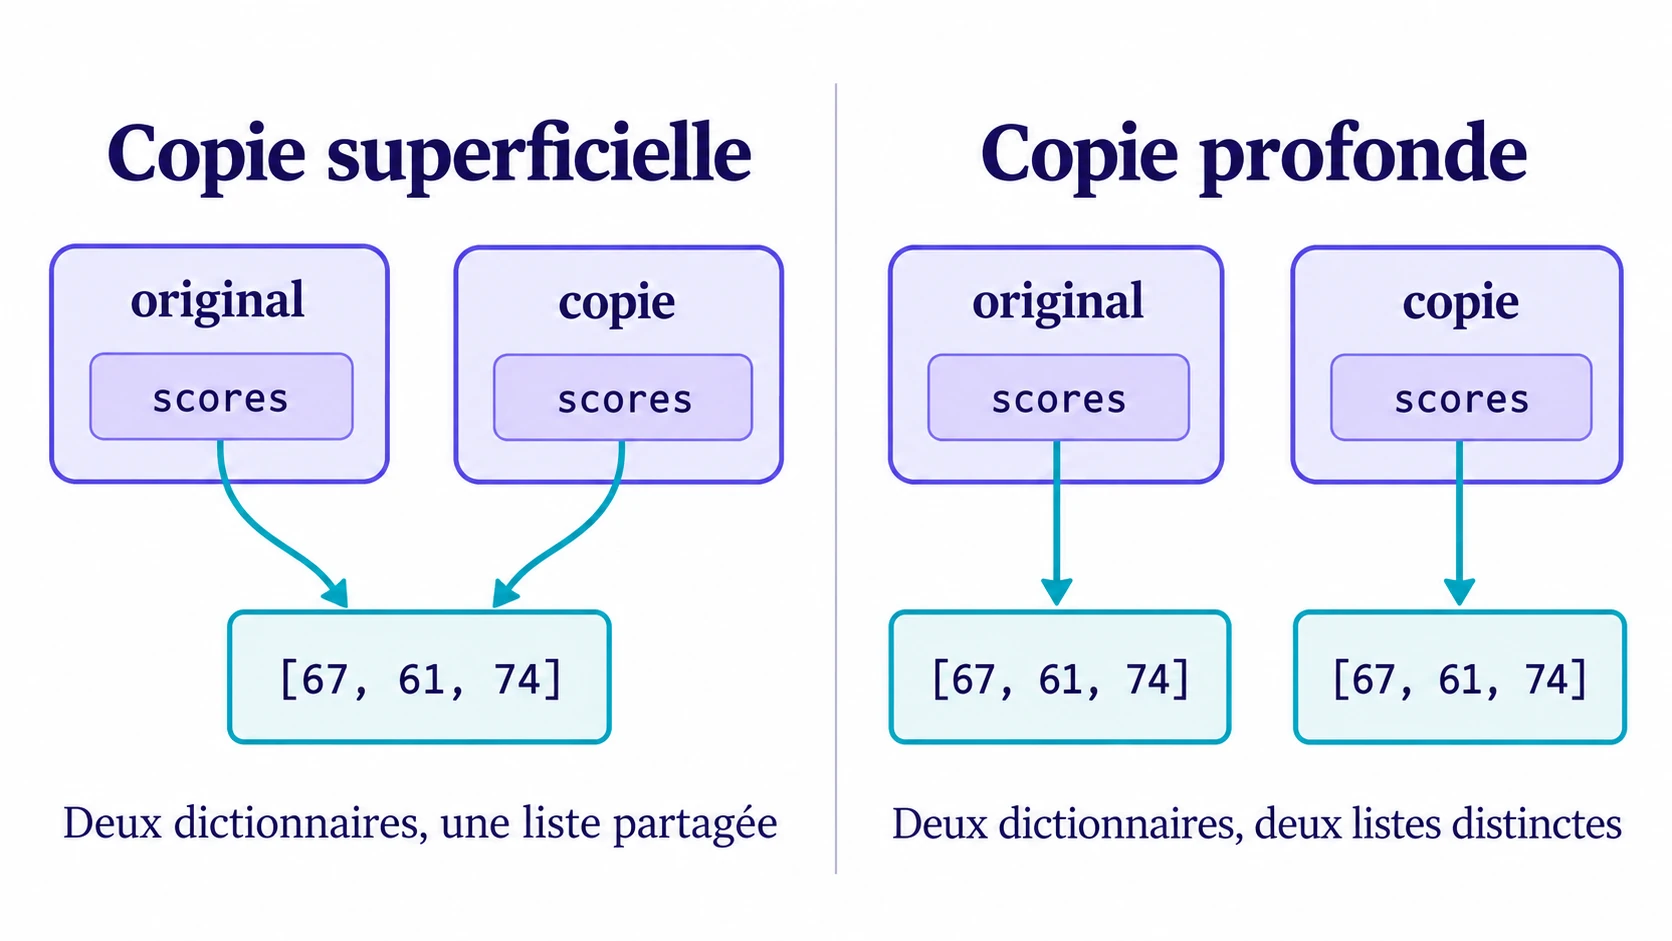
La différence devient visible avec un dictionnaire dont une valeur est une liste. original.copy() crée un dictionnaire distinct, mais sa clé "scores" renvoie encore à la liste utilisée par original. La copie du conteneur extérieur n’a pas copié les objets imbriqués.
Observer le partage après une copie superficielle
# Créer un dictionnaire contenant une liste, puis une copie superficielle
original = {"scores": list(scores_reference[:3])}
copie = original.copy()

# Comparer les dictionnaires et la liste qu’ils contiennent
print("même dictionnaire :", copie is original)
print("même liste :", copie["scores"] is original["scores"])

# Trier la liste partagée, puis afficher les valeurs dans chaque dictionnaire
copie["scores"].sort()
print("origine :", original["scores"])
print("copie :", copie["scores"])même dictionnaire : False
même liste : True
origine : [61, 67, 74]
copie : [61, 67, 74]Les dictionnaires sont distincts, mais leurs listes ne le sont pas. Le tri de copie["scores"] apparaît donc également dans original["scores"]. Si vous remplaciez seulement la valeur de la clé dans le nouveau dictionnaire, l’autre dictionnaire garderait sa propre association. Ici, l’opération modifie la liste partagée.
Utiliser une copie profonde lorsque la structure le nécessite
Une copie profonde parcourt une structure composée pour copier les objets imbriqués concernés ; les objets immuables peuvent rester partagés. Pour notre dictionnaire de listes et d’entiers, deepcopy() crée aussi une liste intérieure distincte. Le mot-clé from importe ici cette fonction depuis copy, qui fait partie de la bibliothèque standard.
# Importer la fonction de copie profonde
from copy import deepcopy

# Copier le dictionnaire et la liste qu’il contient
original = {"scores": list(scores_reference[:3])}
copie = deepcopy(original)

# Vérifier que les listes sont distinctes
print("même liste :", copie["scores"] is original["scores"])

# Trier la liste de la copie, puis afficher les deux listes
copie["scores"].sort()
print("origine :", original["scores"])
print("copie :", copie["scores"])même liste : False
origine : [67, 61, 74]
copie : [61, 67, 74]La liste de départ reste [67, 61, 74] et seule la copie devient [61, 67, 74]. Choisissez néanmoins la copie selon l’opération prévue : une copie profonde peut dupliquer plus de données que nécessaire. Pour une structure connue, copier seulement les objets à modifier peut suffire.
Préserver les données transmises à une fonction
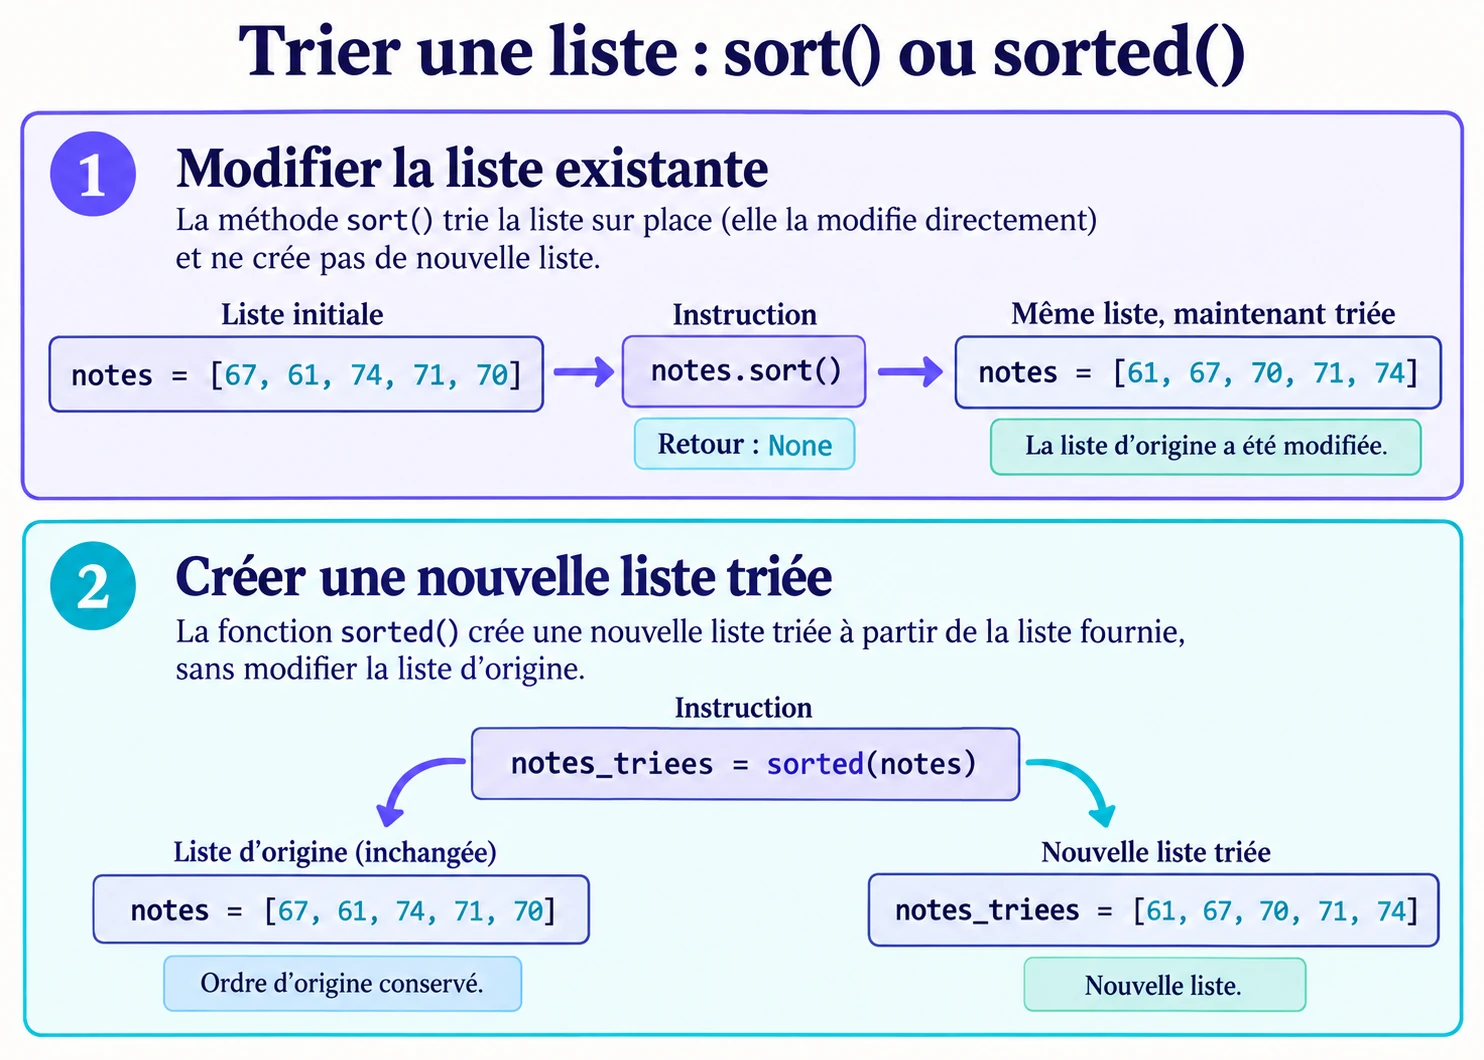
Un paramètre de fonction reçoit une référence à l’objet transmis. La fonction peut donc modifier une liste appartenant au code qui l’appelle si elle utilise une opération en place. Lorsque vous souhaitez conserver l’entrée et produire un résultat, choisissez une opération qui crée ce résultat séparément.
La fonction intégrée sorted() renvoie une nouvelle liste triée, alors que .sort() modifie la liste existante. Cette distinction figure dans le guide officiel du tri en Python. Notre fonction trier_scores utilise donc sorted() pour préserver son entrée.
# Définir une fonction qui renvoie une nouvelle liste triée
def trier_scores(scores):
    return sorted(scores)

# Appeler la fonction avec la liste de scores
notes_examens = list(scores_reference)
resultat = trier_scores(notes_examens)

# Comparer l’entrée et le résultat sans modifier l’entrée
print("entrée :", notes_examens)
print("résultat :", resultat)entrée : [67, 61, 74, 71, 70]
résultat : [61, 67, 70, 71, 74]Le résultat est trié et l’entrée conserve son ordre. Cette séparation aide à vérifier les transformations successives des données : vous pouvez comparer l’état de départ au résultat sans reconstruire le premier. Elle ne constitue toutefois pas une garantie générale pour toute fonction ; il faut examiner les opérations utilisées.
Mise en pratique : préparer une copie de travail
Vous disposez d’un dictionnaire original contenant le champ "Exam_Score" et la liste des cinq scores de départ. Créez un dictionnaire travail distinct, triez ses scores dans l’ordre croissant et conservez les scores d’origine dans leur ordre initial. Le nom du champ doit rester identique.
Commencez par prévoir les objets qui doivent être indépendants. Le dictionnaire extérieur sera modifié pour lui associer une autre liste ; cette liste sera ensuite triée. La chaîne décrivant le champ n’a pas besoin d’être copiée pour cette opération.
Afficher la correction et ses vérifications
# Créer le dictionnaire d’origine
original = {
    "champ": "Exam_Score",
    "scores": list(scores_reference),
}

# Copier le dictionnaire et sa liste avant le tri
travail = original.copy()
travail["scores"] = original["scores"].copy()
travail["scores"].sort()

# Afficher les valeurs et vérifier que les listes sont distinctes
print("origine :", original["scores"])
print("travail :", travail["scores"])
print("champ conservé :", travail["champ"])
print("listes distinctes :", travail["scores"] is not original["scores"])

# Vérifier que l’origine est intacte et que la copie est triée
assert original["scores"] == list(scores_reference)
assert travail["scores"] == sorted(scores_reference)
assert travail is not originalorigine : [67, 61, 74, 71, 70]
travail : [61, 67, 70, 71, 74]
champ conservé : Exam_Score
listes distinctes : TrueLa première copie crée le dictionnaire de travail. La deuxième crée la liste que vous allez trier, puis l’affectation à travail["scores"] remplace la référence partagée. Les deux listes évoluent désormais séparément. Les instructions assert vérifient les résultats : une condition fausse interromprait la cellule avec une erreur.
Pour cette structure précise, deepcopy(original) aurait aussi convenu. La copie ciblée rend visible ce qui est isolé. Si le dictionnaire contenait plusieurs niveaux d’objets mutables à modifier, vous devriez adapter la copie à cette structure.
Erreurs fréquentes à reconnaître
Affecter le résultat de sort à une variable
La méthode .sort() renvoie None, qui représente ici l’absence de résultat retourné. Elle a déjà modifié la liste. Une affectation comme notes_examens = notes_examens.sort() fait donc perdre à ce nom sa référence à la liste. Observez séparément la valeur retournée et la liste triée.
# Créer une liste de scores
notes_examens = list(scores_reference)

# Trier la liste en place et récupérer la valeur renvoyée
resultat = notes_examens.sort()

# Afficher le retour de sort() et la liste modifiée
print("retour de sort :", resultat)
print("liste après tri :", notes_examens)retour de sort : None
liste après tri : [61, 67, 70, 71, 74]Pour garder le même objet, appelez simplement notes_examens.sort(). Pour obtenir une autre liste et préserver l’entrée, utilisez notes_triees = sorted(notes_examens).
Confondre égalité et identité
Deux listes peuvent avoir les mêmes valeurs sans être le même objet. Employez == pour comparer leurs valeurs et is pour rechercher un partage d’objet. Évitez de déduire une règle de copie à partir de l’identité de petits entiers ou de chaînes : Python peut réutiliser certains objets immuables.
Réutiliser une liste déjà modifiée dans le notebook
Une cellule exécutée plusieurs fois retrouve les variables déjà présentes dans le noyau. Si une liste a été triée, son ordre précédent ne réapparaît pas automatiquement. Les exemples reconstruisent donc leurs listes avec list(scores_reference). Pour reproduire toutes les sorties, redémarrez le noyau puis choisissez « Exécuter tout ».
Mutabilité en Python : 5 règles à retenir
Pour choisir une copie adaptée et conserver les données de départ, appliquez ces cinq règles aux objets présentés dans cette leçon.
- Identifier les références partagées. Une affectation donne un autre nom au même objet. Vérifiez ce partage avec
isavant de modifier une liste. - Copier une liste d’éléments immuables. Une copie superficielle avec
.copy()crée une liste distincte. Pour les scores entiers de cet exemple, elle suffit à préserver l’ordre d’origine. - Examiner chaque niveau d’une structure. Une copie superficielle de dictionnaire peut encore partager ses listes. Copiez aussi la liste que vous allez modifier, comme dans l’exercice.
- Choisir une copie profonde selon le besoin. Dans le dictionnaire présenté,
deepcopy()recrée la liste intérieure. Une copie profonde peut dupliquer plus d’objets que nécessaire ; une copie ciblée suffit parfois. - Préférer une opération qui préserve l’entrée.
sorted()renvoie une nouvelle liste ;.sort()modifie la liste existante et renvoieNone. Choisissez l’opération selon le résultat attendu.
