الانحدار، التصنيف أم التجميع: أي مهمة تختار؟
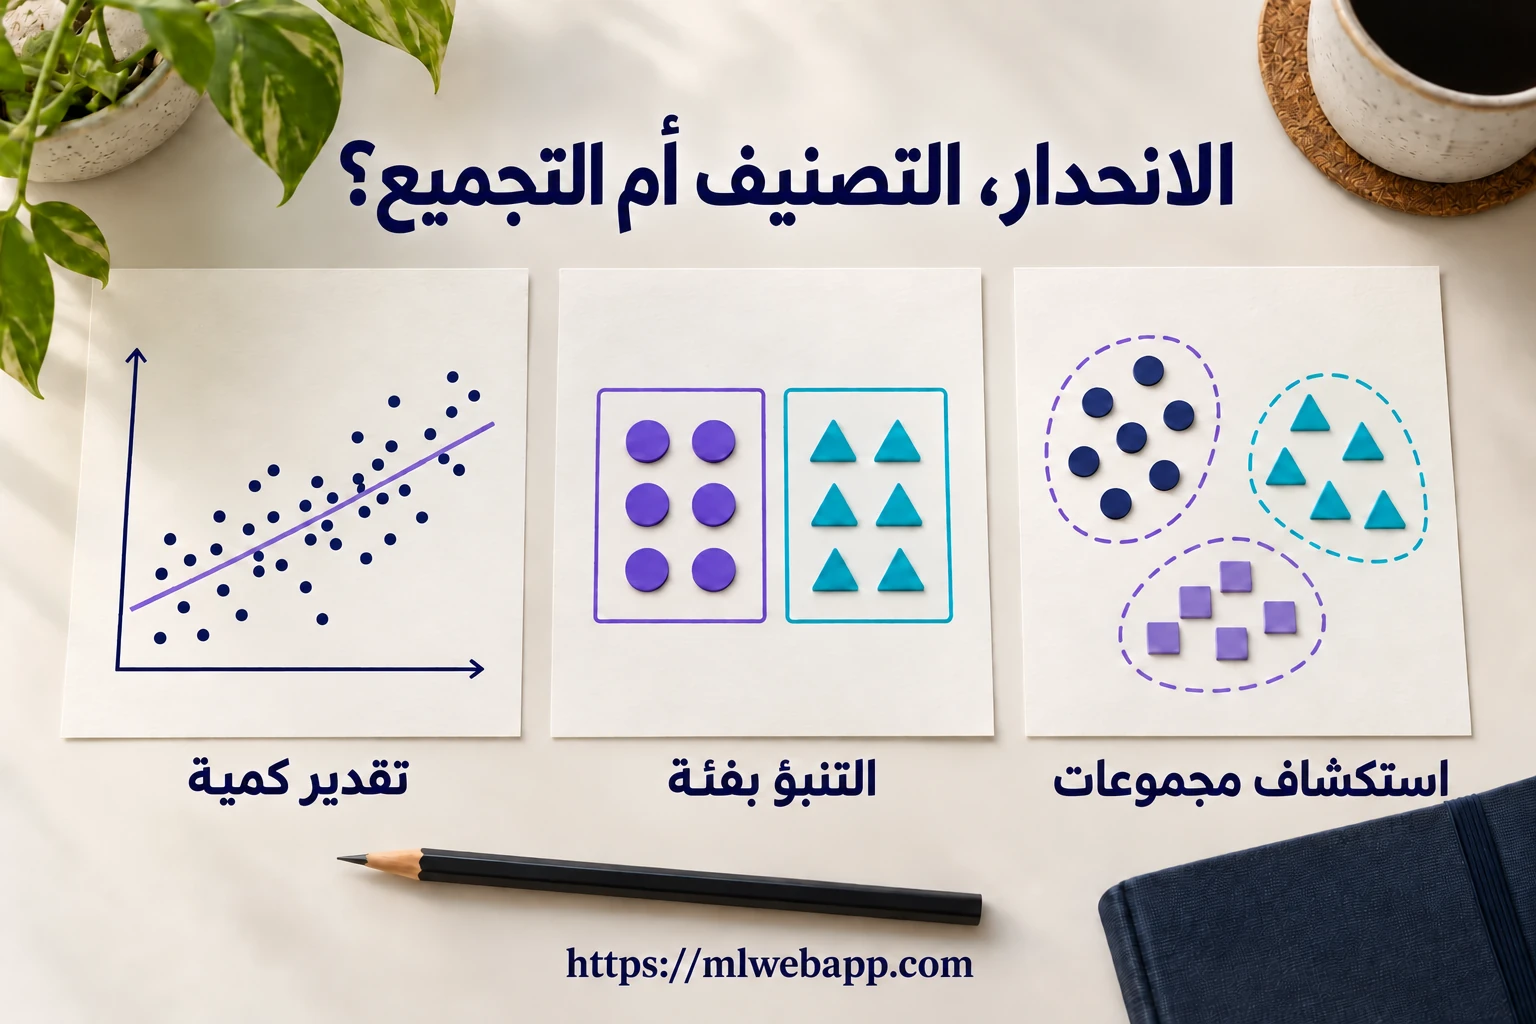
الانحدار، التصنيف أم التجميع؟ للاختيار بينها، ابدأ بالإجابة التي تحتاج إليها. هل تريد تقدير كمية، أم التنبؤ بفئة محددة المعنى مسبقًا، أم اكتشاف مجموعات من سجلات البيانات المتشابهة؟ تقود هذه الأهداف الثلاثة إلى مهام مختلفة، حتى حين تتعلق البيانات الأولية بالموضوع نفسه.
في درس التعلّم الخاضع للإشراف وغير الخاضع للإشراف، تعرّفت إلى دور المتغير الهدف. سنستخدم الآن هذا التمييز لصياغة مشكلة محددة: ما المخرج المطلوب، وما المعلومات التي ينبغي تقديمها، وما الأخطاء التي يجب فحصها؟ يأتي اختيار الخوارزمية بعد ذلك.
قبل أن تبدأ. يصف كل سجل بيانات حالة واحدة، ويمثله صف في الجدول؛ أما المتغير فهو خاصية مسجلة لهذه الحالة ويمثلها عمود. تستخدم الأمثلة حقولًا من المصنف StudentPerformanceFactors.xlsx، المُعدّ انطلاقًا من مجموعة بيانات Student Performance Factors على Kaggle.
محتويات المقال
الانحدار، التصنيف أم التجميع: ثلاث إجابات ممكنة
تصف مهمة تعلّم الآلة ما ينبغي أن يتعلم النظام إنتاجه. عبارة «استخدم شجرة قرار» لا تحدد المهمة؛ إذ يمكن لهذه الطريقة أن تقدّر كمية أو تتنبأ بفئة. السؤال الأجدى هو: «ما الذي ينبغي أن يعرضه التطبيق عند تقديم حالة جديدة؟» لذلك يوصي دليل Google لصياغة المشكلة بتحديد المخرج قبل اختيار النموذج.
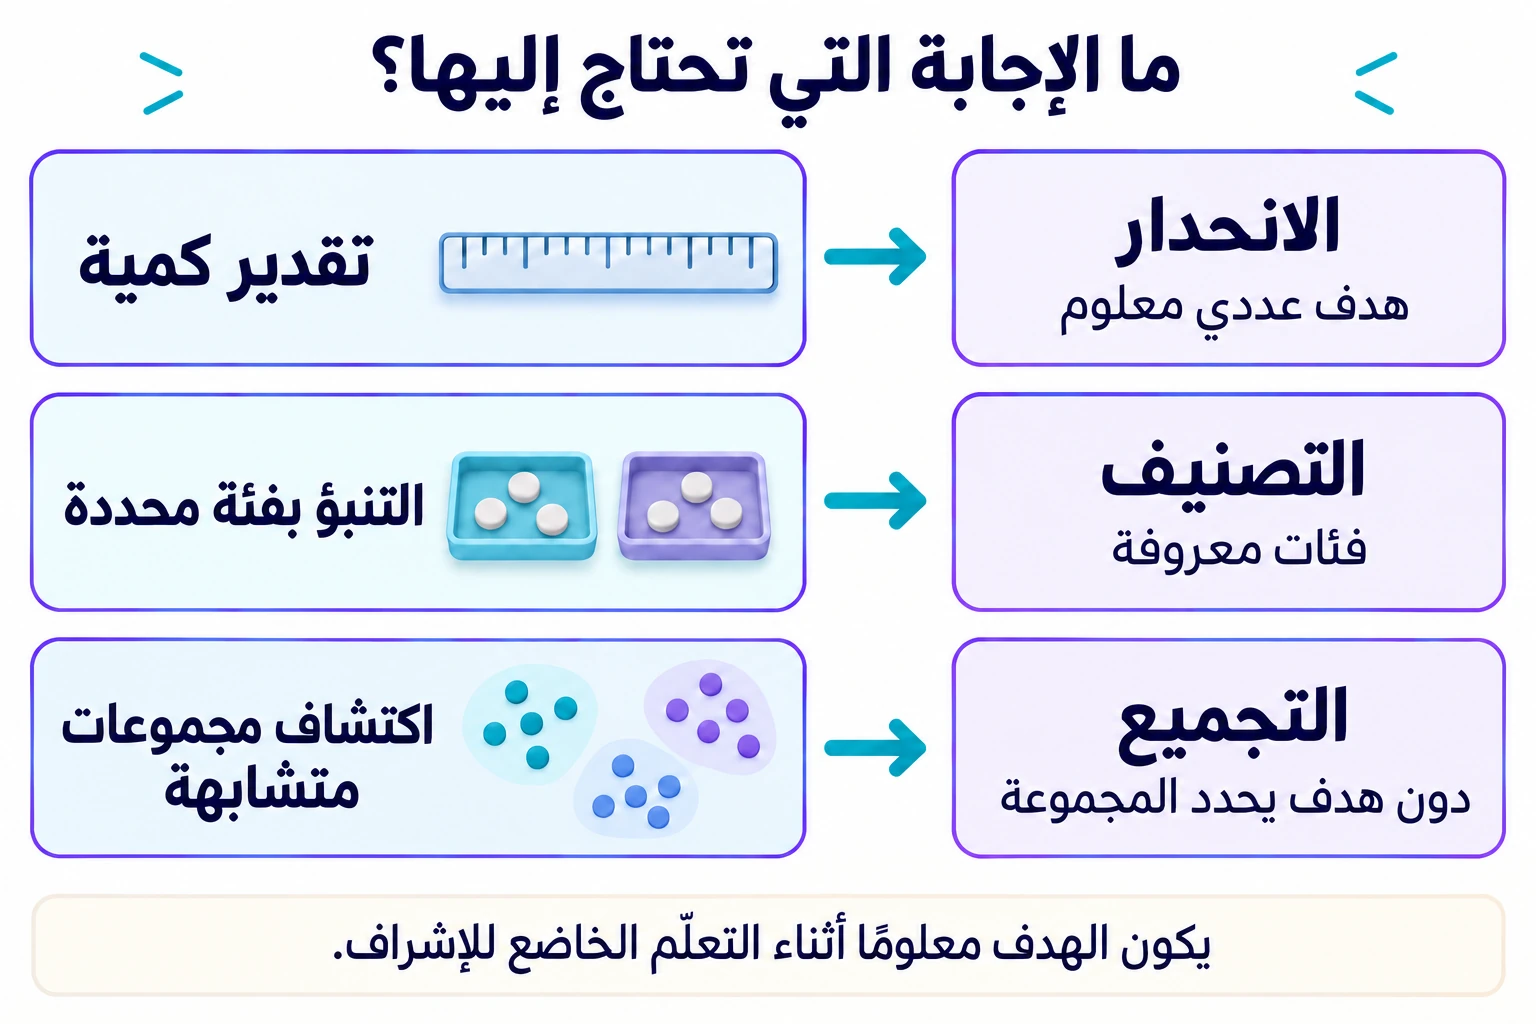
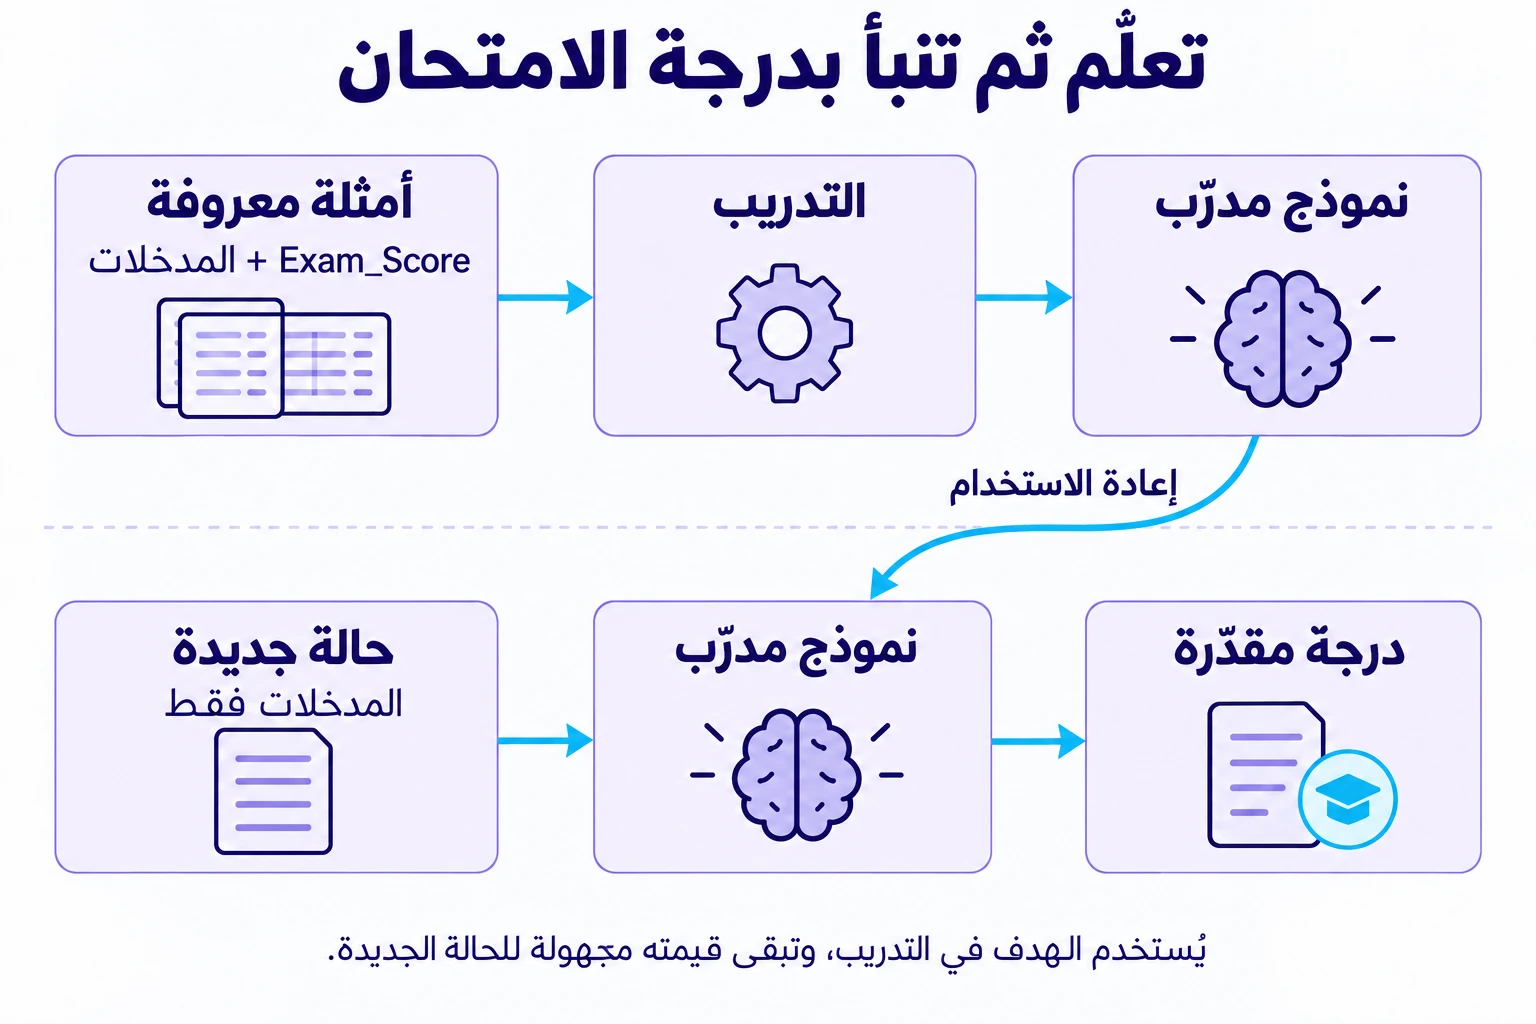
في التعلّم الخاضع للإشراف، يجمع كل مثال تدريبي بين المدخلات وإجابة معروفة. هذه الإجابة هي المتغير الهدف، ويُرمز إليه غالبًا بـ y، بينما يُرمز إلى المدخلات غالبًا بـ X. أثناء التدريب، تُستخدم المدخلات وقيم الهدف المقابلة لها معًا لتعديل النموذج كي يتعلم من هذه الأمثلة المعروفة. أما للتنبؤ بحالة جديدة، فلا تُقدَّم إليه إلا المدخلات المتاحة. الهدف هو ما يتعين على النموذج تقديره، وليس معلومة يتلقاها عن هذه الحالة الجديدة. تعرض مقدمة Google في التعلّم الخاضع للإشراف هذه العملية.
يندرج الانحدار والتصنيف ضمن هذا الإطار الخاضع للإشراف. أما التجميع الذي ندرسه هنا فهو غير خاضع للإشراف؛ إذ يسعى إلى تنظيم سجلات البيانات دون تزويده بالفئة المتوقعة لكل منها. لدينا إذن ثلاث مهام، لكنها تندرج ضمن إطارين للتعلّم.
الانحدار: تقدير كمية
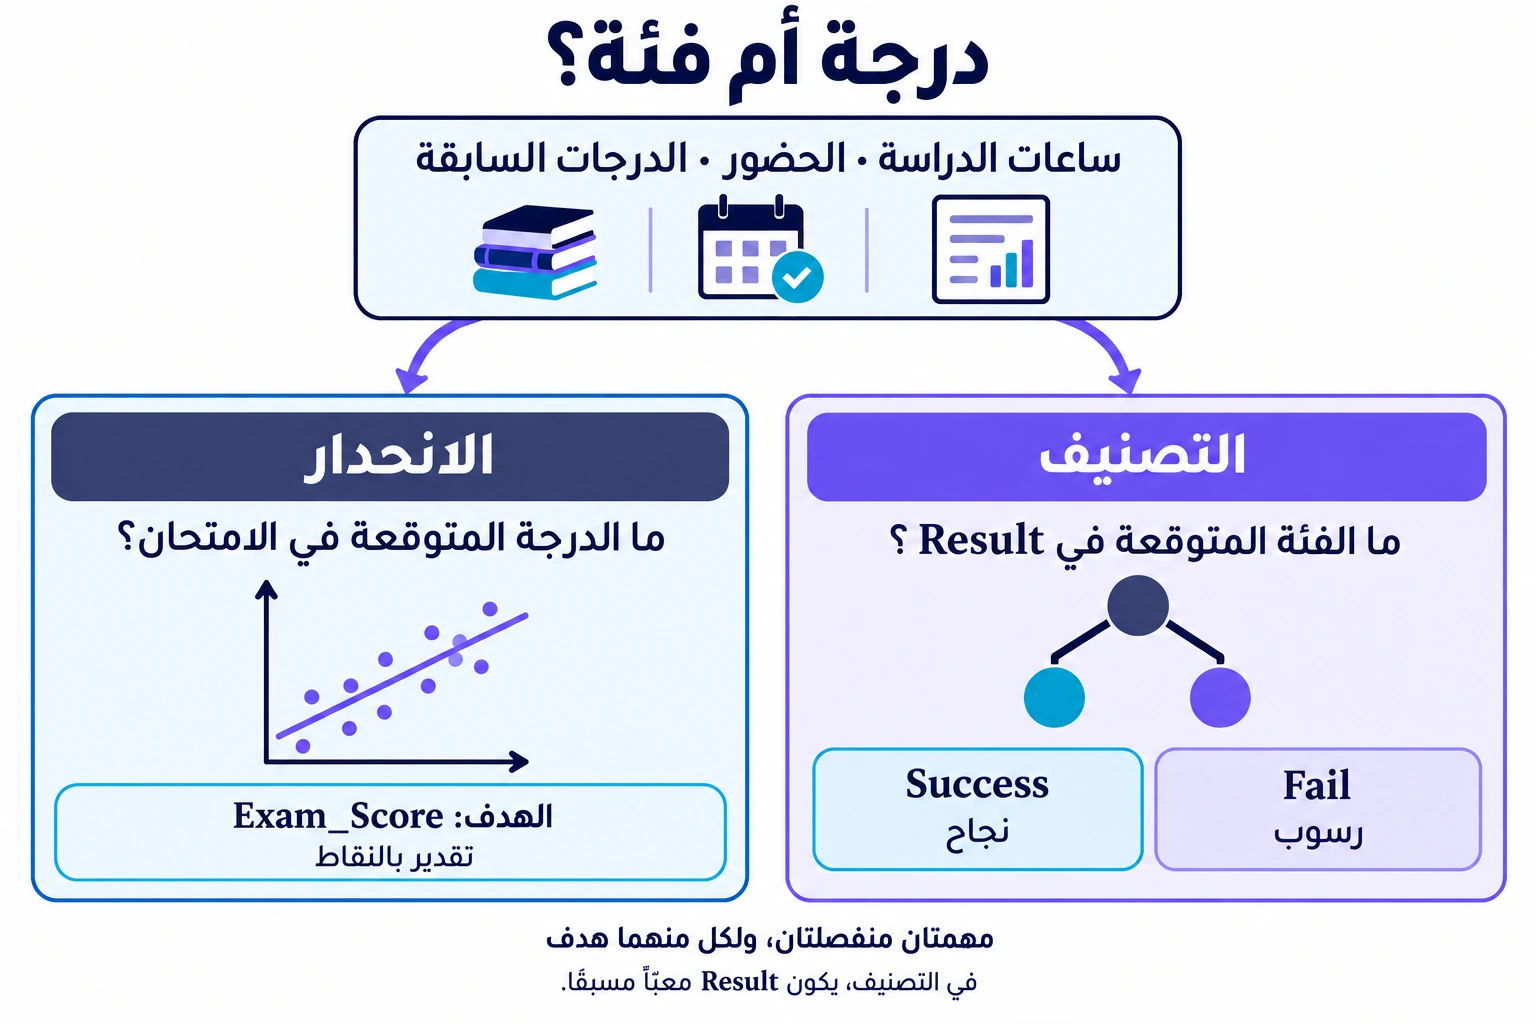
يقوم الانحدار على تعلّم تقدير هدف عددي يمثل كمية. في مجموعة البيانات المخصصة للانحدار، المتغير الهدف الوحيد هو Exam_Score، أي درجة الامتحان.
لنصغ الطلب على النحو الآتي: «ما الدرجة التي يمكن تقديرها باستخدام المعلومات المعروفة قبل الامتحان؟» من المدخلات الممكنة، يسجل Hours_Studied عدد ساعات الدراسة أسبوعيًا، ويسجل Attendance النسبة المئوية للحصص التي حضرها الطالب، بينما يسجل Previous_Scores درجات الامتحانات السابقة. وجود هذه المتغيرات في الملف لا يضمن فائدتها؛ لكنه يتيح تحديد مشكلة أولية يمكن دراستها.
| الدراسة (ساعة/أسبوع) | الحضور (%) | الدرجات السابقة | Exam_Score |
|---|---|---|---|
| 23 | 84 | 73 | 67 |
| 19 | 64 | 59 | 61 |
| 24 | 98 | 91 | 74 |
في الصف الأول، تمثل القيمة 67 درجة مرصودة، وليست تنبؤًا. يتعلم النموذج من صفوف كثيرة من هذا النوع. وبعد تدريبه، يمكنه تلقي مدخلات حالة جديدة وإنتاج تقدير عددي. ويجب تقييم هذا التقدير على سجلات أخرى ذات درجات معروفة، جرى الاحتفاظ بها جانبًا لغرض الفحص والتقييم.
تخزين Exam_Score في صورة أعداد صحيحة لا يحوّل المسألة إلى تصنيف. الغرض هو تقدير كمية، وقد يتضمن التقدير منازل عشرية. ولا يقتصر الانحدار على ملاءمة خط مستقيم؛ إذ تستطيع فئات مختلفة من النماذج تقدير المتغير الهدف العددي نفسه.
التصنيف: التنبؤ بفئة محددة
يقوم التصنيف على تعلّم التنبؤ بفئة، تُسمى بالإنجليزية class، من بين الفئات المحددة للمشكلة. في مجموعة بيانات منفصلة مخصصة للتصنيف، المتغير الهدف الوحيد هو Result. لكل مثال تدريبي، تكون التسمية المسجلة إما Success أو Fail. هذه التسميات متاحة مسبقًا؛ وتُقرأ مباشرة باعتبارها الإجابات التي ينبغي أن يتعلم النموذج التنبؤ بها.
| الدراسة (ساعة/أسبوع) | الحضور (%) | الدرجات السابقة | Result |
|---|---|---|---|
| 23 | 84 | 73 | Success |
| 19 | 64 | 59 | Success |
| 24 | 98 | 91 | Success |
| 13 | 69 | 68 | Fail |
يصبح الطلب: «ما قيمة Result التي ينبغي التنبؤ بها لحالة جديدة؟» تصف المدخلات الحالة الجديدة، بينما تبقى فئتها بحاجة إلى تقدير. هذا تصنيف ثنائي لوجود فئتين. أما حين يزيد عدد الفئات على اثنتين، فيُسمى تصنيفًا متعدد الفئات.
لا تغيّر المدخلات العددية طبيعة المهمة؛ إذ يمكن استخدام ساعات الدراسة والحضور في التصنيف. وبالمثل، إذا مُثّلت الفئات برموز عددية، فإن هذه الرموز تظل معرّفات لفئات، ولا تجعل المتغير الهدف كمية مطلوبًا تقديرها.
تقدّر بعض النماذج احتمال الانتماء إلى فئة، ثم تُطبَّق قاعدة قرار لاختيار الفئة المتنبأ بها. يكون المخرج الوسيط عدديًا، لكنه يتعلق بفئة؛ لذلك تظل المسألة مسألة تصنيف. وعلى الرغم من اسمه، يُستخدم الانحدار اللوجستي لهذه المهمة. والاحتمال المقدّر يحتاج هو الآخر إلى تقييم، ولا يقدم يقينًا بشأن حالة بعينها.
التجميع: استكشاف سجلات البيانات المتشابهة
يبحث التجميع، أو Clustering، عن مجموعات من سجلات البيانات المتشابهة، دون تزويده بمتغير هدف يحدد المجموعة المتوقعة لكل سجل. والمقصود بالتشابه هنا هو التقارب بناءً على السمات وطريقة المقارنة بينها.
يمكننا أن نسأل عن بياناتنا: «أي سجلات البيانات تتشابه من حيث ساعات الدراسة، والحضور والنوم؟» سيستخدم التحليل عندئذٍ Hours_Studied، وAttendance وSleep_Hours، الذي يسجل عدد ساعات النوم في الليلة. لا تُزوَّد الخوارزمية بتسمية تحدد المجموعة الصحيحة لكل سجل كي تتعلم منها. وإذا تشكلت مجموعات، فسيجري بعد ذلك وصفها وتفسيرها باستخدام السمات المختارة للتحليل.
وصف سجلات البيانات بأنها «متقاربة» يتطلب تحديد طريقة المقارنة. فساعة واحدة من الدراسة ونقطة مئوية واحدة من الحضور تُقاسان بوحدتين مختلفتين. في طريقة تعتمد على المسافة، قد يؤدي إبقاء القيم على مقاييسها الأصلية، أو إعادة ضبط مقاييسها، إلى تغيير السجلات التي تُعدّ متجاورة. لذلك يشكل إعداد البيانات للتجميع جزءًا من التفكير في المشكلة، ويجب أن يتناسب مع السؤال المدروس.
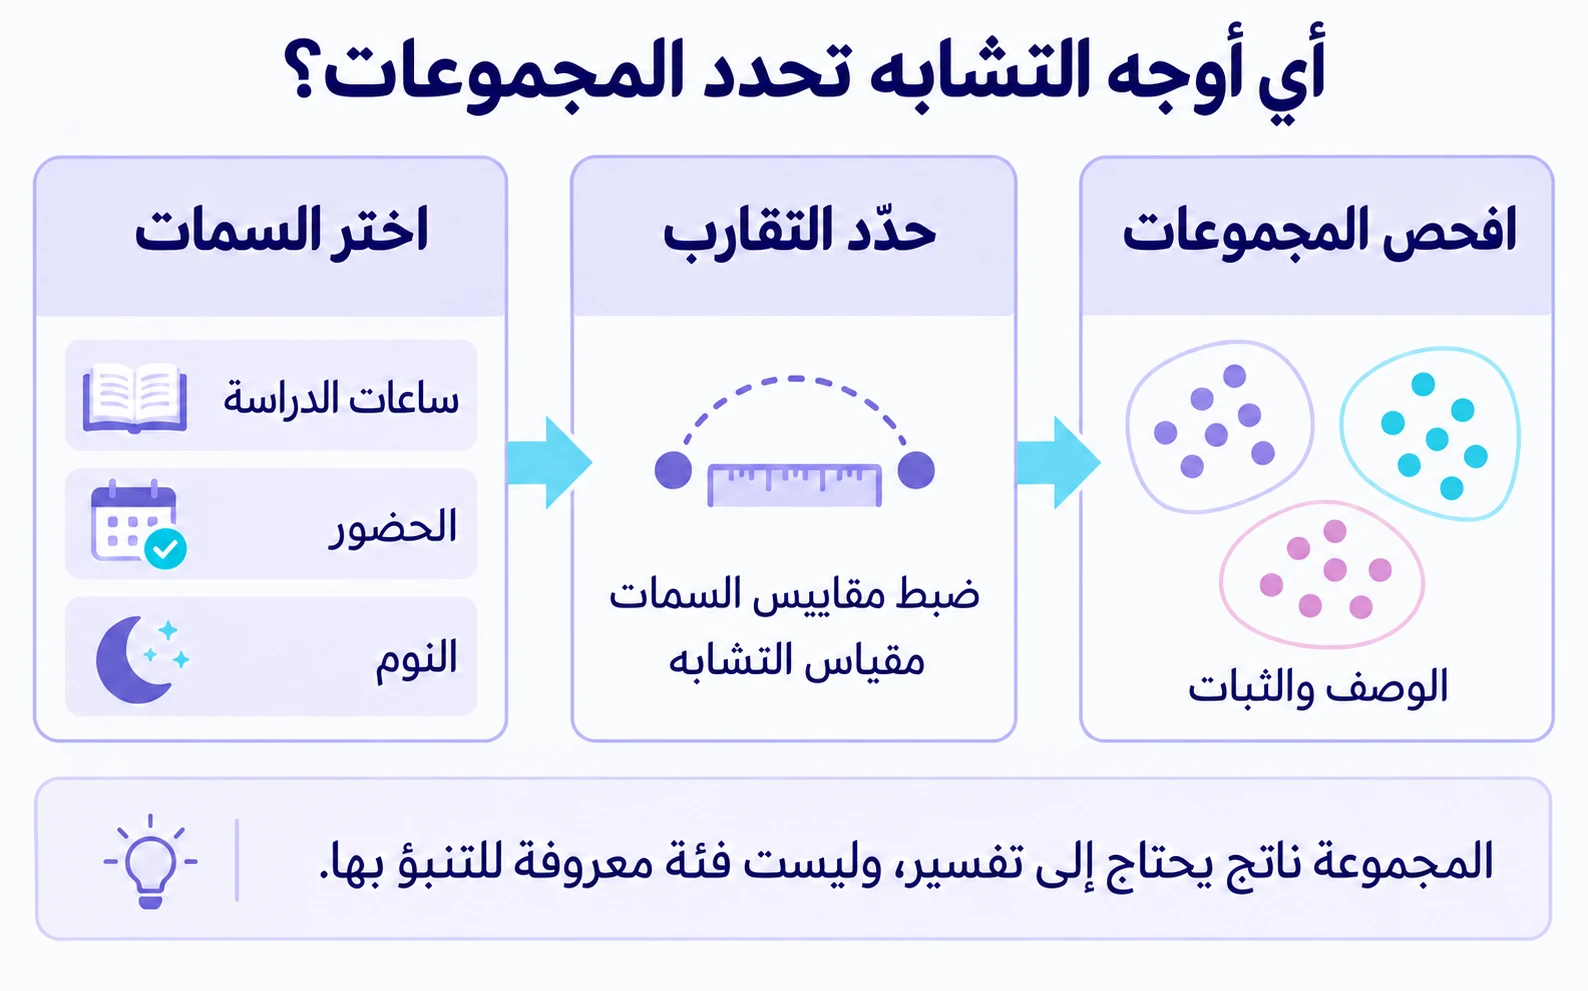
يعتمد عدد المجموعات أيضًا على الطريقة المستخدمة. ففي خوارزمية k-means مثلًا، يُختار عدد المجموعات، الذي يُرمز إليه بـ k، مسبقًا. ثم تقسم الخوارزمية سجلات البيانات إلى مجموعات وفق معيار يعتمد على المسافة. طلب ثلاث مجموعات لا يثبت وجود ثلاث فئات طبيعية من الطلاب؛ فهذا العدد اختيار يُتخذ قبل تشغيل الخوارزمية، وليس نتيجة أثبتتها البيانات.
رقم المجموعة مجرد معرّف لها؛ فالمجموعة 2 ليست أفضل من المجموعة 1. ولا تكفي المجموعات المتشكلة بناءً على عادات الدراسة لاستخلاص استنتاجات عن النجاح الدراسي أو التوصية بتدخل معين. قبل تفسير النتيجة، افحص سمات المجموعات ومدى ثباتها عند تغيير التحليل.
اختيار المهمة في خمسة أسئلة
عند اختيار الانحدار، التصنيف أو التجميع، اكتب وصفًا موجزًا للمشكلة قبل البحث عن خوارزمية. ينبغي أن يتيح هذا الوصف لشخص آخر فهم ما سينتجه النظام، ولماذا تناسب البيانات المتاحة هذه الحاجة.
- ما الإجابة المفيدة؟ اكتب ما ينبغي أن يعرضه التطبيق: تقديرًا بالنقاط، أو إحدى الفئات المسجلة في
Result، أو وصفًا للمجموعات المكتشفة. - هل يصف المخرج كمية، أم فئة محددة، أم مجموعات ينبغي اكتشافها؟ افحص معناه، ولا تكتفِ بنوع بياناته. فقد يقيس العدد الصحيح كمية، وقد يكون رمزًا لفئة.
- ما الإجابات التاريخية المتاحة؟ في المهمتين الخاضعتين للإشراف المعروضتين هنا، يجب أن تحتوي أمثلة التدريب على المتغير الهدف المقابل. أما لاستكشاف أوجه التشابه، فحدّد السمات التي ستقارن بينها.
- متى نحتاج إلى النتيجة؟ يجب أن تكون المدخلات متاحة في ذلك الوقت. فنسبة الحضور المحسوبة على فترة كاملة قد لا تصلح لتنبؤ يُجرى في بدايتها.
- كيف ستميّز النتيجة المفيدة؟ حدّد الأخطاء المهمة وكيف تنوي فحصها. ففحص خطأ بالنقاط يختلف عن فحص فئة غير صحيحة أو مجموعة يصعب تفسيرها.
في مشروع التطبيق، الإجابة المطلوبة هي درجة مقدّرة. لذلك فالمهمة المختارة هي الانحدار باستخدام Exam_Score متغيرًا هدفًا وحيدًا. ويبقى اختيار النموذج وإعداداته. أما التصنيف باستخدام مجموعة البيانات المخصصة له واستكشاف الأنماط، فهما مشكلتان منفصلتان لكل منهما هدفها الخاص.
التخطيط لتقييم يناسب المهمة
مقياس التقييم هو قيمة عددية تلخّص جانبًا من النتيجة. يُختار بحسب المهمة والاستخدام المقصود. لذا يساعد تحديد المهمة على تحديد كيفية تقييمها، لكنه لا يضمن وحده الحصول على تنبؤات مفيدة.
- في الانحدار، افحص الأخطاء. قارن القيم المقدّرة بالقيم المرصودة. يُحسب متوسط الخطأ المطلق، أو MAE، بأخذ القيمة المطلقة للفرق بين القيمة المتنبأ بها والقيمة المرصودة لكل حالة، ثم حساب متوسط هذه الفروق. عندما يكون الهدف درجة امتحان، تُعبّر النتيجة بالنقاط، على المقياس نفسه المستخدم للمتغير الهدف. يلخص هذا المقياس الأخطاء عبر الحالات التي خضعت للتقييم، ولا يحدد حدًا أقصى للخطأ في حالة بعينها.
- في التصنيف، افحص أخطاء الفئات. تقارن مصفوفة الالتباس (confusion matrix) الفئات المرصودة بالفئات المتنبأ بها، وتعرض عدد الحالات عند كل تقاطع بين فئة مرصودة وفئة متنبأ بها. وتساعد على إظهار الفئات التي يخلط النموذج بينها. أما النسبة الإجمالية للتنبؤات الصحيحة، التي تُسمى الدقة الإجمالية أو Accuracy، فقد تخفي ضعف الأداء على فئة قليلة التمثيل.
- في التجميع، افحص البنية الناتجة. انظر خصوصًا إلى مدى تقارب أعضاء المجموعة الواحدة وإلى مدى انفصال المجموعات، وفق طريقة المقارنة المختارة. يجب أن يراعي التقييم أيضًا معنى المجموعات وثباتها؛ ولا يقدم تلقائيًا نسبة للفئات التي جرى التنبؤ بها بصورة صحيحة.
توضح مجموعة بيانات التصنيف سبب الحاجة إلى الانتباه: بقراءة Result، نجد 6,539 تسمية Success و 68 تسمية Fail، ويبلغ إجمالي السجلات 6,607. الإجابة دائمًا بـ Success ستعطي قرابة 99% من الإجابات الصحيحة في هذه البيانات، مع الإخفاق في التعرف على أي حالة Fail. يصف هذا الحساب إجابة ثابتة تُطبّق على التسميات المرصودة، ولا يمثل نتيجة تدريب نموذج.
في المهمتين الخاضعتين للإشراف، يجب إجراء التقييم على حالات لم تُستخدم في تدريب النموذج. كما يجب تعلّم إعدادات خطوات التحضير المعتمدة على البيانات من أمثلة التدريب فقط، ثم تطبيق هذه الخطوات على حالات التقييم. فمثلًا، إذا كان ضبط مقاييس القيم يعتمد على إعدادات تُستخلص من البيانات، فيجب استخلاص هذه الإعدادات من مجموعة التدريب فقط. ثم تُحوّل حالات التقييم باستخدام الإعدادات نفسها. يشرح مرجع scikit-learn مشكلة تسرّب البيانات هذه. وتساعد بعد ذلك مقارنة النتيجة بنتيجة طريقة مرجعية بسيطة على تقييم الإضافة الفعلية التي يقدمها النموذج.
تمرين: حدّد المهمة قبل اختيار النموذج
لكل طلب، حدّد المهمة، والمتغير الهدف إن وُجد، واحتياطًا واحدًا يجب مراعاته. يمكنك الإجابة على ورقة؛ فلا حاجة إلى حسابات أو كود.
- يجب أن يقدّر تطبيق درجة امتحان باستخدام المعلومات المتاحة قبل الامتحان.
- يجب أن يتنبأ نموذج آخر ب ـ
SuccessأوFailانطلاقًا من أمثلة تكون فيها قيمResultمعبأة مسبقًا. - يهدف تحليل إلى استكشاف أنماط الدراسة والنوم دون وجود مجموعات مرجعية.
- يريد فريق تقدير درجة، لكنه لا يملك درجات تاريخية. فيقترح استبدال التقدير بثلاث مجموعات.
- للتنبؤ بـ
Resultلحالات جديدة، يقترح شخص تضمين قيمته ضمن المدخلات.
اعرض الإجابات مع الشرح
1. الانحدار. المتغير الهدف هو Exam_Score. تحقّق من أن كل مدخل سيكون معلومًا عندما ينتج التطبيق تقديره، ثم افحص الأخطاء على سجلات خُصصت للتقييم.
2. التصنيف الثنائي. المتغير الهدف هو Result، بتسميتيه المتاحتين Success وFail. افحص الأخطاء في الفئتين، مع مراعاة عدم التوازن في عدديهما.
3. التجميع. لا يُقدَّم متغير هدف يحدد المجموعات. اختر السمات التي ستقارن بينها، ثم افحص معنى المجموعات الناتجة وثباتها. أرقام هذه المجموعات لا ترتّب الطلاب.
4. الحاجة لم تُلبَّ. ثلاث مجموعات لا تمثل درجة مقدّرة. أعد النظر في البيانات المتاحة، أو أعد صياغة الهدف بوضوح، دون تقديم التجميع باعتباره بديلًا مكافئًا.
5. تسرّب البيانات. تقديم Result سيعطي النموذج الإجابة التي يجب عليه التنبؤ بها، والتي ستكون مجهولة للحالة الجديدة. يجب إبقاء المتغير الهدف خارج المدخلات.
مفاهيم خاطئة شائعة ينبغي تجنبها
الاختيار بناءً على اسم الخوارزمية. يُستخدم الانحدار اللوجستي للتصنيف. وقد توفر عائلة من النماذج أيضًا صيغًا مختلفة لعدة مهام. تحقّق دائمًا من المخرج الذي يتعلم النموذج إنتاجه.
الخلط بين التصنيف والترتيب. التنبؤ بفئة لا يعني ترتيب الحالات من الأفضل إلى الأسوأ. وبالمثل، لا يحدد معرّف المجموعة ترتيبًا حسب الاستحقاق.
اعتبار المجموعات حقيقة مكتشفة. تتأثر النتيجة بالمتغيرات المختارة، وإعدادها والطريقة المستخدمة. قد يساعد التجميع على استكشاف البيانات دون أن يثبت وجود فئات طبيعية أو ثابتة.
تحويل التنبؤ إلى تفسير سببي. تقدير درجة انطلاقًا من ساعات الدراسة لا يثبت أثر زيادة هذه الساعات. التنبؤ بإجابة وإثبات سبب يتطلبان نهجين مختلفين.
ما ينبغي تذكّره
عندما تختار الانحدار، التصنيف أو التجميع، فإنك تحدد الإجابة التي تحتاج إليها: كمية، أو فئة محددة، أو مجموعات تستكشفها. تحقّق بعد ذلك من قدرة البيانات على تلبية هذه الحاجة، ومن ملاءمة التقييم للاستخدام المقصود. تظل صياغة المشكلة ضرورية مهما كانت الخوارزمية التي تختارها.
المصادر ومراجع إضافية
- Gareth James، Daniela Witten، Trevor Hastie، Robert Tibshirani وJonathan Taylor، An Introduction to Statistical Learning, with Applications in Python، 2023: القسمان 2.1.4–2.1.5، الصفحات 25–27، حول المهام؛ والقسم 12.4، الصفحتان 520–521، والقسم 12.4.3، الصفحات 532–535، حول التجميع وحدوده.
- Aurélien Géron، Hands-On Machine Learning with Scikit-Learn and PyTorch، الطبعة الأولى، نسخة مؤرخة في 22 أكتوبر 2025: الفصل 1، الصفحات 10–12، حول المهام الخاضعة للإشراف وغير الخاضعة للإشراف؛ والفصل 8، حول التجميع.
- Google for Developers: صياغة مشكلة في تعلّم الآلة، وإعداد البيانات للتجميع.
- scikit-learn: تقييم النماذج، وتقييم التجميع، وتجنب تسرّب البيانات.
- Lai Ng.، Student Performance Factors على Kaggle. جرى التحقق من الأمثلة والأعداد بمقارنتها بالمصنف المحلي
StudentPerformanceFactors.xlsx.
