Régression, classification ou regroupement : quelle tâche choisir
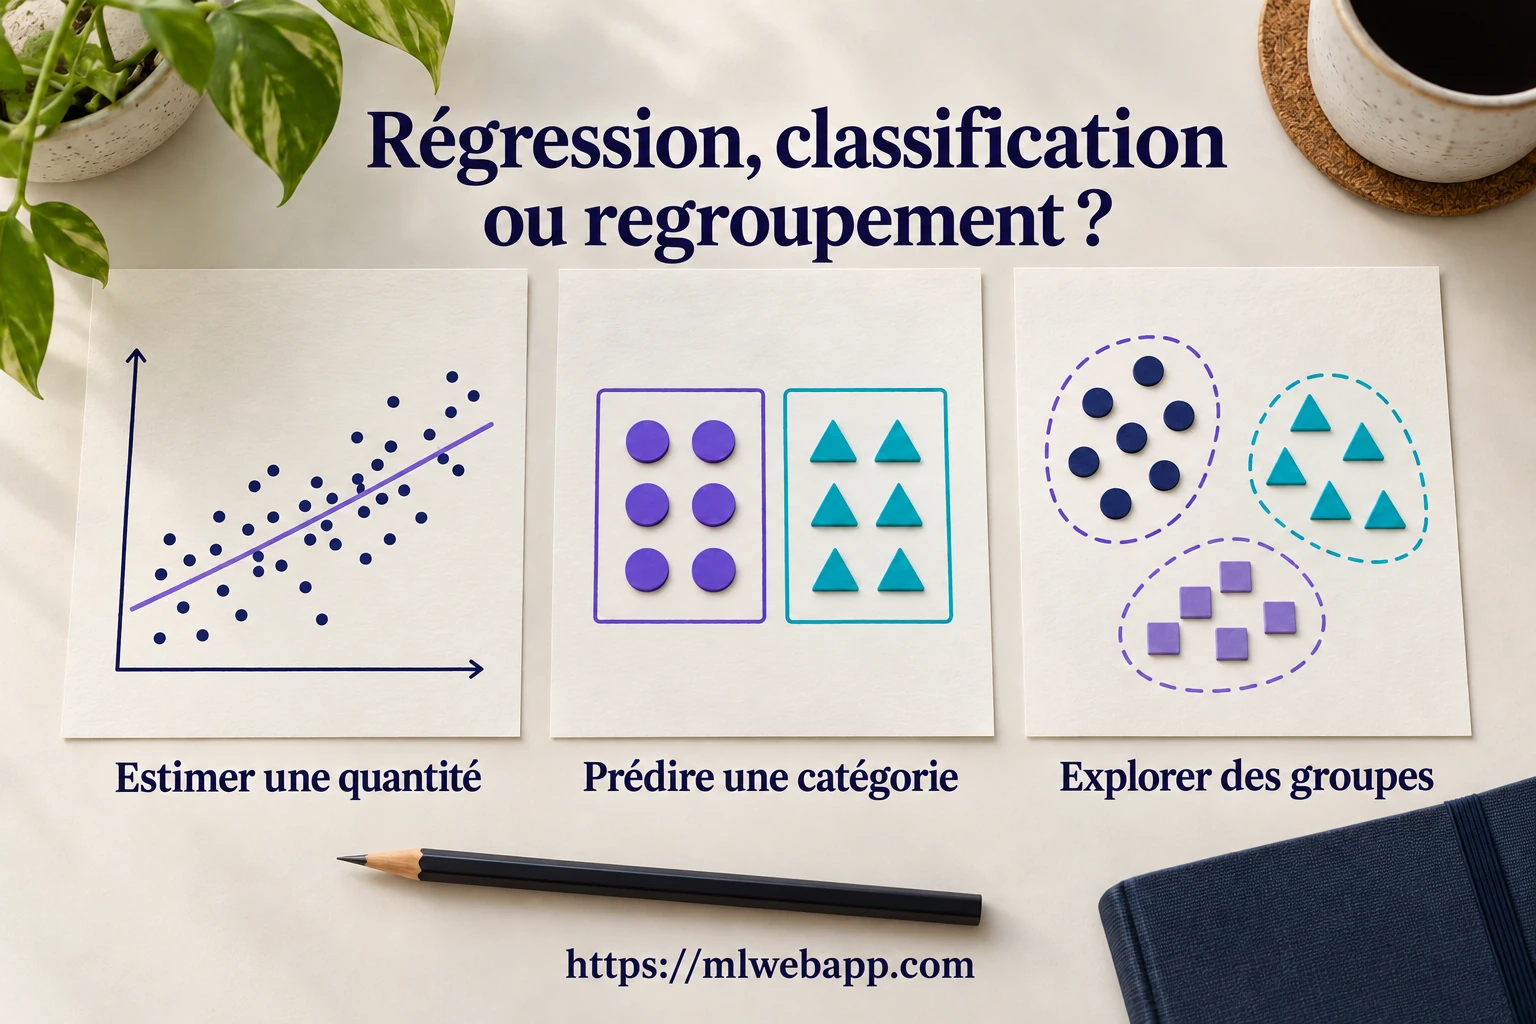
Régression, classification ou regroupement : pour choisir, commencez par la réponse attendue. Voulez-vous estimer une quantité, prévoir une catégorie dont le sens est déjà défini, ou rechercher des groupes d’observations qui se ressemblent ? Ces trois objectifs conduisent à des tâches différentes, même lorsque les données de départ portent sur le même sujet.
Dans la leçon sur l’apprentissage supervisé et non supervisé, vous avez vu le rôle de la cible. Nous allons maintenant utiliser cette distinction pour formuler un problème précis : quelle sortie demander, quelles informations fournir et quelles erreurs examiner. Le choix d’un algorithme vient ensuite.
Avant de commencer. Une observation est une ligne décrivant un cas ; une variable est une information portée par une colonne. Les exemples utilisent les champs du classeur StudentPerformanceFactors.xlsx, préparé à partir du jeu de données Student Performance Factors sur Kaggle.
Sommaire
Régression, classification ou regroupement : les trois réponses possibles
Une tâche de machine learning décrit ce que le système doit apprendre à produire. « Utiliser un arbre de décision » ne suffit pas à la définir : cette méthode peut servir à estimer une quantité ou à prévoir une catégorie. La question utile est plutôt : « Que devra afficher l’application pour un nouveau cas ? » Le guide de cadrage de Google invite ainsi à préciser la sortie avant de choisir le modèle.
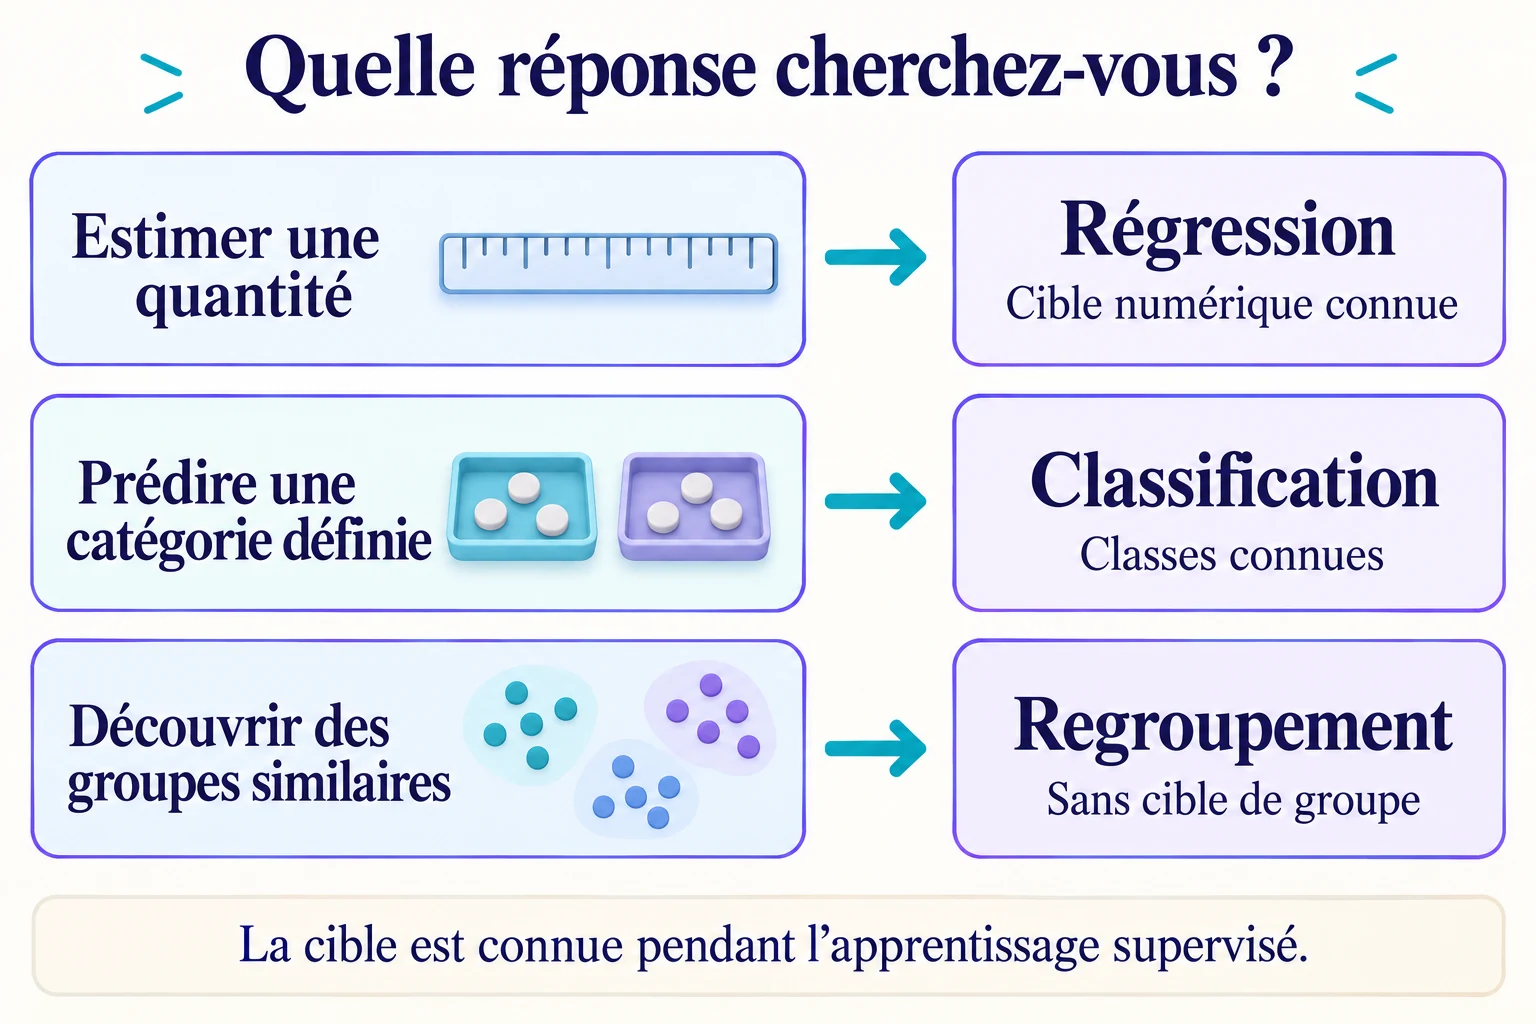
En apprentissage supervisé, les exemples comportent des variables d’entrée et une réponse à apprendre. Cette réponse est la cible, souvent notée y ; les entrées sont souvent notées X. Pendant l’entraînement, elles servent ensemble à ajuster le modèle. Pour prédire un nouveau cas, on fournit seulement les entrées disponibles : la cible recherchée est encore inconnue. La présentation de l’apprentissage supervisé par Google reprend ce fonctionnement.
La régression et la classification appartiennent à ce cadre supervisé. Le regroupement étudié dans cette leçon relève du non supervisé : on cherche une organisation des observations sans fournir la catégorie attendue pour chacune. Il s’agit donc de trois tâches, mais de deux cadres d’apprentissage.
La régression : estimer une quantité
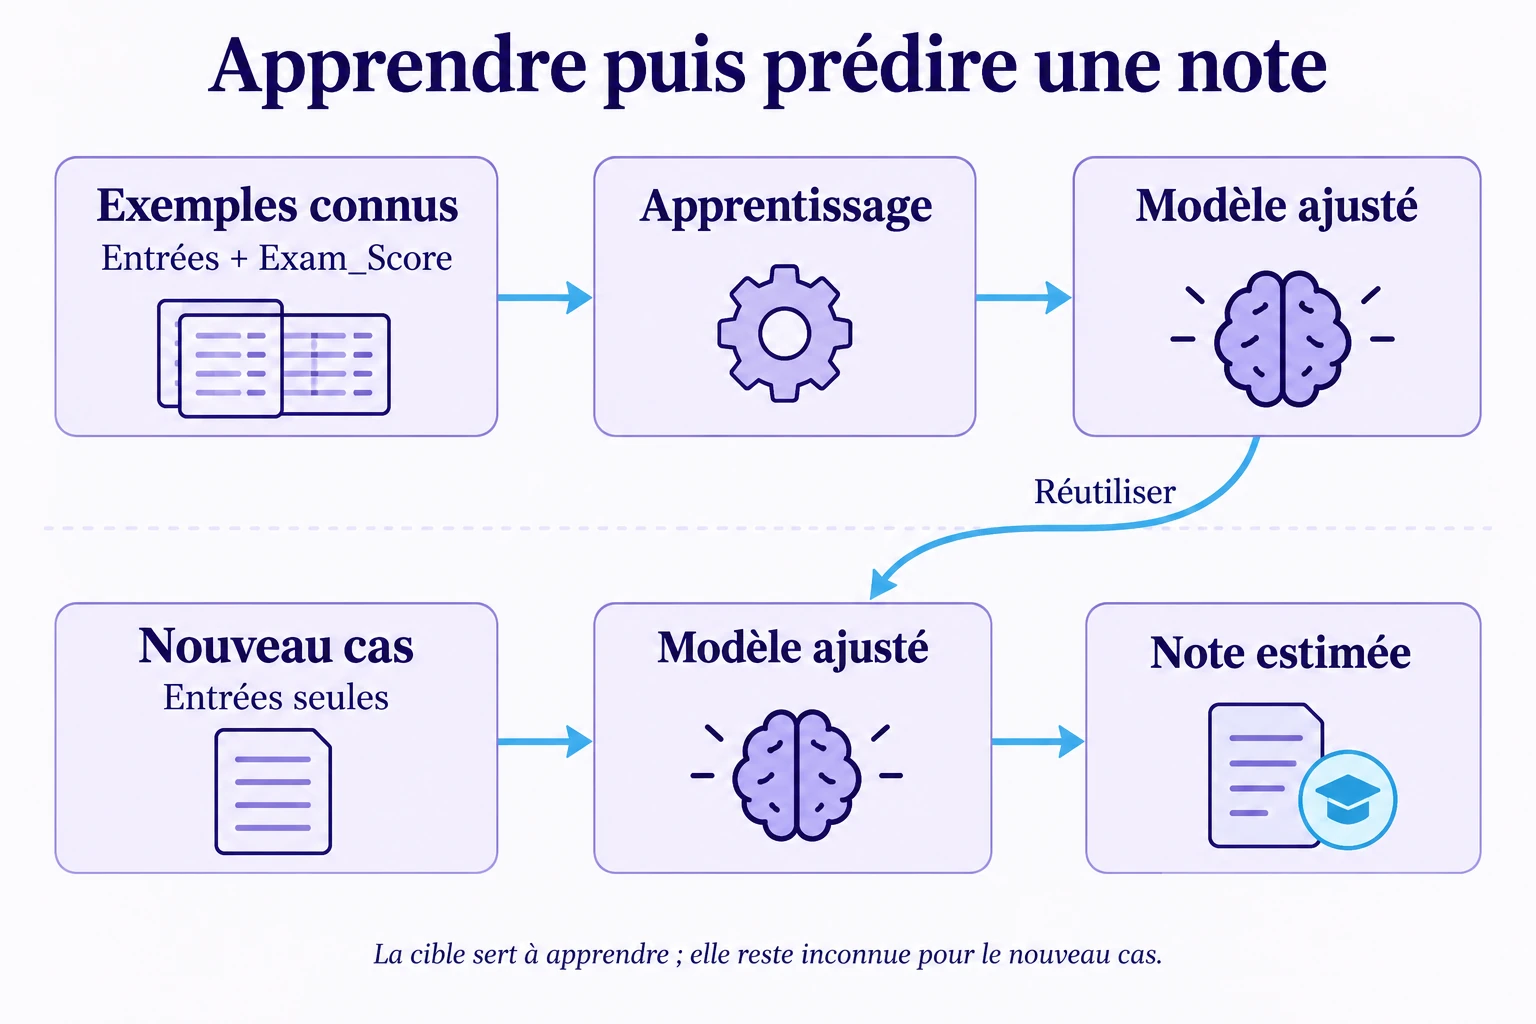
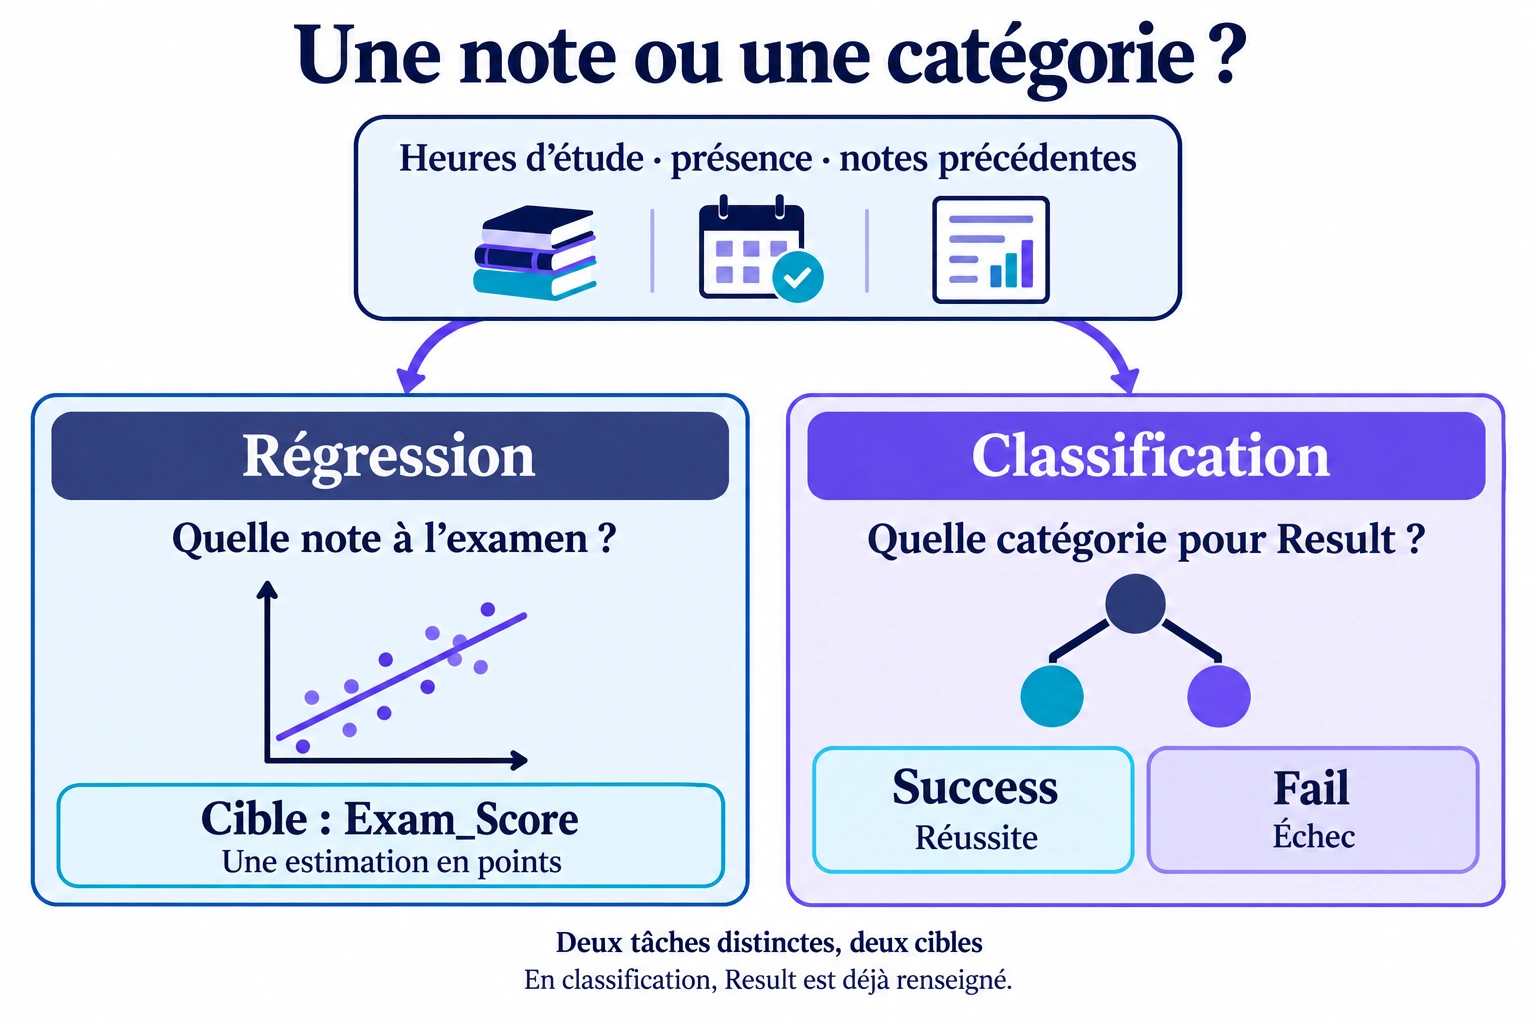
La régression consiste à apprendre à estimer une cible numérique représentant une quantité. Dans notre jeu de régression, cette cible unique est Exam_Score, la note d’examen.
Formulons la demande : « À partir des informations connues avant l’examen, quelle note pourrait-on estimer ? » Parmi les entrées envisageables, Hours_Studied indique les heures d’étude par semaine, Attendance le pourcentage de cours suivis et Previous_Scores les notes aux examens précédents. Leur présence dans le fichier ne garantit pas leur utilité ; elle permet de poser un premier problème à examiner.
| Étude (h/semaine) | Présence (%) | Notes précédentes | Exam_Score |
|---|---|---|---|
| 23 | 84 | 73 | 67 |
| 19 | 64 | 59 | 61 |
| 24 | 98 | 91 | 74 |
Dans la première ligne, 67 est une note déjà observée, pas une prédiction. Le modèle apprendrait à partir de nombreuses lignes de ce type. Une fois entraîné, il pourrait recevoir les entrées d’un nouveau cas et produire une estimation numérique. Cette estimation devrait être évaluée sur d’autres observations dont les notes sont connues et qui ont été réservées à cette vérification.
Le stockage de Exam_Score sous forme d’entiers ne transforme pas ce problème en classification. On cherche une quantité, et une estimation peut comporter des décimales. Une régression ne se limite pas non plus à tracer une droite : plusieurs familles de modèles peuvent estimer la même cible numérique.
La classification : prévoir une catégorie définie
La classification consiste à apprendre à prévoir une catégorie, appelée classe, parmi celles définies pour le problème. Dans un jeu de classification distinct, la cible unique est Result. Elle est déjà renseignée avec Success (réussite) ou Fail (échec).
| Étude (h/semaine) | Présence (%) | Notes précédentes | Result |
|---|---|---|---|
| 23 | 84 | 73 | Success |
| 19 | 64 | 59 | Success |
| 24 | 98 | 91 | Success |
| 13 | 69 | 68 | Fail |
La demande devient : « Quelle valeur de Result prévoir pour une nouvelle observation ? » Les entrées décrivent ce nouveau cas ; la catégorie correspondante reste à estimer. La classification est ici binaire, car elle comporte deux classes. Avec plus de deux classes, on parle de classification multiclasse.
Les nombres présents dans les entrées ne changent pas cette tâche. Les heures d’étude et le taux de présence peuvent servir à une classification. De même, si les classes sont représentées par des codes numériques, ces codes désignent toujours des catégories : ils ne transforment pas la cible en quantité à estimer.
Certains modèles estiment une probabilité d’appartenance à une classe. Une règle de décision permet ensuite d’annoncer une catégorie. La sortie intermédiaire est numérique, mais elle concerne une classe : cela reste un problème de classification. La régression logistique est justement utilisée pour cette tâche malgré son nom. Une probabilité estimée doit elle aussi être évaluée ; elle n’est pas une certitude sur un cas individuel.
Le regroupement : explorer des observations proches
Le regroupement, aussi appelé clustering, recherche des groupes d’observations similaires sans recevoir une cible donnant le groupe attendu pour chacune. La similarité désigne ici la ressemblance selon les caractéristiques et la manière de les comparer.
Pour nos données, on peut demander : « Quelles observations ont des profils proches selon les heures d’étude, la présence et le sommeil ? » L’analyse utilise alors Hours_Studied, Attendance et Sleep_Hours, qui indique les heures de sommeil par nuit. Aucun groupe n’est fourni comme réponse à reproduire. Si des groupes sont constitués, on les décrira ensuite à partir de ces caractéristiques.
Le mot « proche » exige un choix. Une heure d’étude et un point de pourcentage de présence n’ont pas la même unité. Pour une méthode fondée sur les distances, laisser les valeurs brutes ou modifier leur échelle peut changer les observations jugées voisines. La préparation des données pour le clustering fait donc partie du raisonnement. Elle doit correspondre à la question étudiée.

Le nombre de groupes dépend aussi de la méthode. Avec k-means, par exemple, on choisit à l’avance un nombre de groupes, noté k. L’algorithme cherche ensuite une répartition des observations en groupes adaptée à son critère de proximité. Demander trois groupes ne prouve pas qu’il existe trois catégories naturelles d’élèves : le nombre demandé est un réglage de l’analyse.
Un numéro de groupe sert uniquement à identifier un ensemble. Le groupe 2 n’est pas meilleur que le groupe 1. Des groupes constitués à partir des habitudes d’étude ne suffisent pas à conclure sur la réussite scolaire, ni à prescrire une intervention. Avant d’interpréter le résultat, il faut examiner les caractéristiques des groupes et leur stabilité lorsque l’analyse change.
Choisir la tâche en cinq questions
Pour choisir entre régression, classification ou regroupement, rédigez une courte fiche avant de chercher un algorithme. Elle doit permettre à une autre personne de comprendre ce que le système produira et pourquoi les données disponibles conviennent à ce besoin.
- Quelle réponse sera utile ? Écrivez ce que l’application devra afficher : une estimation en points, une catégorie de
Result, ou une description des groupes trouvés. - La sortie décrit-elle une quantité, une classe définie ou des groupes à découvrir ? Examinez son sens, pas seulement son type informatique. Un entier peut mesurer une quantité ou servir de code de classe.
- Quelles réponses historiques sont disponibles ? Pour les tâches supervisées présentées ici, les exemples d’apprentissage doivent contenir la cible correspondante. Pour explorer des ressemblances, précisez plutôt les caractéristiques à comparer.
- Quand la réponse doit-elle être produite ? Les entrées doivent être disponibles à cet instant. Une présence calculée sur toute une période ne convient pas forcément à une prédiction faite au début de cette période.
- Comment reconnaître un résultat utile ? Précisez les erreurs gênantes et le contrôle prévu. Un écart en points, une catégorie erronée et un groupe difficile à interpréter demandent des vérifications différentes.
Dans le projet d’application, la réponse souhaitée est une note estimée. Le choix retenu est donc une régression avec Exam_Score comme seule cible. Il reste à choisir le modèle et ses réglages. Le jeu de classification et l’exploration des profils restent deux problèmes séparés, avec leurs propres objectifs.
Prévoir une évaluation adaptée à la tâche
Une métrique est une mesure qui résume un aspect du résultat. On la choisit en fonction de la tâche et de l’usage. Le choix de la tâche prépare ainsi le choix de l’évaluation ; il ne suffit pas, à lui seul, à garantir des prédictions utiles.
- En régression, examiner les écarts. On compare les valeurs estimées aux valeurs observées. L’erreur absolue moyenne, ou MAE, est la moyenne des écarts absolus entre les valeurs prédites et les valeurs observées, sans tenir compte du signe des écarts. Pour une note, elle s’exprime en points. Certaines erreurs peuvent dépasser cette moyenne.
- En classification, examiner les erreurs de catégorie. Une matrice de confusion croise classes observées et classes prédites. Elle aide à voir quelles catégories sont confondues. La proportion globale de bonnes réponses, appelée accuracy, peut masquer de mauvais résultats sur une classe peu représentée.
- En regroupement, examiner la structure obtenue. On étudie notamment si les membres d’un groupe sont proches et si les groupes sont séparés, selon la comparaison choisie. Cette évaluation doit aussi porter sur le sens des groupes et leur stabilité ; elle ne fournit pas automatiquement un taux de bonnes catégories.
Le jeu de classification illustre cette prudence : la lecture de Result donne 6 539 Success et 68 Fail, pour 6 607 observations. Répondre toujours Success donnerait près de 99 % de bonnes réponses sur cet ensemble tout en manquant tous les Fail. Ce calcul décrit une réponse constante sur les étiquettes observées ; il ne représente pas le résultat d’un entraînement.
Pour les deux tâches supervisées, l’évaluation doit porter sur des cas qui n’ont pas servi à ajuster le modèle. Les étapes de préparation qui apprennent à partir des données doivent elles aussi être ajustées uniquement sur les exemples d’entraînement, puis appliquées aux cas d’évaluation. La documentation de scikit-learn décrit ces fuites de données. Comparer un résultat à une réponse simple de référence aide ensuite à juger l’apport réel du modèle.
Mise en pratique : formuler la tâche avant le modèle
Pour chaque demande, indiquez la tâche, la cible éventuelle et une précaution. Vous pouvez répondre sur papier ; aucun calcul ni code n’est nécessaire.
- Une application doit estimer la note d’examen à partir d’informations disponibles avant l’examen.
- Un autre modèle doit prévoir
SuccessouFailà partir d’exemples dontResultest déjà renseigné. - Une analyse doit explorer les profils d’étude et de sommeil sans disposer de groupes de référence.
- Une équipe veut estimer une note, mais ne possède aucune note historique. Elle propose de remplacer cette estimation par trois groupes.
- Pour prévoir
Resultpour de nouveaux cas, on propose de fournir sa valeur parmi les entrées.
Voir la correction expliquée
1. Régression. La cible est Exam_Score. Il faut vérifier que chaque entrée sera connue au moment où l’application produira son estimation, puis examiner les écarts sur des observations réservées à l’évaluation.
2. Classification binaire. La cible est Result, avec ses étiquettes fournies Success et Fail. Il faut examiner les erreurs pour les deux classes, compte tenu du déséquilibre de leurs effectifs.
3. Regroupement. Aucune cible de groupe n’est fournie. On choisit les caractéristiques à comparer, puis on examine le sens et la stabilité des groupes obtenus. Leurs numéros ne constituent pas un classement des élèves.
4. Le besoin n’est pas satisfait. Trois groupes ne sont pas une estimation de note. Il faut revoir les données disponibles ou reformuler explicitement l’objectif, sans présenter le regroupement comme un remplacement équivalent.
5. Fuite de données. Fournir Result donnerait la réponse que le modèle doit prévoir et qui sera inconnue pour le nouveau cas. La cible doit rester hors des entrées.
Les confusions à éviter
Choisir à partir du nom de l’algorithme. La régression logistique est utilisée pour la classification. Une famille de modèles peut aussi proposer des variantes pour plusieurs tâches. Vérifiez toujours la sortie que le modèle apprend à produire.
Assimiler classification et classement. Prévoir une catégorie n’implique pas de ranger les observations de la meilleure à la moins bonne. De même, un identifiant de groupe ne donne aucun ordre de mérite.
Prendre les groupes pour une vérité découverte. Les variables retenues, leur préparation et la méthode contribuent au résultat. Un regroupement peut aider à explorer des données sans établir l’existence de catégories naturelles ou stables.
Transformer une prédiction en explication causale. Estimer une note à partir des heures d’étude ne démontre pas l’effet d’une augmentation de ces heures. La capacité à prévoir une réponse et la preuve d’une cause demandent des démarches différentes.
À retenir
Choisir entre régression, classification ou regroupement revient à préciser la réponse recherchée : une quantité, une catégorie définie ou des groupes à explorer. Vérifiez ensuite que les données permettent de traiter ce besoin et que l’évaluation correspond à l’usage. Cette formulation du problème reste nécessaire quel que soit l’algorithme retenu.
Sources et lectures complémentaires
- Gareth James, Daniela Witten, Trevor Hastie, Robert Tibshirani et Jonathan Taylor, An Introduction to Statistical Learning, with Applications in Python, 2023 : § 2.1.4–2.1.5, p. 25–27, pour les tâches ; § 12.4, p. 520–521, et § 12.4.3, p. 532–535, pour le regroupement et ses limites.
- Aurélien Géron, Hands-On Machine Learning with Scikit-Learn and PyTorch, première édition, version du 22 octobre 2025 : chapitre 1, p. 10–12, sur les tâches supervisées et non supervisées ; chapitre 8, sur le regroupement.
- Google for Developers : formuler un problème de machine learning et préparer les données pour le clustering.
- scikit-learn : évaluer les modèles, évaluer un regroupement et éviter les fuites de données.
- Lai Ng., Student Performance Factors, Kaggle. Les exemples et les effectifs ont été vérifiés dans le classeur local
StudentPerformanceFactors.xlsx.
