Apprentissage semi-supervisé et auto-supervisé : quel rôle pour les étiquettes ?

L’apprentissage semi-supervisé utilise à la fois des exemples dont la réponse est fournie et des exemples sans cette réponse. L’apprentissage auto-supervisé construit un objectif à partir des données elles-mêmes : retrouver une valeur que l’on a masquée, par exemple. La différence porte sur l’origine des réponses utilisées pendant l’apprentissage. Ces approches peuvent se combiner pour exploiter des données dont les étiquettes sont peu nombreuses.
Le choix entre régression, classification et regroupement précise la tâche à accomplir. Il reste à examiner les données disponibles : comment apprendre si l’on connaît les caractéristiques des observations, mais que la réponse attendue manque pour une partie d’entre elles ? Vous allez distinguer les étiquettes fournies, les prédictions réutilisées et les réponses construites à partir des entrées, puis prévoir une évaluation adaptée.
Avant de commencer. Une observation correspond à une ligne ; ses caractéristiques sont les informations qui la décrivent. La cible est la réponse que le modèle doit apprendre à prévoir. Vous pouvez revoir le rôle de la cible en apprentissage supervisé et non supervisé. Les exemples reprennent les champs du jeu Student Performance Factors utilisé dans le parcours.
Sommaire
Étiquette et signal d’apprentissage : deux repères
Une étiquette est une réponse de référence associée à un exemple pour une tâche donnée. Dans le jeu de classification du parcours, Result est le nom de la cible ; Success ou Fail est l’étiquette portée par une ligne. Le mot « étiquette » ne désigne donc pas simplement le nom d’une colonne.
En régression, la réponse de référence est une valeur numérique, souvent appelée valeur cible. Le jeu de régression du projet utilise uniquement Exam_Score comme cible. La question des réponses disponibles concerne donc aussi la prévision d’une quantité.
Les paramètres sont les valeurs que le modèle ajuste pendant son apprentissage. Le signal d’apprentissage est l’information qui guide ces ajustements. En apprentissage supervisé, on compare les prédictions aux réponses fournies. Ces réponses peuvent provenir d’une mesure, d’un enregistrement ou d’une annotation ; elles ne sont pas nécessairement saisies une par une par une personne. Leur qualité et leur pertinence restent à vérifier.
« Sans étiquette » s’entend toujours par rapport à la tâche étudiée. Une ligne peut renseigner les heures d’étude et la présence sans fournir la catégorie à prévoir. Elle n’est pas vide pour autant. Une valeur manquante dans une entrée, comme les heures de sommeil, pose une autre question : quelles informations le modèle reçoit-il pour décrire ce cas ?
L’apprentissage semi-supervisé : des exemples avec et sans étiquette
L’apprentissage semi-supervisé combine des observations étiquetées et non étiquetées pour apprendre la tâche visée. Les premières fournissent des réponses de référence ; les secondes peuvent aider à exploiter les ressemblances entre les observations. La documentation de scikit-learn sur le semi-supervisé présente ce cadre et précise que son intérêt dépend d’hypothèses sur les données. Une méthode fondée sur les voisinages peut, par exemple, supposer que des observations proches ont souvent la même catégorie. Cette hypothèse n’est pas garantie par leur seule ressemblance.
Prenons le jeu de classification, dont la cible unique est Result, déjà remplie avec Success ou Fail. Pour comprendre le raisonnement, supposons que l’entraînement n’ait accès qu’à une partie de ces étiquettes. Les autres lignes restent disponibles avec leurs entrées, mais leur réponse est tenue à l’écart de l’apprentissage. Il s’agit d’une situation à étudier sur une copie de travail ; on ne modifie pas les données de référence.
Masquer des étiquettes déjà connues permet de simuler leur indisponibilité pour l’entraînement. Dans une situation réelle, certaines réponses peuvent arriver plus tard que les entrées ou demander une vérification supplémentaire. L’intérêt pratique dépend de ces réponses manquantes, de la qualité des étiquettes accessibles et de ce que les autres observations apportent au modèle. La simulation aide à étudier une méthode ; elle ne représente pas une économie d’annotation déjà réalisée sur ce fichier.
Une méthode possible est le pseudo-étiquetage : un premier modèle propose des catégories pour des observations sans étiquette accessible. Certaines propositions sont ensuite utilisées comme réponses provisoires pendant l’entraînement. Le self-training répète ce principe : apprendre sur les exemples disponibles, sélectionner des prédictions, puis réentraîner le modèle avec ces informations supplémentaires.
Une autre idée consiste à demander des prédictions cohérentes lorsque l’entrée subit une modification qui doit préserver sa catégorie. On parle de régularisation par cohérence : on ajoute une contrainte à l’entraînement pour limiter les variations injustifiées. FixMatch, proposé par Sohn et ses coauteurs, combine cette idée au pseudo-étiquetage. La transformation autorisée dépend du domaine ; changer une donnée scolaire au hasard ne garantit pas que le sens du cas reste le même.
Le semi-supervisé ne se réduit donc pas au pseudo-étiquetage. Certaines méthodes utilisent les relations de voisinage entre observations ; d’autres imposent une cohérence des prédictions. Dans tous les cas, la question reste la même : l’information apportée par les exemples sans étiquette aide-t-elle réellement à apprendre la cible ?
L’apprentissage auto-supervisé : construire une tâche à partir des données
L’apprentissage auto-supervisé construit un objectif d’entraînement à partir d’informations déjà présentes dans les données. Il n’exige pas, pour cette étape, d’étiquettes fournies pour la tâche finale. La définition de la CNIL insiste sur la construction de tâches de supervision à partir des données elles-mêmes.
Reprenons uniquement les entrées d’une observation du parcours : Hours_Studied = 23, Attendance = 84 et Sleep_Hours = 7. On peut cacher temporairement la valeur de Sleep_Hours, puis demander au modèle de la reconstruire à partir des informations visibles. La réponse de référence, 7, était connue avant le masquage ; elle n’a pas été inventée par le modèle. Pendant l’entraînement, la reconstruction proposée est comparée à la valeur conservée : l’écart sert à ajuster les paramètres du modèle.
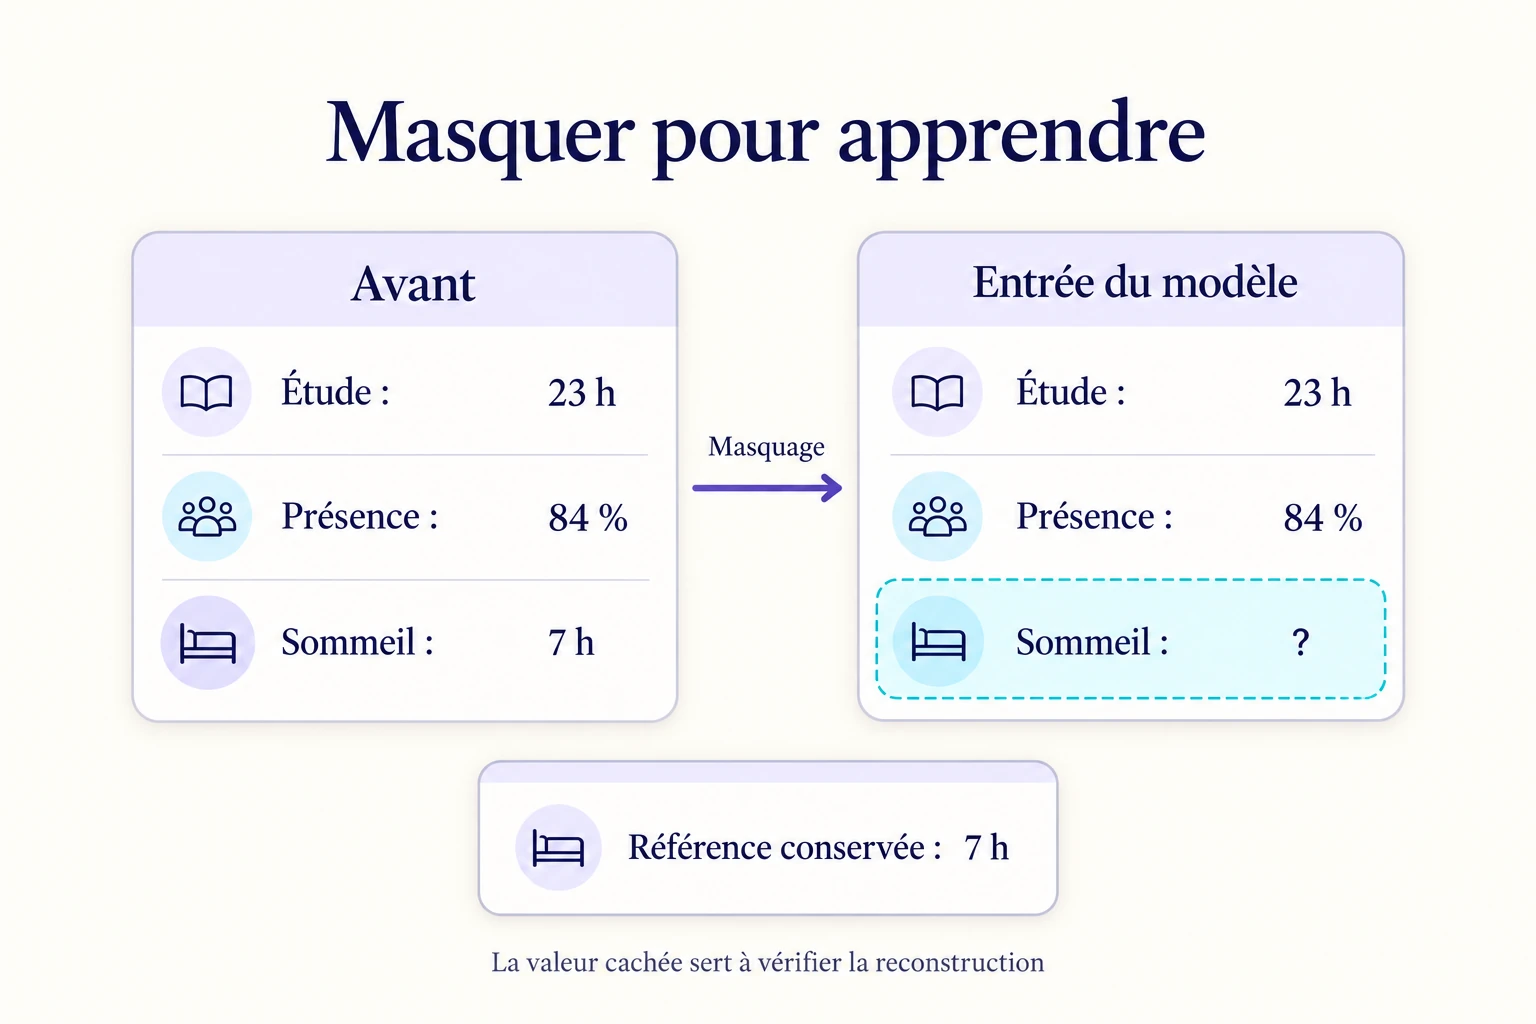
Cette reconstruction constitue une tâche auxiliaire, parfois appelée tâche prétexte : on l’utilise pour apprendre une représentation des données. Une représentation apprise est un ensemble de valeurs numériques calculées à partir des entrées par une transformation que le modèle apprend pendant l’entraînement. Dans notre exemple, elle décrit une observation sous une autre forme que les colonnes initiales. Elle peut conserver des régularités utiles pour une autre tâche, mais cette utilité doit être vérifiée.
Pour les données tabulaires, c’est-à-dire organisées en lignes et en colonnes, les travaux VIME de Yoon et ses coauteurs étudient notamment la reconstruction de valeurs et l’identification de champs altérés. Cet exemple montre que l’auto-supervision peut s’appliquer à ce format.
Le masquage n’est qu’un objectif possible. L’apprentissage contrastif apprend des représentations en rapprochant celles d’exemples que l’on souhaite associer et en éloignant celles d’exemples que l’on souhaite distinguer. Dans une méthode auto-supervisée courante, on forme une paire à rapprocher à partir de deux versions d’une même observation. La synthèse de Liu et ses coauteurs décrit plusieurs familles d’objectifs auto-supervisés. Le choix de ce qui doit être préservé dans une représentation fait ainsi partie de la conception de l’apprentissage.
Comparer les approches et leurs usages
La comparaison entre semi-supervisé et auto-supervisé repose sur l’origine du signal et sur l’étape considérée. Le premier décrit l’utilisation conjointe d’exemples avec et sans étiquettes pour la tâche visée. Le second décrit la façon de construire un objectif d’entraînement à partir des données. Un même système peut combiner les deux.
| Approche | Réponse utilisée pour apprendre | Rôle des données |
|---|---|---|
| Supervisé | La cible est fournie pour les exemples d’apprentissage. | Apprendre directement la relation entre entrées et cible. |
| Semi-supervisé | La cible est fournie pour une partie des exemples. | Utiliser aussi les exemples sans cible accessible pour apprendre la tâche. |
| Auto-supervisé | L’objectif est construit à partir des données elles-mêmes. | Apprendre une représentation, par exemple en reconstruisant une entrée masquée. |
| Regroupement non supervisé | Aucune catégorie de référence n’est fournie. | Explorer des groupes selon les caractéristiques retenues. |

Le classement de l’auto-supervision varie selon les auteurs. Certains la rattachent au non supervisé parce qu’elle n’exige pas d’annotations externes pour son objectif initial. Géron la présente comme une catégorie distincte, car l’entraînement utilise tout de même des cibles construites à partir des données (chapitre 1, p. 16). Pour comprendre une méthode, précisez toujours quelles réponses servent à apprendre et à quelle étape.
Quand les données sans étiquette peuvent-elles aider ?
Disposer de davantage de lignes ne garantit pas un meilleur modèle. Pour que le semi-supervisé soit utile, les observations sans étiquette doivent apporter une information pertinente pour les cas que l’on souhaite traiter. Si elles décrivent des situations très différentes, les régularités apprises peuvent orienter le modèle dans une mauvaise direction.
Dans notre exemple de classification, les observations étiquetées doivent permettre au modèle d’apprendre à reconnaître les deux catégories. Cela n’impose pas des effectifs identiques pour chaque classe. Si les exemples de Fail sont rares ou absents, le modèle risque de favoriser Success. Ses pseudo-étiquettes peuvent alors renforcer ce déséquilibre. Il faut examiner les erreurs par catégorie, et pas seulement la proportion globale de bonnes réponses.
Pour l’auto-supervisé, la difficulté se déplace vers la pertinence de la tâche auxiliaire. Reconstruire les heures de sommeil peut aider à apprendre certaines relations entre les entrées. Cela ne prouve pas que la représentation sera utile pour prévoir une catégorie ou une note. Une tâche trop facile peut être résolue sans apprendre les relations qui comptent pour l’usage final.
Dans le projet de régression, les réponses historiques sont disponibles. Une démarche raisonnable consiste d’abord à établir une référence supervisée et à mesurer ses erreurs. Envisager un préentraînement plus complexe demande ensuite un motif précis et une comparaison dans les mêmes conditions. Le nom d’une méthode ne justifie pas à lui seul son ajout à l’application.
Évaluer la tâche finale sur des réponses de référence
La tâche finale est celle dont le résultat sera utilisé. Reconstruire correctement une entrée masquée et prévoir correctement Result sont deux objectifs différents. L’erreur de reconstruction renseigne sur la tâche auxiliaire ; elle ne mesure pas directement la qualité du classifieur final.
La généralisation est la capacité du modèle à traiter de nouvelles observations, au-delà de celles utilisées pour l’entraîner. Pour l’évaluer, on constitue un jeu de test avant de préparer les données et d’entraîner les modèles. Ses observations ne servent ni au préentraînement auto-supervisé, ni au pseudo-étiquetage, ni au choix des réglages. Leurs réponses restent cachées jusqu’à l’évaluation finale. Cette séparation aide à prévenir les fuites de données décrites par scikit-learn : des informations réservées à l’évaluation influenceraient alors la construction du modèle.
Le jeu de validation sert à comparer les choix pendant le développement : méthode, quantité de pseudo-étiquettes retenues ou réglages du modèle, par exemple. Le jeu de test sert ensuite à mesurer le résultat du système retenu. Si l’on consulte sans cesse le test pour choisir une variante, il finit par influencer les décisions. Il ne joue alors plus le rôle d’une vérification finale tenue à l’écart.
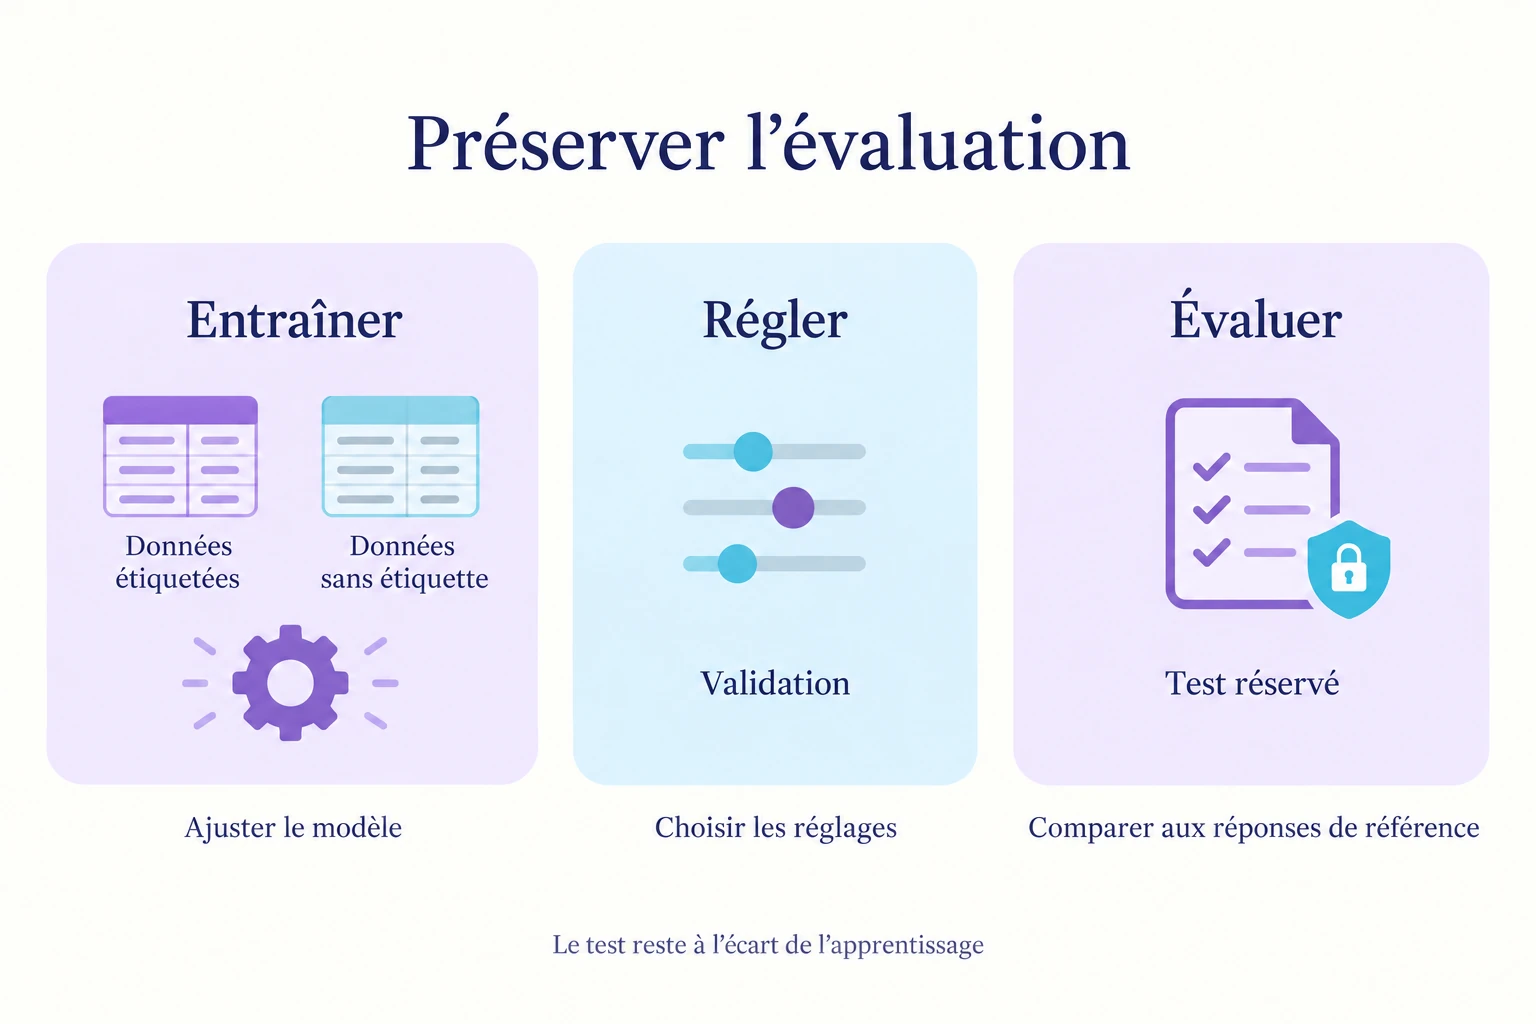
Certains protocoles, dits transductifs, utilisent les entrées des cas dont on veut prévoir les étiquettes, tout en gardant ces étiquettes cachées. Ils visent à compléter les réponses de cet ensemble précis, plutôt qu’à évaluer le traitement de cas entièrement nouveaux. Le protocole doit donc être précisé pour comparer les méthodes dans les mêmes conditions. Dans le parcours, nous retenons ici l’évaluation sur de nouveaux cas.
Pour juger l’apport d’une méthode semi-supervisée, comparez-la à un modèle supervisé entraîné sur les mêmes exemples étiquetés. Pour juger une représentation auto-supervisée, examinez le résultat de la tâche finale avec et sans ce préentraînement. Dans le jeu de classification, les étiquettes de référence sont celles fournies dans Result : les remplacer par les réponses du modèle fausserait la comparaison.
Mise en pratique : retrouver l’origine du signal
Pour chaque proposition, indiquez le cadre d’apprentissage, l’origine de la réponse de comparaison et une précaution. Vous pouvez répondre sur papier.
- Un modèle apprend à prévoir
Resultà partir des seules observations dont l’étiquette lui est fournie. - On utilise les mêmes observations étiquetées, puis on ajoute d’autres lignes avec leurs entrées et les catégories provisoires proposées par un premier modèle.
- On cache
Sleep_Hoursdans certaines entrées, puis on compare la reconstruction à la valeur connue avant le masquage. - Après ce préentraînement sur les entrées, on adapte le modèle à la classification avec les étiquettes fournies dans
Result. - On mesure la qualité finale en comparant les prédictions aux pseudo-étiquettes produites par ce même modèle.
Voir la correction expliquée
- Supervisé. La réponse de comparaison est l’étiquette fournie dans
Result. L’apprentissage n’exploite pas ici d’exemples supplémentaires sans étiquette. - Semi-supervisé par pseudo-étiquetage. Certaines réponses sont fournies ; les autres sont des prédictions provisoires. Il faut contrôler leur sélection et le risque de renforcer les erreurs initiales.
- Auto-supervisé. La réponse vient de l’entrée originale, avant son masquage. Elle est connue pour l’exercice de reconstruction, sans étiquette externe de classification.
- Préentraînement auto-supervisé, puis adaptation supervisée. Les deux phases ont des objectifs distincts. Le résultat utile se mesure sur la classification finale, avec des étiquettes réservées.
- Évaluation insuffisante. L’accord avec ses propres pseudo-étiquettes ne démontre pas que le modèle prévoit les bonnes catégories. Il faut des réponses de référence tenues à l’écart de l’entraînement.
Les confusions à éviter
Confondre self-training et self-supervised learning. Le premier nom désigne ici une procédure semi-supervisée qui réutilise des prédictions comme pseudo-étiquettes. Le second désigne l’auto-supervision, dont l’objectif est construit à partir des données. Leur ressemblance en anglais ne les rend pas interchangeables.
Comprendre « auto » comme une absence de choix humains. Une personne choisit les données, la tâche auxiliaire, les transformations et les conditions d’évaluation. Le modèle ajuste ses paramètres selon cet objectif ; il ne décide pas seul de ce qui sera utile dans l’application.
Confondre masquage et données réellement manquantes. Pour vérifier une reconstruction, la valeur cachée doit être connue avant l’exercice. Une cellule vide dans le fichier ne fournit pas cette référence. On ne peut pas mesurer l’erreur sur une valeur que l’on n’a jamais observée.
À retenir
Le semi-supervisé exploite des étiquettes fournies pour une partie des exemples et les informations présentes dans d’autres observations. L’auto-supervisé construit une tâche d’apprentissage à partir des données elles-mêmes. Les deux peuvent se combiner ; leur intérêt se juge sur une tâche finale et une évaluation clairement définies.
Sources et lectures complémentaires
Aurélien Géron, Hands-On Machine Learning with Scikit-Learn and PyTorch, première édition, octobre 2025, version du 22 octobre 2025 : chapitre 1, p. 14–16 et 35–37 ; chapitre 8, p. 264 ; chapitre 11, p. 383–388 ; chapitre 16, p. 670–671. Ces passages présentent les cadres d’apprentissage, le self-training, le préentraînement, l’adaptation et l’apprentissage contrastif.
- scikit-learn, apprentissage semi-supervisé : cadre général, self-training et propagation des étiquettes ; prévention des fuites de données.
- CNIL, définition de l’apprentissage auto-supervisé.
- Kihyuk Sohn et ses coauteurs, FixMatch: Simplifying Semi-Supervised Learning with Consistency and Confidence, NeurIPS, 2020.
- Jinsung Yoon, Yao Zhang, James Jordon et Mihaela van der Schaar, VIME: Extending the Success of Self- and Semi-supervised Learning to Tabular Domain, NeurIPS, 2020.
- Xiao Liu et ses coauteurs, Self-supervised Learning: Generative or Contrastive, version de synthèse de 2021.
- Student Performance Factors, Kaggle : source du jeu repris dans le parcours. Les noms de champs et les valeurs utilisés dans l’exemple ont été vérifiés dans le classeur local.
