التعلّم الخاضع للإشراف وغير الخاضع للإشراف: دور المتغير الهدف
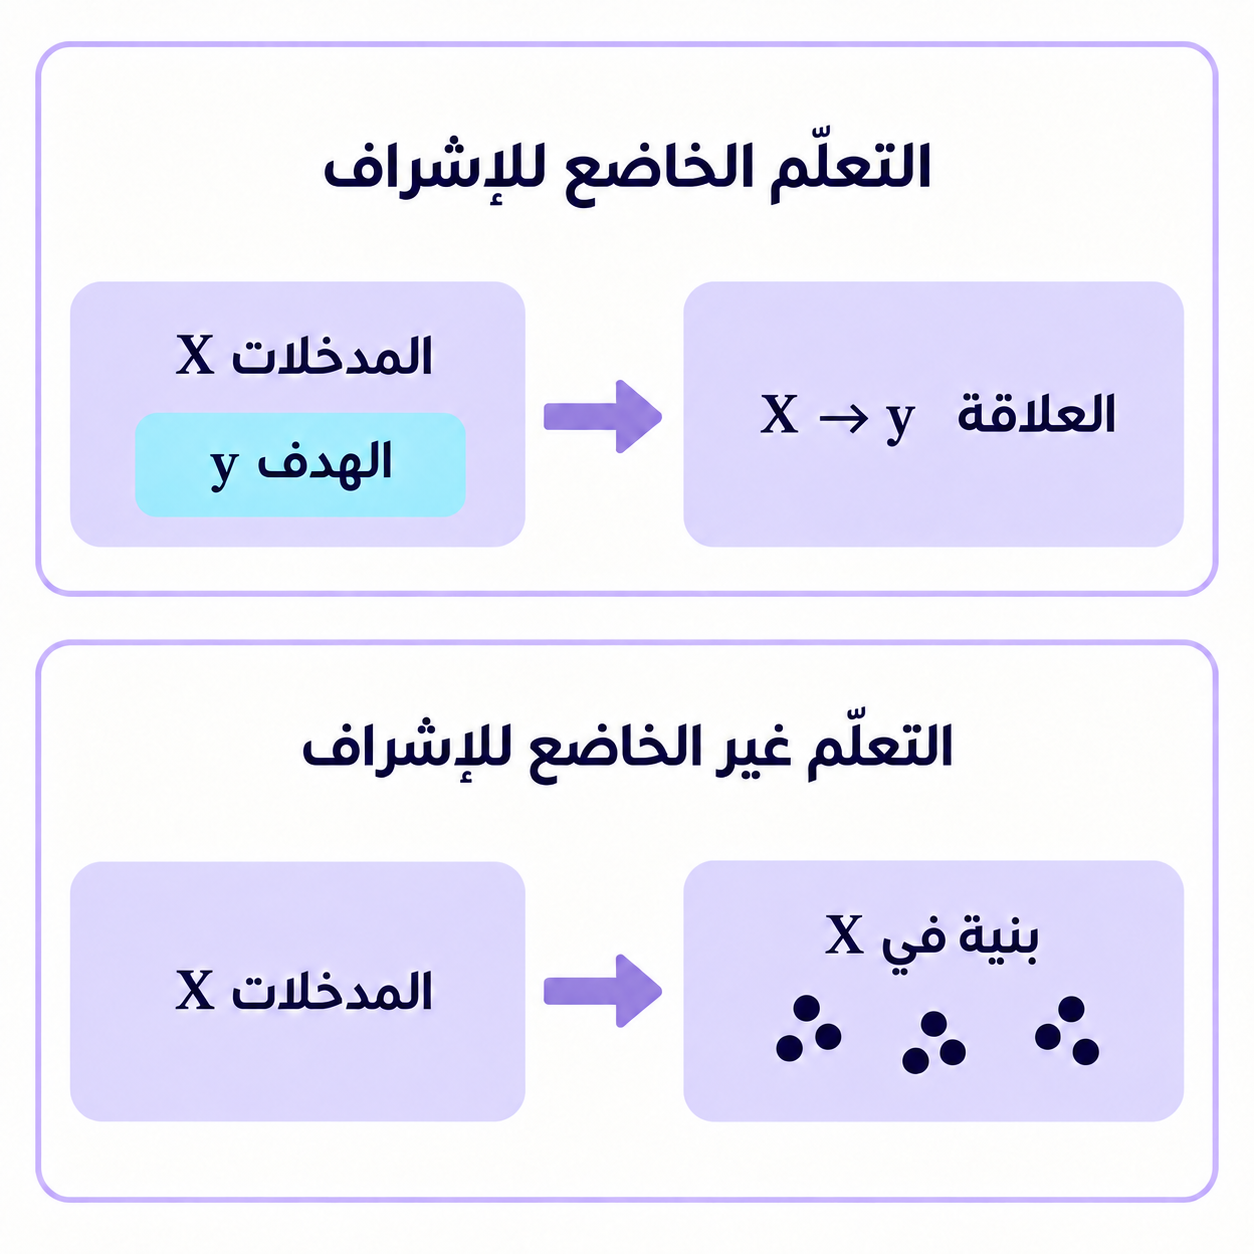
يرتبط الفرق بين التعلّم الخاضع للإشراف وغير الخاضع للإشراف بالمعلومات التي توجّه عملية التعلّم. في الحالة الأولى، يصاحب كل مثال يُستخدم في التدريب جواب معروف: هو قيمة المتغير الهدف، أي المتغير الذي تريد التنبؤ بقيمته. أمّا في الحالة الثانية، فلا تُقدَّم قيم للمتغير الهدف لتوجيه هذا التحليل، بل تبحث الطريقة عن أنماط أو بنية في البيانات. لذلك، لا يكفي وجود عمود لدرجة الامتحان في جدول لتحديد نوع التعلّم.
يمكنك استخدام المعلومات الدراسية نفسها لتقدير درجة امتحان نهائي، أو لتجميع سجلات تتشابه فيما بينها. هذان السؤالان يمنحان البيانات أدوارًا مختلفة. بنهاية هذا الدرس، ستتمكن من تحديد المتغير الهدف، وفصله عن سمات الإدخال، وشرح ما يتغيّر عندما يجري التعلّم من دون هدف مُعطى. يستند هذا التمييز إلى أنواع التعلّم التي يعرضها دليل Google.
محتويات المقال
قراءة الجدول: سمات الإدخال والمتغير الهدف
المشاهدة مثال واحد تصفه البيانات، وتمثّل هنا صفًا يخصّ طالبًا. والمتغير خاصية تُسجَّل في عمود، مثل عدد ساعات الدراسة أو درجة الامتحان النهائي. أمّا سمات الإدخال، التي يُرمز إليها غالبًا بـX، فهي المعلومات التي تقدّمها للنموذج. ويُرمز إلى المتغير الهدف عادةً بـy. تُستخدم هذه الرموز أيضًا في تعريف المتغير الهدف في مسرد scikit-learn.
لنأخذ المشاهدة الأولى من ورقة «Données». إذا كان سؤالنا «هل يمكن تقدير درجة الامتحان النهائي من ساعات الدراسة، نسبة الحضور والدرجات السابقة؟»، تتوزّع الأدوار كما يأتي:
| المتغير ودوره | القيمة المسجّلة |
|---|---|
Hours_Studiedسمة إدخال: ساعات الدراسة. | 23 ساعة أسبوعيًا |
Attendanceسمة إدخال: نسبة الحصص التي حضرها الطالب. | 84٪ |
Previous_Scoresسمة إدخال: درجات الامتحانات السابقة. | 73 نقطة |
Exam_Scoreالمتغير الهدف: درجة الامتحان النهائي. | 67 نقطة |
تصف السمات الثلاث هذه المشاهدة، بينما تمثّل القيمة 67 الإجابة المسجّلة، وليست تقديرًا أنتجه نموذج. أثناء التدريب، يجب الحفاظ على ارتباط كل صف من X بقيمته الصحيحة في y. فربط سمات طالب بدرجة طالب آخر يعني تدريب النموذج على إجابات منسوبة إلى أمثلة غير صحيحة.
تصف كلمة «إدخال» دور المعلومة في النموذج، ولا تثبت علاقة سببية. اختيار ساعات الدراسة سمةً للإدخال لا يثبت أن تغييرها سيؤدّي إلى تغيّر محدّد في الدرجة. يطرح هذا المثال سؤالًا عن التنبؤ، أمّا إثبات السببية فيحتاج إلى دراسة إضافية.
التعلّم الخاضع للإشراف: التعلّم من إجابات معروفة
في التعلّم الخاضع للإشراف، يتعلّم النموذج من أمثلة تُعرف فيها المدخلات والإجابات. والتدريب هو هذه المرحلة من التعلّم؛ إذ توفّر قيم y مرجعًا لضبط العلاقة بين المدخلات والمخرجات. في مثالنا، يتلقّى النموذج مشاهدات تتضمّن ساعات الدراسة، نسبة الحضور، الدرجات السابقة ودرجة الامتحان النهائي، ليتعلّم علاقة تساعده على تقدير الدرجة النهائية من سمات الإدخال.
التعلّم الخاضع للإشراف لا يعني أن شخصًا يصحّح كل تنبؤ يدويًا أثناء التدريب. يأتي الإشراف من الإجابات المرتبطة بالأمثلة، وقد تكون موجودة أصلًا في الملف، مثل Exam_Score هنا. يعرض دليل scikit-learn للتعلّم الخاضع للإشراف طرقًا تعمل ضمن هذا الإطار.
قد يكون المتغير الهدف كمية أو فئة
إذا أردت تقدير الدرجة النهائية بالنقاط، فالهدف كمية عددية، والمهمة هي الانحدار. وإذا أردت التنبؤ بفئة محدّدة مسبقًا، فالمهمة هي التصنيف. تنتمي المهمتان إلى التعلّم الخاضع للإشراف لأن الإجابات معروفة في أمثلة التدريب. وتُسمّى الإجابة في التصنيف غالبًا تسمية، أو label، أي الفئة المسندة إلى المشاهدة.
لنأخذ الآن مجموعة بيانات منفصلة للتصنيف. المتغير الهدف فيها هو Result، وقيمه مُعبّأة مسبقًا بـSuccess، أي نجاح، أو Fail، أي رسوب. يمكن أن تكون ساعات الدراسة، نسبة الحضور والدرجات السابقة سمات إدخال. يتعلّم النموذج التنبؤ بالفئة المعطاة، ولا ينشئ التسميات. في مجموعة البيانات هذه، يكون Result وحده المتغير الهدف، ولا يظهر فيها Exam_Score.
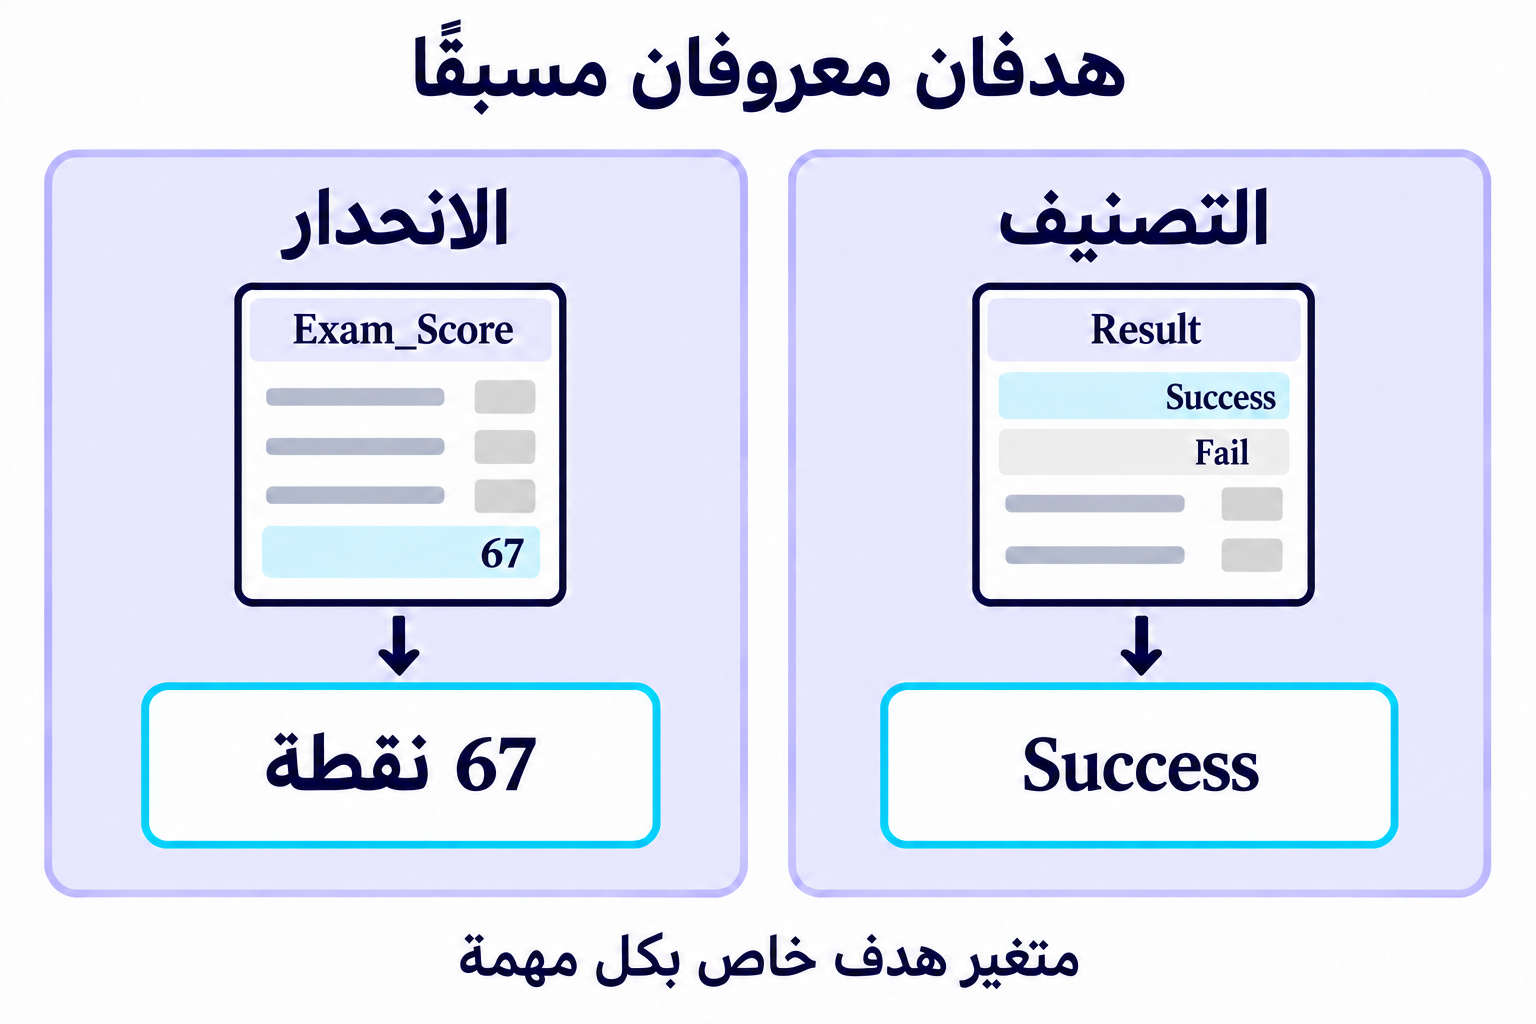
يتوقّف الاختيار بين الكمية والفئة على نوع النتيجة التي يحتاج إليها المشروع. لا يكفي أن تلاحظ وجود أعداد في البيانات؛ فقد تُمثَّل الفئة برقم، وقد تكون درجة الامتحان عددًا صحيحًا مع استخدامها متغيرًا هدفًا للانحدار.
تكون قيمة الهدف مجهولة عند إجراء التنبؤ
التنبؤ هو استخدام النموذج الذي جرى تدريبه مع مدخلات جديدة. لتقدير درجة قبل الامتحان، تقدّم المعلومات المتاحة في ذلك الوقت، من دون الدرجة النهائية التي تبحث عنها. يُرجع النموذج تقديرًا، وتبقى جودة تقديراته بحاجة إلى التقييم.
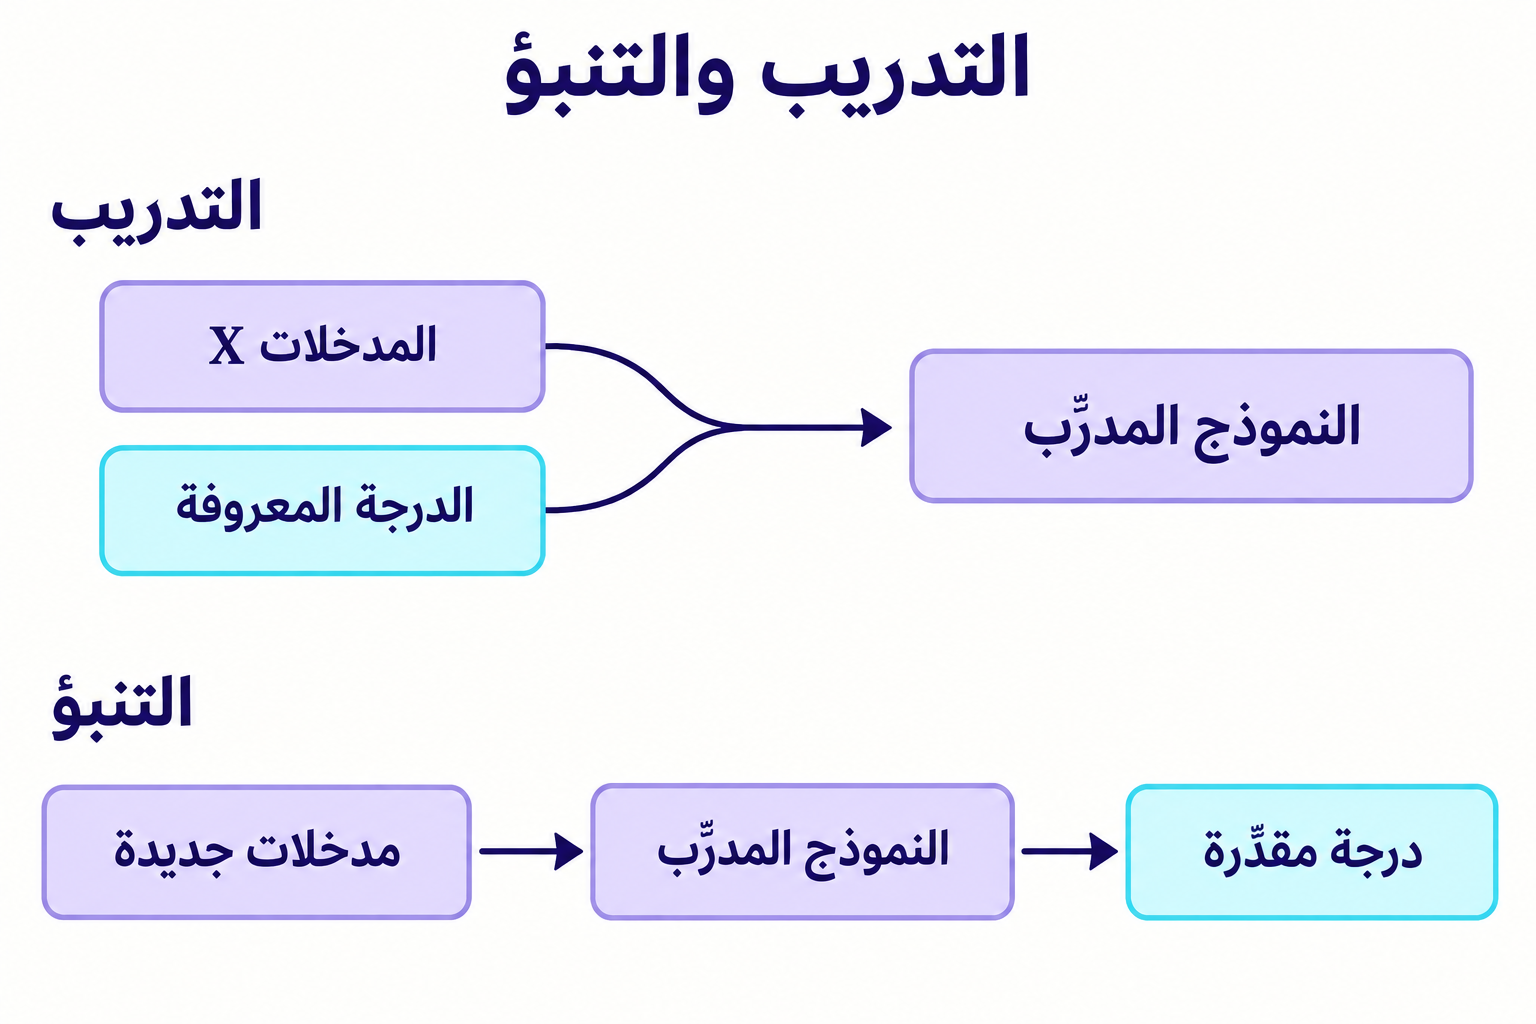
لذلك، يمكن أن تتضمّن واجهة التطبيق حقولًا لساعات الدراسة، نسبة الحضور والدرجات السابقة، ثم تعرض تقديرًا للدرجة النهائية. ولن تطلب من المستخدم إدخال تلك الدرجة؛ فهي النتيجة التي نريد تقديرها.
غياب y لهذا الطالب الجديد لا يحوّل النموذج إلى طريقة تعلّم غير خاضعة للإشراف؛ فقد جرى تدريبه باستخدام إجابات معروفة. ولقياس قدرته على التنبؤ، نحتفظ أيضًا بمشاهدات نعرف قيم الهدف فيها، لكن النموذج لم يستخدمها في التدريب. تُستخدم هذه القيم لاحقًا لمقارنة التقديرات بالقيم المسجّلة.
يجب التمييز بين البيانات المستخدمة لاختيار النموذج أو ضبط إعداداته وبيانات الاختبار النهائي. تُستخدم الأخيرة لتقدير الأداء بعد انتهاء اختيارات النمذجة. الرجوع إليها مرارًا لتحسين النموذج يفقدها دورها بوصفها وسيلة تحقق مستقلة.
التعلّم غير الخاضع للإشراف: اكتشاف الأنماط من دون متغير هدف
في التعلّم غير الخاضع للإشراف، لا تُقدَّم إجابات معروفة لتوجيه التعلّم في هذا التحليل. تفحص الطريقة المدخلات بحثًا عن تنظيم فيها، مثل مشاهدات متقاربة أو تمثيل أكثر اختصارًا. يعرض دليل scikit-learn مهامّ من هذا النوع، منها التجميع وتقليل الأبعاد.
لنعد إلى سمات الإدخال بسؤال آخر: «أي المشاهدات تتشابه من حيث ساعات الدراسة ونسبة الحضور؟» في هذا التحليل، تتكوّن X من Hours_Studied وAttendance. ولا يُقدَّم عمود هدف لتوجيه تكوين المجموعات.
يجمع التجميع، أو clustering، المشاهدات وفق معيار للتشابه. تنتج المجموعات عن الطريقة، ولا تُقدَّم أسماؤها أو تفسيراتها مسبقًا بوصفها إجابات. ووصف مجموعة بأنها تضمّ «طلابًا متفوّقين» استنادًا إلى ساعات الدراسة والحضور وحدهما يضيف حكمًا لا يثبته التحليل.
أمّا تقليل الأبعاد، فيهدف إلى تمثيل البيانات باستخدام عدد أقل من المتغيرات، مع الاحتفاظ بأكبر قدر ممكن من المعلومات المفيدة. تنشئ بعض الطرق متغيرات جديدة انطلاقًا من المتغيرات الأصلية. وقد يساعد ذلك على الاستكشاف أو التمثيل البياني، من دون أن ينتج مجموعات بالضرورة. لذا، لا يقتصر التعلّم غير الخاضع للإشراف على التجميع.
مقارنة التعلّم الخاضع للإشراف وغير الخاضع للإشراف
| خاضع للإشراف | غير خاضع للإشراف |
|---|---|
| السؤال. ما الإجابة التي نريد التنبؤ بها من المدخلات؟ | السؤال. ما البنية التي نريد استكشافها في المدخلات؟ |
| الهدف. إجابة معروفة مرتبطة بكل مثال تدريبي. | الهدف. لا يُقدَّم هدف لتوجيه هذا التحليل. |
| مثال. تقدير درجة نهائية من معلومات متاحة قبل الامتحان. | مثال. تجميع المشاهدات وفق ساعات الدراسة والحضور. |
| التحقق. مقارنة التنبؤات بقيم الهدف لمشاهدات لم تُستخدم في التدريب. | التحقق. فحص تماسك المجموعات ومدى تباعدها واستقرارها، وفقًا للمهمة. |
يمكن تقييم التجميع حتى في غياب فئات مرجعية. يمكنك فحص مدى تقارب المشاهدات داخل المجموعة، ومدى انفصال المجموعات، أو استقرارها عند تغيّر البيانات والإعدادات. ويمكن أيضًا استخدام فئات معروفة للمقارنة بعد التجميع، من دون أن تكون قد وجّهت تكوينه. يميّز دليل تقييم التجميع بين هذه الحالات. ومع ذلك، لا يثبت المؤشر الجيد أن المجموعات تمثّل فئات دراسية مفيدة.
اختر إطار التعلّم انطلاقًا من سؤالك
حدّد النتيجة التي تريد الحصول عليها قبل اختيار خوارزمية. تشدّد إرشادات Google لصياغة مسألة تعلّم الآلة على تحديد الهدف والمعلومات المتاحة عند إجراء التنبؤ.
- حدّد النتيجة المطلوبة. هل تريد درجة مقدَّرة، فئة محدّدة مسبقًا أم تنظيمًا للمشاهدات؟
- تحقّق من الإجابات المتاحة. يحتاج تعلّم التنبؤ بدرجة نهائية إلى أمثلة مصحوبة بتلك الدرجة. غياب إجابات قابلة للاستخدام لا يحوّل هدف التنبؤ تلقائيًا إلى مشروع تجميع.
- اختر مدخلات يمكن استخدامها. للتنبؤ قبل الامتحان، احتفظ بالمعلومات المتاحة فعلًا قبل ذلك الامتحان.
- خطّط للتقييم. حدّد كيف ستفحص أخطاء التنبؤ أو فائدة البنى المكتشفة. ينبغي تقييم الطريقة بحسب السؤال الذي يُفترض أن تجيب عنه.
توجد أطر أخرى عندما تكون قيمة الهدف معروفة لبعض المشاهدات فقط، مثل التعلّم شبه الخاضع للإشراف، الذي يستخدم أمثلة ذات إجابات معروفة وأمثلة من دونها.
تمرين: حدّد دور المتغير الهدف
لكل حالة، حدّد إطار التعلّم، سمات الإدخال ودور Exam_Score. علّل إجابتك بجملة واحدة.
- تستخدم ساعات الدراسة، نسبة الحضور والدرجات السابقة لتعلّم تقدير درجة نهائية معروفة في أمثلة التدريب.
- تجمع المشاهدات وفق ساعات الدراسة والحضور، من دون تقديم درجاتها النهائية لطريقة التجميع.
- يتلقّى نموذج تدرّب باستخدام الدرجات النهائية مدخلات مشاهدة جديدة، لم تُعرف درجتها النهائية بعد.
- بعد تكوين مجموعات الحالة الثانية، تطّلع على الدرجات النهائية لتصف كل مجموعة بمزيد من التفصيل.
اعرض التصحيح مع الشرح
- تعلّم خاضع للإشراف. تتكوّن X من ساعات الدراسة، نسبة الحضور والدرجات السابقة، ويقابل y المتغير Exam_Score. توجّه الإجابة المعروفة التدريب، والمطلوب تقدير درجة بالنقاط، لذا فالمهمة انحدار.
- تعلّم غير خاضع للإشراف. تتكوّن X من ساعات الدراسة والحضور. لا يُستخدم Exam_Score لتوجيه تكوين المجموعات، ولا تُقدَّم فئات متوقعة مسبقًا.
- تنبؤ باستخدام نموذج خاضع للإشراف. تحتفظ المدخلات بالتعريف نفسه المستخدم في التدريب، وتكون الدرجة النهائية هي القيمة المطلوب تقديرها. غيابها لهذه المشاهدة الجديدة لا يغيّر طريقة تدريب النموذج.
- وصف بعد تجميع غير خاضع للإشراف. تضيف الدرجات النهائية معلومات لتفسير مجموعات تكوّنت بالفعل. إذا استخدمتها لاحقًا لاختيار التجميع أو تعديله، فإنها تبدأ بتوجيه اختياراتك، ويجب توضيح هذا التغيّر في الإجراء.
أخطاء شائعة تتعلّق بالمتغير الهدف
إدراج الهدف أو معلومة تكشفه ضمن المدخلات
في بيانات الانحدار، إدراج Exam_Score ضمن المدخلات للتنبؤ بالدرجة نفسها يعني إعطاء الإجابة للنموذج مسبقًا. وفي بيانات التصنيف، تظهر المشكلة نفسها إذا قُدّم Result للتنبؤ بـResult. يجب إبقاء المتغير الهدف لكل مهمة خارج X، لأن قيمته ستكون مجهولة عند إجراء التنبؤ. هذا تسرّب للبيانات؛ راجع شرح scikit-learn لتسرّب البيانات.
يشمل الفحص أيضًا الأعمدة المشتقة من الهدف والمعلومات المجمّعة بعد الامتحان. لذلك، يتطلّب فصل X عن y فهم الحقول، وليس مجرّد حذف عمود يحمل اسمًا معيّنًا.
استنتاج نوع التعلّم من محتويات الملف
يمكن لجدول يحتوي على درجات أن يُستخدم في تحليل غير خاضع للإشراف إذا لم توجّه تلك الدرجات التحليل. وبالمقابل، لا يلزم أن تكون الفئات المعروفة مدخلات، بل يمكن أن تصبح هدفًا للتصنيف. يتحدّد دور العمود انطلاقًا من السؤال وطريقة استخدامه.
الخلط بين المجموعات المكتشفة والفئات المحدّدة
في بيانات التصنيف، تكون الفئتان Success وFail مسجّلتين مسبقًا في Result. أمّا المجموعات المكوّنة وفق ساعات الدراسة والحضور، فتنتج عن طريقة تجميع. إطلاق أسماء على هذه المجموعات بعد تكوينها لا يعني أن تلك الأسماء قُدّمت للنموذج أثناء التدريب.
ما ينبغي تذكّره والخطوة التالية
يستخدم التعلّم الخاضع للإشراف إجابات معروفة لتعلّم التنبؤ بمتغير هدف. ويبحث التعلّم غير الخاضع للإشراف عن بنية في البيانات من دون تقديم هدف يوجّه ذلك التحليل. يمكن استخدام البيانات الأصلية نفسها في الإطارين؛ ويتيح لك السؤال ودور كل عمود التمييز بينهما.
المصادر وقراءات للتوسّع
- أورليان جيرون، Hands-On Machine Learning with Scikit-Learn and PyTorch، دار O’Reilly، الطبعة الأولى، الإصدار الأول بتاريخ 22 أكتوبر 2025. الفصل الأول: Training Supervision، ص 10–16، وTesting and Validating، ص 35–37؛ الفصل الثاني: رموز المدخلات والهدف، ص 45–46، وإعادة تحجيم القيم، ص 77–78؛ الفصل الثامن: تقييم التجميع وحدوده، ص 256–259. الموارد الرسمية للمؤلف.
- Google — ما هو تعلّم الآلة؟: أطر التعلّم، الانحدار والتصنيف.
- scikit-learn — تعريف المتغير الهدف، التعلّم الخاضع للإشراف والتعلّم غير الخاضع للإشراف: المصطلحات ونظرة عامة على الطرق.
- Google — صياغة مسألة تعلّم الآلة: تحديد النتيجة المطلوبة وسمات الإدخال القابلة للاستخدام.
- scikit-learn — تقييم التجميع وتجنّب تسرّب البيانات: قراءات تقنية بعد استيعاب مفاهيم هذا الدرس.
- Student Performance Factors — Lai Ng.، Kaggle: مصدر البيانات. جرت مراجعة أسماء الحقول، وحداتها وقيم الأمثلة في ورقتَي «Données» و«Description des champs» من StudentPerformanceFactors.xlsx.
