الذكاء الاصطناعي، تعلّم الآلة والتعلّم العميق: فهم الفروق
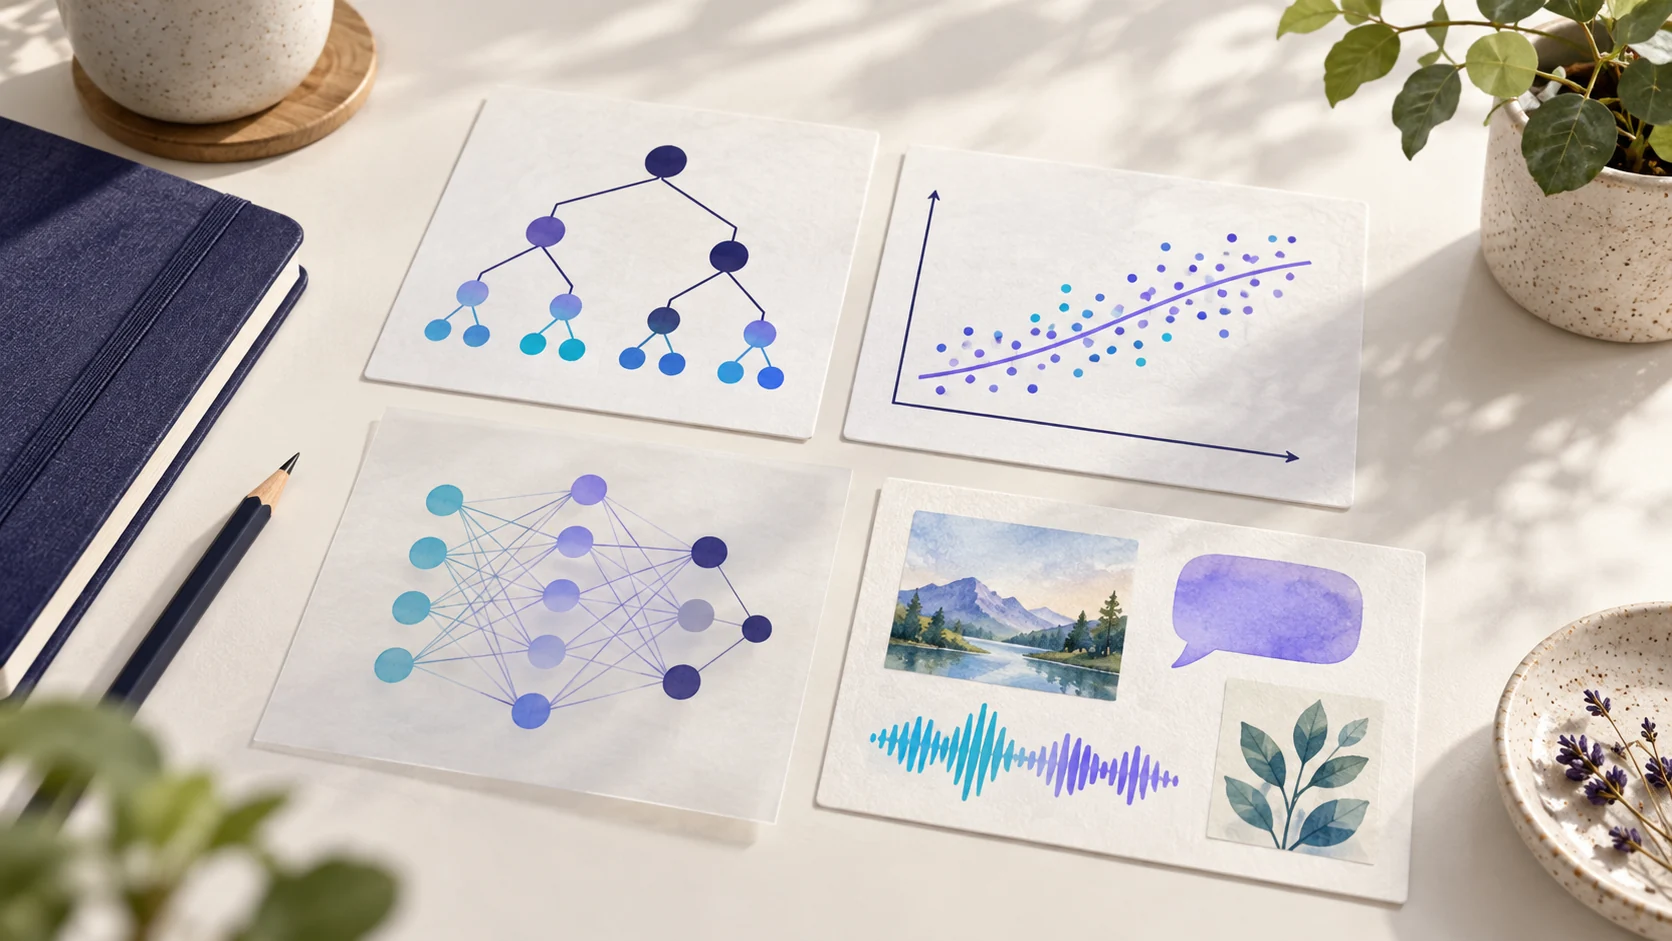
الذكاء الاصطناعي هو المجال العام. أمّا تعلّم الآلة فيتيح بناء نماذج تتعلّم من البيانات، والتعلّم العميق أحد فروعه. ويشير الذكاء الاصطناعي التوليدي إلى إنتاج محتوى، مثل النصوص أو الصور. ولفهم الفروق بينها، سنتابع مشكلة واحدة: تقدير درجة امتحان انطلاقًا من معلومات متاحة قبل معرفة هذه الدرجة.
سنبدأ بما ينبغي للبرنامج أن يفعله، ثم نرى كيف يتعلّم النموذج وكيف نتحقّق من تقديراته. بعد ذلك، ستتمكّن من فهم موقع التعلّم العميق ودور المساعد التوليدي في التطبيق. لا يحتاج هذا الدرس الأول إلى كتابة أي كود.
المحتويات
1. الذكاء الاصطناعي وتعلّم الآلة: الانطلاق من مشكلة ملموسة
الذكاء الاصطناعي يشمل أساليب تتيح للأنظمة أداء مهام مثل التعرّف، الاستدلال، التنبّؤ وإنتاج المحتوى. ويشرح التعريف الرسمي لنظام الذكاء الاصطناعي لدى منظمة التعاون الاقتصادي والتنمية كيفية عمله: انطلاقًا من مدخلات وأهداف، يستنتج النظام كيفية إنتاج مخرجات، مثل التنبّؤات أو التوصيات. وقد يعتمد الذكاء الاصطناعي على معرفة ينظّمها أشخاص أو على التعلّم من البيانات.
في مثالنا، نعرف ساعات الدراسة، نسبة حضور الدروس والدرجات السابقة. ونريد تقدير الدرجة النهائية قبل معرفتها. يعني التقدير هنا تقديم قيمة تقريبية؛ فلا يمكن للبرنامج معرفة النتيجة بيقين.
القاعدة تُكتب والنموذج يتعلّم
إذا طلبت «الإشارة إلى الصفوف التي تقلّ فيها نسبة الحضور عن 80٪»، فقد حدّدت المعيار مسبقًا. يطبّق البرنامج قاعدة صريحة. في أول صفّين من الملف، تبلغ نسبة الحضور 84٪ ثم 64٪؛ لذا يُشار إلى الصف الثاني فقط. وقد اخترنا عتبة 80٪ لهذا المثال.
عند تقدير درجة، تكون العلاقة أقلّ وضوحًا. كيف نجمع ساعات الدراسة، الحضور والدرجات السابقة؟ يقوم تعلّم الآلة، أو التعلّم الآلي، على بناء علاقة انطلاقًا من أمثلة. وتُمثّل هذه العلاقة بواسطة نموذج، وهو تمثيل رياضي يحوّل المدخلات إلى إجابة. راجع مقدّمة Google إلى تعلّم الآلة.
يختار الشخص المشكلة، البيانات والأسلوب. وتضبط خوارزمية التعلّم النموذج باستخدام الأمثلة. سنشرح هذا الضبط في القسم الثالث؛ وتذكّر الآن أن العلاقة المستخدمة لتقدير الدرجة تأتي من البيانات.
يقارن الشكل 1 كيفية تحديد ما يفعله البرنامج في هذين النهجين. ولهما هدفان مختلفان: تحديد حالات انخفاض الحضور وتقدير الدرجة مهمّتان، ولا يمكن اعتبار إحداهما بديلًا عن الأخرى.
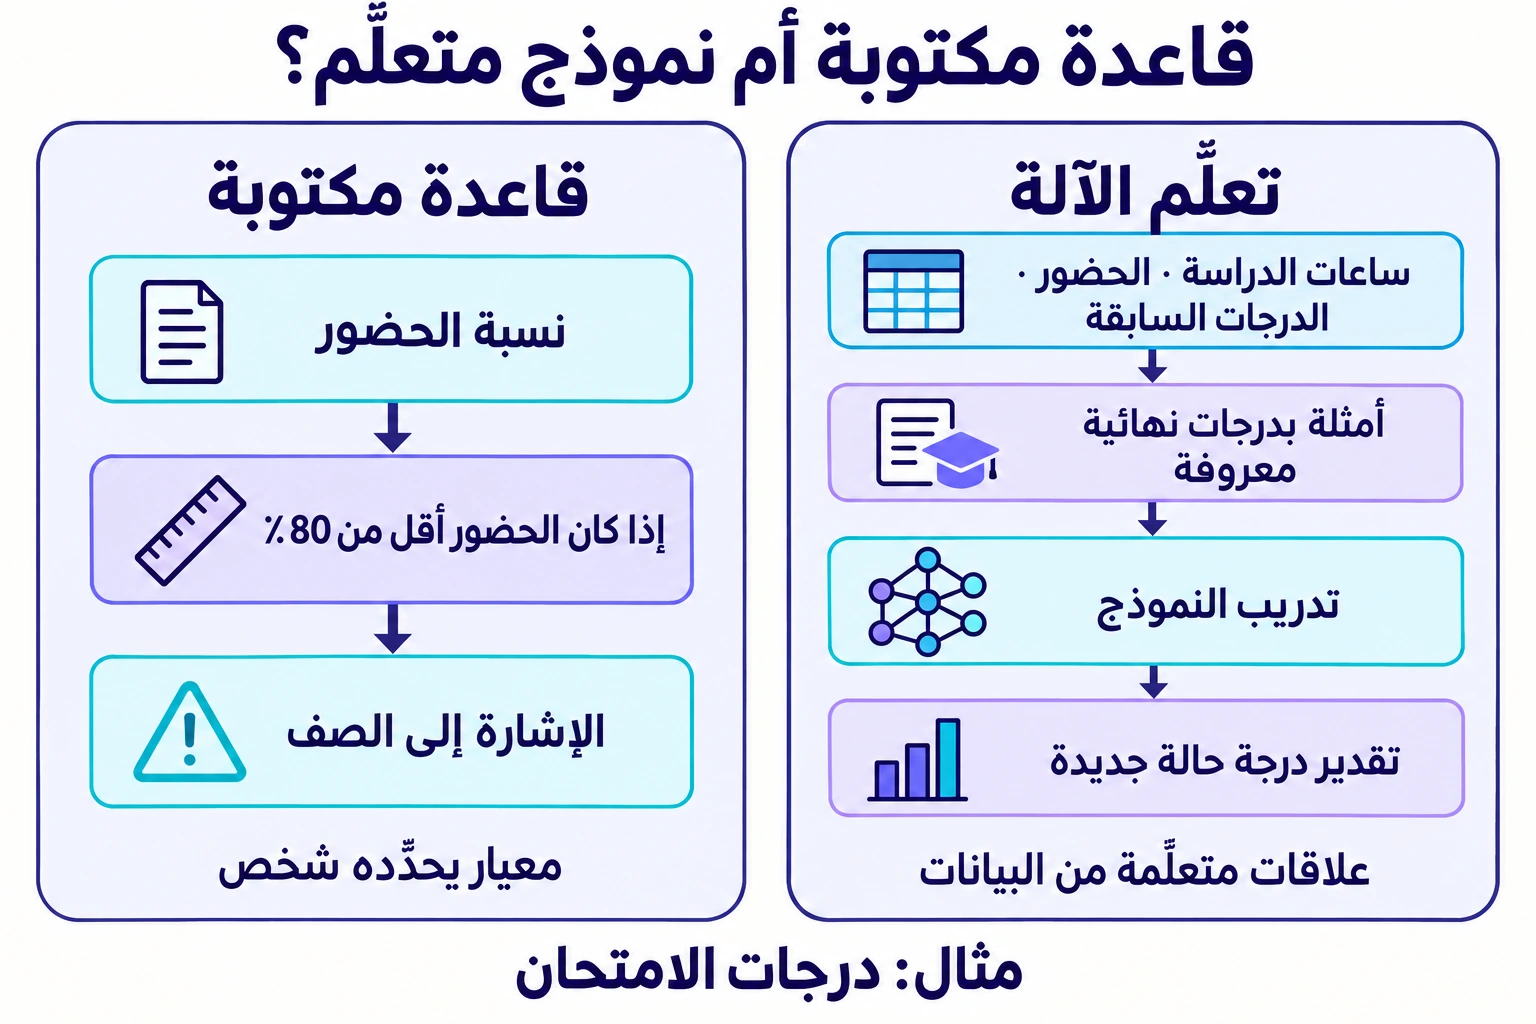
يمكن للتطبيق الجمع بينهما: تتحقّق قاعدة من أن النسبة المُدخلة تقع بين 0 و100، ثم يستخدم النموذج المعلومات الصحيحة لتقدير الدرجة. لذلك لا يكفي إجراء حساب آلي، مثل متوسّط عمود، لوصف نظام بأنه نظام ذكاء اصطناعي.
2. الانحدار أم التصنيف: تحديد الإجابة المطلوبة
قبل تدريب النموذج، ينبغي تحديد ما يستقبله وما نريده أن ينتجه. يُسمّى كل عنصر من المعلومات المقدّمة إليه متغيّر إدخال (Feature). أمّا المتغيّر المستهدف (Target) فهو المتغيّر الذي نسعى إلى التنبّؤ بقيمته. في مثالنا الأول، المدخلات الثلاثة هي ساعات الدراسة، الحضور والدرجات السابقة، والهدف هو الدرجة النهائية.
| العمود ومعناه | القيمة المعروفة | الدور |
|---|---|---|
Hours_Studiedساعات الدراسة في الأسبوع | 23 ساعة | مدخل |
Attendanceالنسبة المئوية للدروس التي حضرها الطالب | 84٪ | مدخل |
Previous_Scoresدرجات الامتحانات السابقة | 73 نقطة | مدخل |
Exam_Scoreدرجة الامتحان النهائي | 67 نقطة | الهدف |
الدرجة البالغة 67 نقطة هي قيمة مسجّلة في الملف. خلال التدريب، تتيح هذه الإجابة المعروفة التحقّق من تقديرات النموذج. وعند استخدامه في حالة جديدة، سنقدّم المدخلات فقط، لأن الدرجة النهائية هي الإجابة المطلوبة. للاطّلاع على مصدر هذه الأمثلة، يمكنك تنزيل ملف Excel المستخدم في المسار.
تقدير درجة: الانحدار
الانحدار يقدّر قيمة عددية. سؤالنا هو: «ما الدرجة النهائية التي يمكن التنبّؤ بها؟» والإجابة المطلوبة درجة بالنقاط. وللحكم على جودة التقديرات، سنقارنها بالدرجات المسجّلة فعليًا في أمثلة مخصّصة للتقييم.
التنبّؤ بفئة: التصنيف
يتنبّأ التصنيف بالانتماء إلى فئة محدّدة مسبقًا. في بيانات التصنيف، يكون الهدف هو العمود Result، وهو معبّأ مسبقًا بالقيمة Success بمعنى نجاح أو Fail بمعنى رسوب. يتعلّم النموذج توقّع هذه الفئة من المدخلات. في مجموعة بيانات التصنيف، لا يُدرج عمود Exam_Score. أمّا مجموعة بيانات الانحدار، فتستخدم Exam_Score وحده هدفًا ولا تتضمّن Result.
لنقرأ مثالين من بيانات التصنيف. في الأول، تبلغ ساعات الدراسة 23، ونسبة الحضور 84 %، والدرجات السابقة 73؛ وتكون قيمة Result المعبّأة مسبقًا هي Success. في مثال آخر، تبلغ قيم المدخلات 13، و69 % و68؛ وتكون قيمة Result هي Fail. يتعلّم النموذج توقّع هذه التسميات الموجودة مسبقًا من المدخلات الثلاثة.
يقارن الشكل 2 بين مهمّتين منفصلتين: تقدير درجة في الانحدار، والتنبّؤ بفئة Result في التصنيف. تكون تسميات Success وFail موجودة مسبقًا في أمثلة التدريب، وتبقى مجهولة للحالات الجديدة. لذلك لا نضع العمود المستهدف ضمن مدخلات النموذج.
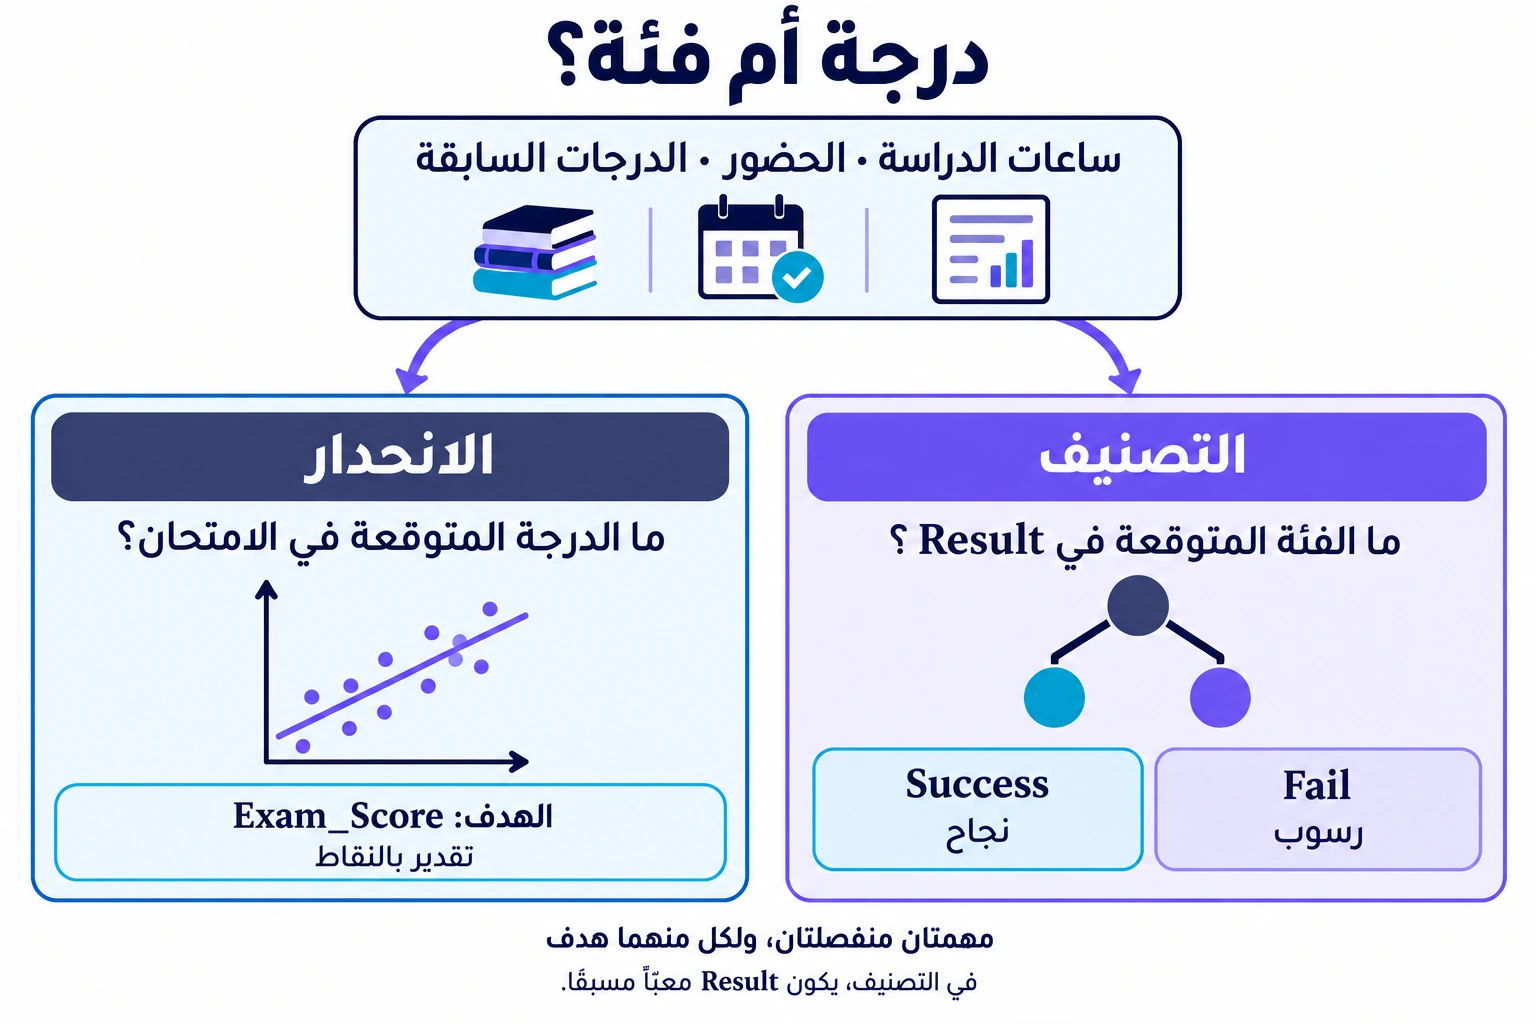
يُسمّى التصنيف الذي يتضمّن فئتين تصنيفًا ثنائيًا. وقد يقدّر النموذج احتمالًا قبل إسناد فئة؛ وسنعود إلى هذا التفصيل في قسم التوضيحات. في بقية الدرس، سنحتفظ بهدفنا الأول: تقدير درجة.
3. كيف يتعلّم النموذج ثم يُستخدم؟
تحتوي أمثلتنا على المدخلات والإجابة المعروفة. وهذا هو التعلّم الخاضع للإشراف: تُستخدم الإجابة مرجعًا أثناء التدريب. إذن «الخاضع للإشراف» يصف الأمثلة المتاحة، بينما «الانحدار» يصف نوع الإجابة المطلوبة. ويمكن تدريب نموذج انحدار بالتعلّم الخاضع للإشراف.
التدريب: ضبط العلاقة انطلاقًا من الأمثلة
لنتصوّر نموذجًا يجمع مدخلاتنا الثلاثة بواسطة معاملات. هذه معاملات النموذج (Parameters)، وهي قيم تحدّد كيف يحسب إجابته. ويتمثّل التدريب في ضبطها باستخدام الأمثلة ودرجاتها النهائية المعروفة.
أثناء التدريب، تُحسب تقديرات النموذج وتُقارن بالإجابات المعروفة باستخدام دالة الخسارة (Loss function)، التي تقيس مقدار الخطأ. ثم تُعدَّل معاملات النموذج لتقليل هذه الخسارة. أمّا خوارزمية التعلّم فهي الإجراءات الحسابية التي تنظّم هذا الضبط؛ والنموذج المدرَّب هو النتيجة التي نحصل عليها. يشرح دليل Google لمصطلحات التدريب في تعلّم الآلة هذه المفاهيم.
في الانحدار الخطي، تُبنى الإجابة من مجموع مرجّح للمدخلات تُضاف إليه قيمة ثابتة. يعني «مرجّح» أن كل مدخل يُضرب في معامل. مع مدخل واحد، تمثّل هذه العلاقة خطًا مستقيمًا؛ ومع مدخلات متعدّدة، تجمع مساهماتها. هذا الأسلوب أحد الخيارات، وليس تعريفًا لكل أنواع الانحدار. راجع عرض الانحدار الخطي.
التقييم: التحقّق باستخدام أمثلة لم تدخل في التدريب
لا يكفي الحكم على النموذج من نتائجه على أمثلة التدريب. نخصّص صفوفًا أخرى، مع إجاباتها، لقياس أخطائه. نقدّم له مدخلاتها، ثم نقارن تقديراته بالدرجات المعروفة. وهذا هو التقييم.
نريد من النموذج التعميم: أي تقديم تقديرات مفيدة لحالات لم تدخل في التدريب. إذا تعلّم تفاصيل أمثلة التدريب أكثر من اللازم وأصبح أداؤه ضعيفًا في الحالات الأخرى، فإن ذلك يُسمّى Overfitting. يتناول درس Google عن التعميم وOverfitting هذه الصعوبة بمزيد من التفصيل.
نحتاج أيضًا إلى طريقة بسيطة نقارن النموذج بها. يمكن أن نستخدم طريقة مرجعية (Baseline) تعطي في كل مرة وسيط درجات أمثلة التدريب. والوسيط هو القيمة التي تقسّم الدرجات المرتّبة إلى نصفين. ينبغي للنموذج الأكثر تعقيدًا أن يحقّق تحسّنًا مقاسًا مقارنة بهذه الطريقة، على حالات التقييم نفسها.
التنبّؤ: تطبيق النموذج المدرَّب على حالة جديدة
يمكننا بعد ذلك تقديم ساعات الدراسة، الحضور والدرجات السابقة لحالة لا نعرف درجتها النهائية. يستخدم النموذج المعاملات التي تعلّمها لإنتاج تقدير. وهذا هو التنبّؤ، ويُسمّى أيضًا الاستدلال (Inference).
في هذا السياق، يعني «التنبّؤ» تقدير إجابة مجهولة، ولا يتعلّق بالضرورة بحدث مستقبلي. استخدام النموذج لا يبدأ تدريبًا جديدًا تلقائيًا. ويمكن للتطبيق معالجة طلبات كثيرة بواسطة النموذج المدرَّب نفسه.
المدخلات والدرجات المعروفة: ضبط النموذج.
أمثلة مخصّصة للتقييم: قياس الأخطاء.
مدخلات جديدة: تقدير درجة مجهولة.
يبقى التقدير غير يقيني، حتى بعد تقييم مُرضٍ. كذلك لا يثبت وجود ارتباط بين ساعات الدراسة والدرجة النهائية أن إضافة ساعة دراسة ستسبّب ارتفاعًا محدّدًا في الدرجة. التنبّؤ بقيمة وإثبات سبب هدفان مختلفان.
4. التعلّم العميق: أحد فروع تعلّم الآلة
حدّدنا المهمّة ومراحل التدريب، التقييم والتنبّؤ. ويمكننا الآن اختيار الأسلوب. يستخدم التعلّم العميق شبكات عصبية تحتوي على طبقات معالجة متعدّدة. وهو ينتمي إلى تعلّم الآلة، إذ تُضبط معاملاته أيضًا باستخدام البيانات.
الشبكة العصبية الاصطناعية نموذج يتكوّن من وحدات حسابية مترابطة. وتجمع الطبقة وحدات تحوّل القيم التي تستقبلها وتنقل نتائجها إلى الطبقة التالية. تحدّد معاملات الشبكة، ومنها الأوزان والانحيازات، هذه التحويلات. ويشير مصطلح «العصبون» هنا إلى وحدة رياضية، لا إلى خلية عصبية بيولوجية.
لتقدير الدرجة، تمرّ قيم المدخلات بتحويلات متتالية قبل الوصول إلى المخرج. وتتعلّم الطبقات الوسيطة تركيبات عددية مفيدة للمهمّة. هذه تمثيلات للبيانات تتعلّمها الشبكة (Learned representations)، ولا تتطابق بالضرورة مع مفاهيم بشرية مثل «الجهد» أو «الدافعية». يشرح هذا المبدأ LeCun، Bengio وHinton (2015) وكذلك دورة Google عن الشبكات العصبية.
تبقى المهمّة انحدارًا إذا كان المخرج درجة. استبدال الانحدار الخطي بشبكة عميقة يغيّر الأسلوب، لا السؤال. وبالمثل، يمكن للشبكة العميقة إجراء تصنيف إذا تنبّأت بفئة.
يُستخدم التعلّم العميق أيضًا لمعالجة الصور، النصوص والصوت. وفي جدولنا، لا يضمن تعقيده تقديرات أفضل؛ بل ينبغي مقارنة الأساليب على أمثلة التقييم نفسها، ثم مراعاة الأخطاء، السرعة والموارد المطلوبة.
5. الذكاء الاصطناعي التوليدي: إنتاج المحتوى
الذكاء الاصطناعي التوليدي ينتج محتوى انطلاقًا من أنماط تعلّمها من البيانات. ويمكنه توليد نصوص أو صور أو صوت. يصف المصطلح ما ينتجه النظام، ولا يشير إلى أسلوب واحد بعينه. وتعتمد النماذج التوليدية الكبيرة الحالية خصوصًا على التعلّم العميق.
لنغيّر الهدف الآن: نريد شرح الأعمدة لمستخدم التطبيق. يمكننا تقديم أوصاف الحقول مع طلب مكتوب: «اشرح الفرق بين ساعات الدراسة ونسبة الحضور». يُسمّى النص الذي نرسله إلى النموذج لتوجيه إجابته Prompt.
نموذج اللغة الكبير، أو LLM، هو نموذج دُرّب على كميات كبيرة من النصوص لمعالجة اللغة وإنتاجها. ويمكنه كتابة الشرح انطلاقًا من التعريفات المقدّمة. سنستخدم عندها نموذجًا مدرَّبًا مسبقًا، ولن ندرّب نموذج لغة كبيرًا على صفوفنا البالغ عددها 6,607.
| الوظيفة | مدخل | المخرج المطلوب |
|---|---|---|
| تقدير الدرجة | ساعات الدراسة، الحضور والدرجات السابقة | درجة بالنقاط: انحدار |
| شرح الحقول | أوصاف الأعمدة وطلب مكتوب | نص: توليد |
قد تحتوي إجابة مصاغة جيدًا على معلومة خاطئة أو مصدر مختلق. تُسمّى هذه الظاهرة غالبًا هلوسة النموذج (Hallucination). لذلك ينبغي التحقّق من النص بالرجوع إلى الوثيقة الأصلية. وإذا شرح المساعد درجة مقدّرة، فيجب ألا ينسب إليها أسبابًا لم يثبتها النموذج. راجع شرح Google لنماذج اللغة الكبيرة.
تحديد موقع المفاهيم الأربعة بعد الأمثلة
الشكل 3 يجمع المصطلحات التي تعرّفنا إليها. فتعلّم الآلة جزء من الذكاء الاصطناعي، والتعلّم العميق جزء من تعلّم الآلة. أمّا الذكاء الاصطناعي التوليدي فيصف قدرة على إنتاج المحتوى: بعض النماذج العميقة توليدية، وتوجد نماذج توليدية أخرى لا تستخدم شبكة عميقة.
المجال العام: التعرّف، الاستدلال، التخطيط وإنتاج المحتوى…
نهج: تعلّم العلاقات انطلاقًا من أمثلة، أي من بيانات.
مجموعة من الأساليب تستخدم شبكات عصبية ذات طبقات متعدّدة.
إنتاج نصوص، صور وصوت… هنا تقع نماذج اللغة الكبيرة التوليدية ونماذج الانتشار (Diffusion models) الشائعة.
للتعلّم العميق أيضًا استخدامات غير توليدية، مثل تقدير درجة انطلاقًا من جدول.
يمكن للنماذج أيضًا تعلّم توليد أمثلة دون استخدام شبكة عصبية عميقة.
إذن، الشبكة العميقة التي تقدّر درجة هي نموذج تعلّم عميق يؤدّي انحدارًا. ونموذج اللغة الكبير التوليدي هو نموذج تعلّم عميق ينتج نصًا. يجيب مصطلحا «التعلّم العميق» و«التوليدي» عن سؤالين مختلفين: ما الأسلوب المستخدم؟ وما المخرج الذي يُنتَج؟
6. من النموذج إلى تطبيق ويب
النموذج أحد مكوّنات التطبيق. يعرض الشكل 4 سير العمل (Workflow)، أي الخطوات اللازمة للانتقال من حاجة محددة إلى أداة قابلة للاستخدام. ويشكّل التدريب والتقييم اللذان شرحناهما مرحلتين ضمن هذه العملية الأوسع.
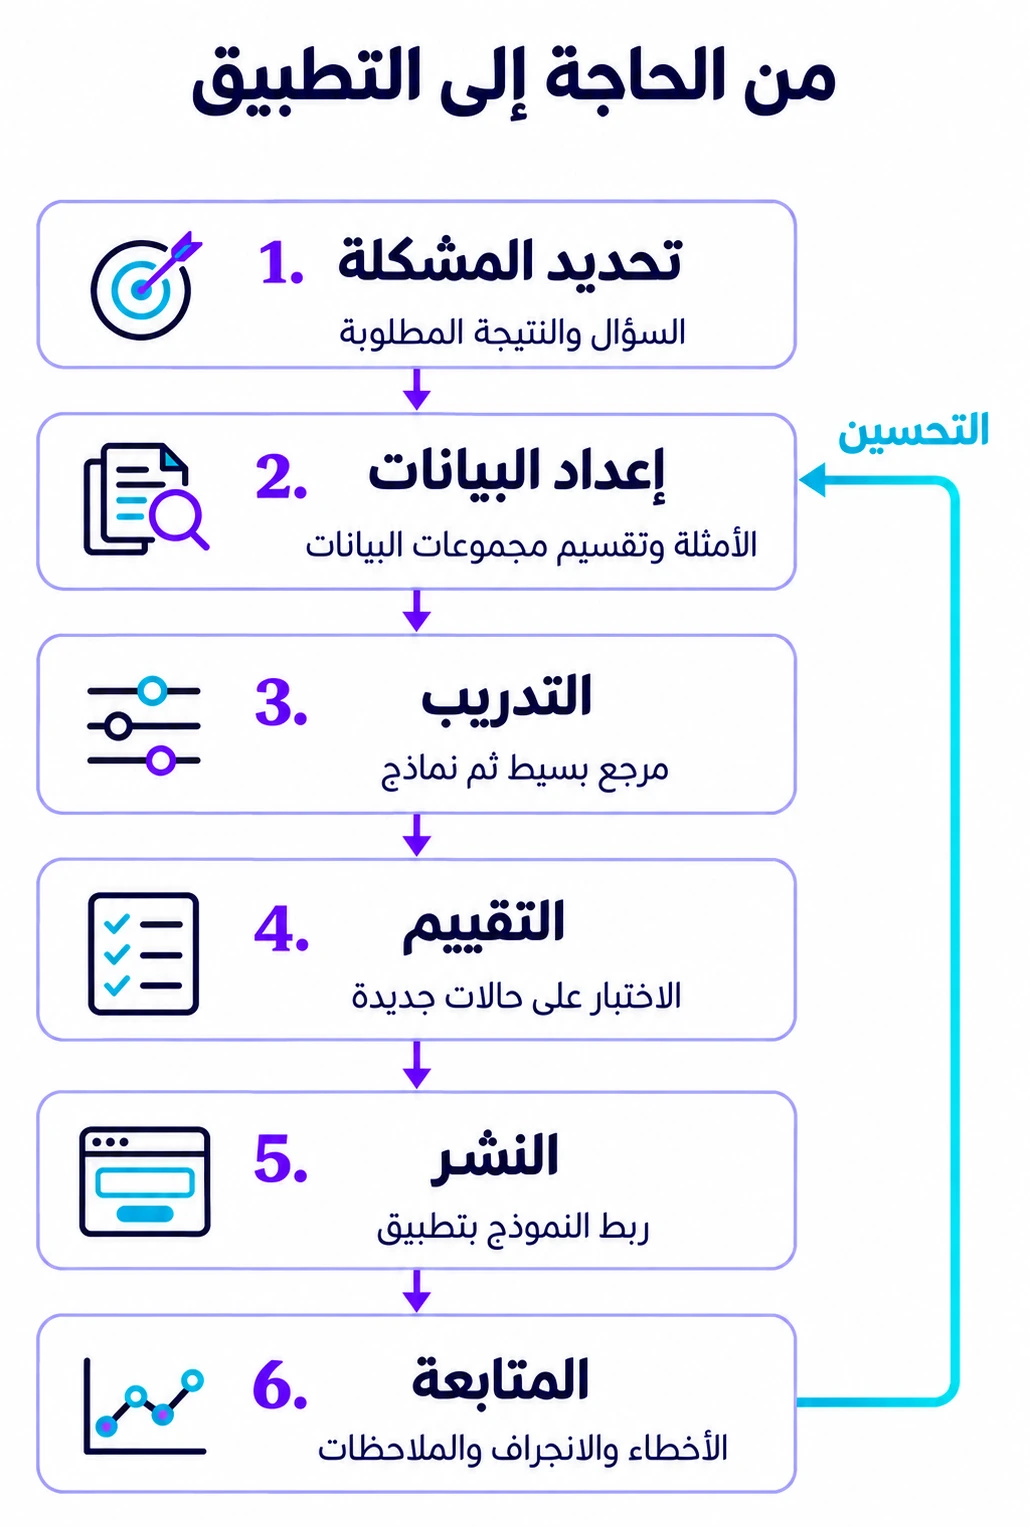
- تحديد المشكلة. تحديد المخرج المطلوب، المعلومات المعروفة وقت الطلب والأخطاء المقبولة. هنا: درجة مقدّرة انطلاقًا من ثلاثة مدخلات.
- إعداد البيانات. التحقّق من التعريفات، الوحدات وجودة البيانات. وتقسيم الأمثلة قبل ضبط التحويلات والنموذج.
- التدريب. إعداد طريقة مرجعية بسيطة، ثم تعلّم معاملات النماذج التي ستُقارن.
- التقييم. قياس الأخطاء على حالات مخصّصة للتقييم، مع فحص الفروق الكبيرة والحالات الأقلّ تمثيلًا.
- النشر. إتاحة النموذج للتطبيق، مع التحويلات اللازمة لإعداد مدخلاته.
- المتابعة. مراقبة عمل التطبيق وتغيّر أخطائه عندما تصبح الدرجات الحقيقية متاحة. وقد تتغيّر خصائص الطلاب أو سياق الاستخدام، مما قد يقلّل ملاءمة العلاقات التي تعلّمها النموذج سابقًا. يُسمّى هذا النوع من التغيّر Drift.
بعد إتاحة النموذج، يتبع كل طلب مسارًا أقصر: يُدخل المستخدم المعلومات، يتحقّق التطبيق منها، ثم يقدّر النموذج الدرجة وتعرض الشاشة النتيجة. يستخدم هذا المسار النموذج، ولا يعيد المراحل الست للمشروع عند كل نقرة.
إدخال ساعات الدراسة، الحضور والدرجات السابقة.
التحقّق من القيم، إعدادها وتطبيق النموذج.
عرض الدرجة المقدّرة وحدودها.
يمكن للواجهة التواصل مع خدمة بواسطة واجهة برمجة التطبيقات (API)، وهي وسيلة لتبادل المعلومات بين البرامج. ويجب على التطبيق أيضًا التعامل مع المدخلات غير الصحيحة، التأخير وعدم توفّر الخدمة. توضح وثائق Google عن تشغيل أنظمة تعلّم الآلة في التطبيقات الفعلية هذه الجوانب المحيطة بالنموذج.
سيساعدنا التطبيق الذي سنبنيه في هذا المسار على فهم هذه العملية. ولا يكفي ملف Excel وحده للتحقّق من صلاحية استخدامه لاتخاذ قرارات تخصّ الأشخاص. وإذا أضفنا مساعدًا توليديًا، فسنحتاج أيضًا إلى التحقّق من مطابقة تفسيراته للوثائق المقدّمة.
7. اختبر فهمك
أجب أولًا بكلماتك، ثم اعرض الإجابة. تتناول الحالات الخمس الفروق اللازمة لفهم بقية المسار.
1. الإشارة إلى حضور أقلّ من 80٪: هل نحتاج إلى تدريب نموذج؟
تكفي قاعدة، لأن المعيار معروف مسبقًا. ستشير مثلًا إلى نسبة الحضور البالغة 64٪ في الصف الثاني، لكنها لا تتنبّأ بالدرجة النهائية. ويصبح التعلّم نهجًا مختلفًا عندما نريد تقدير تلك الدرجة من الأمثلة.
2. هل الدرجة البالغة 67 نقطة في الصف الأول تنبّؤ؟
لا، إنها الدرجة المعروفة في الملف. تُستخدم إجابة مرجعية أثناء التدريب أو التقييم، بحسب المجموعة التي ينتمي إليها الصف. أمّا التنبّؤ فهو قيمة يحسبها نموذج؛ ولا نعرض هنا أي نتيجة لنموذج.
3. تتعلّم شبكة عميقة من درجات معروفة وتقدّر درجة: كيف نصف هذا العمل؟
المهمّة هي الانحدار، لأن المخرج قيمة عددية. والتعلّم خاضع للإشراف، لأن الأمثلة تحتوي على الإجابات. وينتمي الأسلوب إلى التعلّم العميق، لأنه يستخدم شبكة عميقة. تتكامل هذه الأوصاف، ولا يلزم اختيار واحد منها فقط.
4. تتطابق تقديرات النموذج مع درجات أمثلة التدريب: هل يثبت ذلك موثوقيته؟
لا. ينبغي قياس أخطائه على حالات مخصّصة للتقييم، التحقّق من أن الإجابة ليست ضمن المدخلات، ومقارنة النتائج بطريقة مرجعية بسيطة. بعد ذلك، ينبغي اختبار مسار الطلب داخل التطبيق، خصوصًا إدخال البيانات وعرض النتيجة.
5. يكتب المساعد شرحًا للأعمدة: هل يقدّر الدرجة أيضًا؟
كتابة هذا الشرح هي توليد نص. وتقدير الدرجة وظيفة أخرى نسندها إلى نموذج انحدار خضع للتقييم. ينبغي أن يطابق النص الأوصاف وألا يختلق أسبابًا للنتائج.
8. ما ينبغي تذكّره والخطوة التالية
لفهم نظام، ابدأ بالمهمّة المطلوبة، المدخلات والمخرج. ويمكنك بعد ذلك وصف نوع المهمّة، نمط التعلّم والأسلوب المستخدم.
- الذكاء الاصطناعي: المجال العام. تعلّم الآلة: تعلّم علاقة من البيانات.
- الانحدار: تقدير قيمة عددية. التصنيف: التنبّؤ بفئة. التعلّم الخاضع للإشراف: التعلّم باستخدام إجابات معروفة.
- التعلّم العميق: أحد فروع تعلّم الآلة. الذكاء الاصطناعي التوليدي: إنتاج محتوى، غالبًا باستخدام هذه الأساليب.
- التدريب، التقييم والتنبّؤ: ضبط النموذج، قياس أخطائه على حالات مخصّصة للتقييم، ثم تطبيقه على حالة جديدة.
9. توضيحات وموارد للتعمّق
تجيب التوضيحات التالية عن أسئلة أكثر تفصيلًا، ويمكنك العودة إليها عندما تحتاج إلى تعميق فهم هذه المفاهيم.
لماذا نميّز بين التدريب، التحقّق والاختبار؟
يضبط التدريب معاملات النموذج. أمّا التحقّق (Validation) فيتيح مقارنة الإعدادات أو النماذج أثناء التطوير. ويُستخدم الاختبار (Test) للتقييم النهائي بعد اعتماد الاختيارات. وتكرار استخدام نتائج الاختبار لاختيار النموذج يُفقد هذه المجموعة دورها في التقييم المستقل. كذلك ينبغي تعلّم معاملات التحويلات من بيانات التدريب وحدها، ثم تطبيق التحويلات نفسها على بيانات التحقّق والاختبار من دون إعادة ضبطها باستخدام هذه البيانات. راجع تقسيم البيانات إلى مجموعات التدريب، التحقّق والاختبار.
التصنيف: لماذا قد نحصل على احتمال؟
قد يقدّر النموذج احتمال الفئة Success، ثم يطبّق عليه عتبة قرار. تتعلّق هذه العتبة بالاحتمال، أما تسميات Result فهي موجودة مسبقًا في بيانات التدريب، ولا ينشئها النموذج. وتعني المعايرة (Calibration) توافق الاحتمالات التي يعطيها النموذج مع التكرارات الفعلية في عدد كبير من الحالات. لذلك لا يجعل المخرج العددي المهمّة انحدارًا تلقائيًا. راجع اختيار عتبة القرار في التصنيف ومعايرة احتمالات التصنيف في scikit-learn.
ما المهام وأنماط التعلّم الأخرى؟
التجميع (Clustering) هو البحث عن مجموعات متشابهة دون وجود فئات نريد التنبّؤ بها. يمكن مثلًا تجميع الصفوف بحسب ساعات الدراسة، الحضور والنوم. وهذا مثال على التعلّم غير الخاضع للإشراف: اكتشاف أنماط في البيانات دون تقديم إجابات مستهدفة. ثم ينبغي تفسير المجموعات الناتجة. راجع طرق التجميع في scikit-learn.
كشف القيم الشاذة يرصد القيم أو الحالات غير المعتادة. تستدعي القيمة 101 في عمود Exam_Score، والموجودة في الملف، التحقّق من مقياس الدرجات والمصدر، ولا ينبغي حذفها تلقائيًا. قد تكفي قاعدة لتحديد هذه القيمة، بينما يمكن للنموذج البحث عن تركيبات غير معتادة. راجع طرق كشف القيم الشاذة في scikit-learn.
أنظمة التوصية تقترح عناصر يُعتقد أنها مناسبة. تتطلّب التوصية بمورد دراسي معلومات عن الموارد واستخدامها، وهي غير موجودة في هذا الجدول. أمّا التعلّم بالتعزيز (Reinforcement learning) فيتعلّم كيفية اختيار الإجراءات بالاستفادة من نتائجها والمكافآت. لا يصف عدد جلسات الدعم الدراسي تسلسلًا من الإجراءات ونتائجها؛ لذا لا يتيح ملف Excel وحده عرض هذا النوع من التعلّم. تجيب هذه المفاهيم عن أسئلة مختلفة، والتعلّم بالتعزيز نمط من أنماط التعلّم. راجع مقدّمة Google إلى التعلّم بالتعزيز.
ماذا يوضح الرسم البياني لساعات الدراسة والدرجات؟
يعرض الشكل 5 أول 100 صف من ملف Excel. وتمثّل كلّ نقطة فيروزية ساعات الدراسة ودرجة مسجّلة في الملف.
كيف نقرأ الخط الأحمر؟ إنه خط انحدار خطي: عند عدد معيّن من الساعات، يشير ارتفاعه إلى الدرجة التي يقدّرها نموذج يستخدم ساعات الدراسة فقط. يُحسب هذا الخط من النقاط المئة المعروضة بتقليل مجموع مربّعات الفروق الرأسية بين الدرجات المسجّلة والخط، وفق شرح NIST لطريقة المربّعات الصغرى.
يلخّص ميله التصاعدي الطفيف الاتجاه في هذا المقتطف. وتوضح النقاط الواقعة فوقه أو تحته اختلاف الدرجات الحقيقية عن التقدير. لا تثبت هذه العلاقة أن زيادة ساعات الدراسة تسبّب ارتفاع الدرجة، ولا تزال موثوقية النموذج في الحالات الجديدة بحاجة إلى تقييم.
كيف ينتج نموذج اللغة نصًا؟
يعالج النموذج النص بوحدات تُسمّى Tokens. وقد تمثّل الوحدة كلمة كاملة، جزءًا من كلمة، حرفًا، رقمًا، مسافة أو علامة ترقيم، بحسب النظام. تتمثّل آلية شائعة في تعلّم التنبّؤ بالوحدة التالية انطلاقًا من النص السابق. وتُستخرج إجابة التدريب من النص نفسه؛ وهذا هو التعلّم ذاتي الإشراف. وأثناء التوليد، ينتج النموذج هذه الوحدات تدريجيًا لتكوين النص. تشرح هذه الآليات جزءًا من قدراته، دون ضمان صحة النص الناتج. راجع شرح آلية عمل نماذج اللغة الكبيرة لدى Google.
استخدامات حديثة لفهمها بعد الأسس
النماذج متعددة الوسائط، RAG، AI Agents والنماذج التي تعمل على الجهاز: أمثلة بتاريخ 8 أكتوبر 2026
النماذج متعددة الوسائط (Multimodal). تعالج أنواعًا متعدّدة من المعلومات، مثل النص والصورة. يمكن للواجهة قبول لقطة للجدول وسؤال عن عمود، لكن ينبغي أن تستند الحسابات الموثوقة إلى الخلايا نفسها. تعرض وثائق Gemma قدرات تختلف باختلاف النماذج.
RAG: الاستعانة بالمصادر لإعداد الإجابة. تبحث هذه الطريقة عن مقاطع مناسبة في الوثائق، ثم تقدّمها إلى النموذج ليستخدمها عند إعداد إجابته. يمكن للمساعد مثلًا البحث عن تعريف عمود في وصف بيانات ملف Excel. يضيف ذلك سياقًا للإجابة دون أن يستلزم إعادة تدريب النموذج، ودون أن يزيل كل الأخطاء. راجع شرح Google Cloud لطريقة RAG.
AI Agents. يمكن للمساعد تحديد خطوات واستخدام أدوات لتحقيق هدف؛ كالبحث عن تعريف، ثم استخدام أداة حساب لعدّ الخلايا الفارغة. ينبغي التحقّق من النتائج وصلاحيات الوصول. هذا السلوك وحده ليس مثالًا على التعلّم بالتعزيز. راجع شرح Anthropic للفرق بين Workflow وAI Agents.
نماذج تعمل على الجهاز. يمكن تشغيل بعض النماذج بأحجام مناسبة على حاسوب متوافق. وقد نستخدمها لشرح أوصاف الأعمدة. تختلف احتياجات الذاكرة والقدرات، وقد تستمرّ مكوّنات أخرى من التطبيق في إرسال البيانات. راجع أحجام نماذج Gemma ومتطلبات تشغيلها.
المصادر وترتيب القراءة المقترح
- لتعزيز الأسس: مقدّمة تعلّم الآلة، ثم الفصول المناسبة من دورة Google المكثّفة في تعلّم الآلة. ويمكن الرجوع إلى دليل Google لمصطلحات تعلّم الآلة عند الحاجة إلى شرح مصطلح.
- لتنظيم مشروع: صياغة مشكلة تعلّم الآلة وإدارة مشروع تعلّم آلة.
- للتعريفات المرجعية: منظمة التعاون الاقتصادي والتنمية (2024)، Explanatory memorandum on the updated OECD definition of an AI system، OECD Artificial Intelligence Papers، العدد 8، المعرّف الرقمي: 10.1787/623da898-en؛ وLeCun, Y.، Bengio, Y. وHinton, G. (2015)، التعلّم العميق، Nature، المجلّد 521، الصفحات 436–444، المعرّف الرقمي: 10.1038/nature14539.
- لبيانات هذا الدرس: Student Performance Factors — Lai Ng.، Kaggle. جرى التحقّق من القيم المعروضة في ورقتَي «Données» و«Description des champs» من ملف Excel StudentPerformanceFactors.xlsx بتاريخ 8 أكتوبر 2026.
