Compréhensions Python, enumerate et zip : transformer des collections
Les compréhensions Python permettent de construire une collection en exprimant le parcours des données, la transformation à appliquer et, si nécessaire, une condition de sélection. Elles deviennent utiles lorsque plusieurs lignes de boucle ne font qu’ajouter un résultat à une liste. Avec enumerate, vous pouvez aussi numéroter les éléments parcourus ; avec zip, vous pouvez lire ensemble les valeurs de plusieurs colonnes.
Cette leçon part d’une boucle connue, puis montre comment écrire la même opération autrement. Vous apprendrez à distinguer un filtre d’un choix de valeur, à conserver les correspondances entre deux listes et à réunir ces outils dans une fonction réutilisable.
Avant de commencer. Vous devez connaître les listes, les dictionnaires, les conditions et la boucle for, présentés dans les bases de Python. Ouvrez le notebook dans VS Code et sélectionnez le noyau de votre environnement .venv. Les exemples ont été exécutés avec Python 3.14.8 ; zip(..., strict=True) nécessite Python 3.10 ou plus récent. Aucune bibliothèque supplémentaire n’est utilisée.
Téléchargez le notebook et son exercice corrigé. L’archive contient ComprehensionsEnumerateZip.ipynb et une courte notice. Décompressez l’archive, ouvrez le notebook, puis choisissez « Exécuter tout ». Les petites listes sont incluses : vous n’avez pas de classeur à charger. Si le noyau n’est pas disponible, reprenez la préparation de Python, VS Code et Jupyter.
Sommaire
Lire une compréhension Python à partir d’une boucle
Une compréhension de liste est une expression qui crée une nouvelle liste. Elle indique le parcours, la valeur à produire et, éventuellement, une condition de sélection. La documentation Python sur les compréhensions présente cette syntaxe.
Pour nos transformations, reprenons les huit premières observations de Student Performance Factors. Hours_Studied désigne les heures d’étude par semaine ; Attendance, le pourcentage de cours suivis. Les valeurs des deux colonnes gardent leur ordre d’origine.
| Position dans l’extrait | Hours_Studied | Attendance |
|---|---|---|
| 1 | 23 | 84 |
| 2 | 19 | 64 |
| 3 | 24 | 98 |
| 4 | 29 | 89 |
| 5 | 19 | 92 |
| 6 | 19 | 88 |
| 7 | 29 | 84 |
| 8 | 25 | 78 |
# Reprendre les huit premières observations dans leur ordre d'origine.
heures_etude = [23, 19, 24, 29, 19, 19, 29, 25]
presences = [84, 64, 98, 89, 92, 88, 84, 78]

print(heures_etude)
print(presences)[23, 19, 24, 29, 19, 19, 29, 25]
[84, 64, 98, 89, 92, 88, 84, 78]La première durée correspond à la première présence : 23 et 84 appartiennent à la même observation. Le numéro de position est un repère pour lire l’extrait, sans compter l’en-tête. Il ne constitue pas un identifiant d’élève.
Commencer par une transformation explicite
Pour convertir les heures en minutes, vous pouvez créer une liste vide, parcourir les durées et ajouter chaque valeur multipliée par 60. Cette écriture permet de suivre séparément les trois opérations.
# Construire une nouvelle liste sans modifier les durées d'origine.
minutes_boucle = []
for heures in heures_etude:
    minutes_boucle.append(heures * 60)

print(minutes_boucle)[1380, 1140, 1440, 1740, 1140, 1140, 1740, 1500]La nouvelle liste contient huit durées en minutes, dans le même ordre que les valeurs de départ. Les durées répétées sont conservées : les trois occurrences de 19 heures donnent chacune 1140 minutes, et les deux occurrences de 29 heures donnent chacune 1740 minutes. La multiplication change l’unité ; elle ne modifie pas les nombres de la liste heures_etude.
Placer l’expression dans la nouvelle liste
Une compréhension réunit la construction du résultat en une expression. Dans [heures * 60 for heures in heures_etude], la partie for heures in heures_etude fournit les éléments successifs ; heures * 60 calcule la valeur à ajouter au résultat.
# Exprimer la transformation directement dans la construction de la liste.
minutes = [heures * 60 for heures in heures_etude]

print(minutes)
print(minutes == minutes_boucle)
print(heures_etude)[1380, 1140, 1440, 1740, 1140, 1140, 1740, 1500]
True
[23, 19, 24, 29, 19, 19, 29, 25]Le résultat est identique à celui de la boucle, comme le confirme True. Les compréhensions Python conviennent à ce type de transformation courte. Si chaque tour exige plusieurs vérifications ou une gestion d’exceptions, une boucle explicite peut rester plus facile à lire et à corriger.
Filtrer une liste ou choisir une valeur pour chaque élément
Un if placé après le parcours sélectionne les éléments à conserver. Prenons un seuil de 20 heures pour observer ce fonctionnement. Les trois occurrences de 19 heures sont écartées. Les cinq durées retenues, 23, 24, 29, 29 et 25 heures, sont ensuite converties en minutes.
# Conserver les cinq durées d’au moins 20 heures, puis les convertir.
minutes_retenues = [h * 60 for h in heures_etude if h >= 20]

print(minutes_retenues)[1380, 1440, 1740, 1740, 1500]
Dans cette compréhension, h prend chaque valeur de la liste et la condition h >= 20 est examinée avant de produire h * 60. Le résultat contient donc cinq éléments, dans l’ordre où les durées retenues apparaissent dans la liste de départ.
Distinguer le filtre de l’expression conditionnelle
Vous pouvez aussi conserver chaque élément et lui attribuer un libellé selon une condition. Dans ce cas, le if ... else appartient à l’expression qui produit la valeur, avant le for.
# Donner un libellé à chacune des huit durées.
reperes = [
    "20 h ou plus" if h >= 20 else "moins de 20 h"
    for h in heures_etude
]

print(reperes)['20 h ou plus', 'moins de 20 h', '20 h ou plus', '20 h ou plus', 'moins de 20 h', 'moins de 20 h', '20 h ou plus', '20 h ou plus']Cette seconde liste contient huit libellés, un pour chaque durée de départ. Le filtre final répond à la question « faut-il garder cet élément ? ». L’expression conditionnelle répond à « quelle valeur faut-il produire pour cet élément ? ». Cette distinction explique la place différente du if dans les deux écritures.
Numéroter les éléments avec enumerate
La fonction native enumerate associe un compteur à chaque élément d’un itérable, c’est-à-dire d’un objet que l’on peut parcourir avec for, comme une liste. Chaque étape fournit un couple (compteur, valeur), sous la forme d’un tuple, une séquence de valeurs. La forme for numero, heures in ... place ces deux éléments dans deux variables. Avec l’argument start=1, notre compteur commence à 1. Voir la définition de enumerate.
# Numéroter les positions de l'extrait à partir de 1.
for numero, heures in enumerate(heures_etude, start=1):
print(f"Observation {numero} : {heures} h")Observation 1 : 23 h
Observation 2 : 19 h
Observation 3 : 24 h
Observation 4 : 29 h
Observation 5 : 19 h
Observation 6 : 19 h
Observation 7 : 29 h
Observation 8 : 25 hVous n’avez pas à gérer un compteur séparé ni à retrouver chaque valeur avec heures_etude[indice]. Le numéro et la durée sont fournis ensemble pendant le parcours.
Sans préciser start, le compteur commence à zéro. Dans ce parcours de la liste complète, dans son ordre d’origine, les compteurs correspondent aussi aux indices des valeurs. Affichons les couples pour le vérifier.
# Afficher les couples (compteur, valeur) à partir de zéro.
print(list(enumerate(heures_etude)))
print(heures_etude[0])[(0, 23), (1, 19), (2, 24), (3, 29), (4, 19), (5, 19), (6, 29), (7, 25)]
23Le réglage du compteur ne change pas l’indexation de la liste : heures_etude[0] reste 23, même si vous choisissez d’afficher « Observation 1 ». Les compréhensions Python peuvent réutiliser ces couples lorsque le numéro doit être conservé dans un résultat.
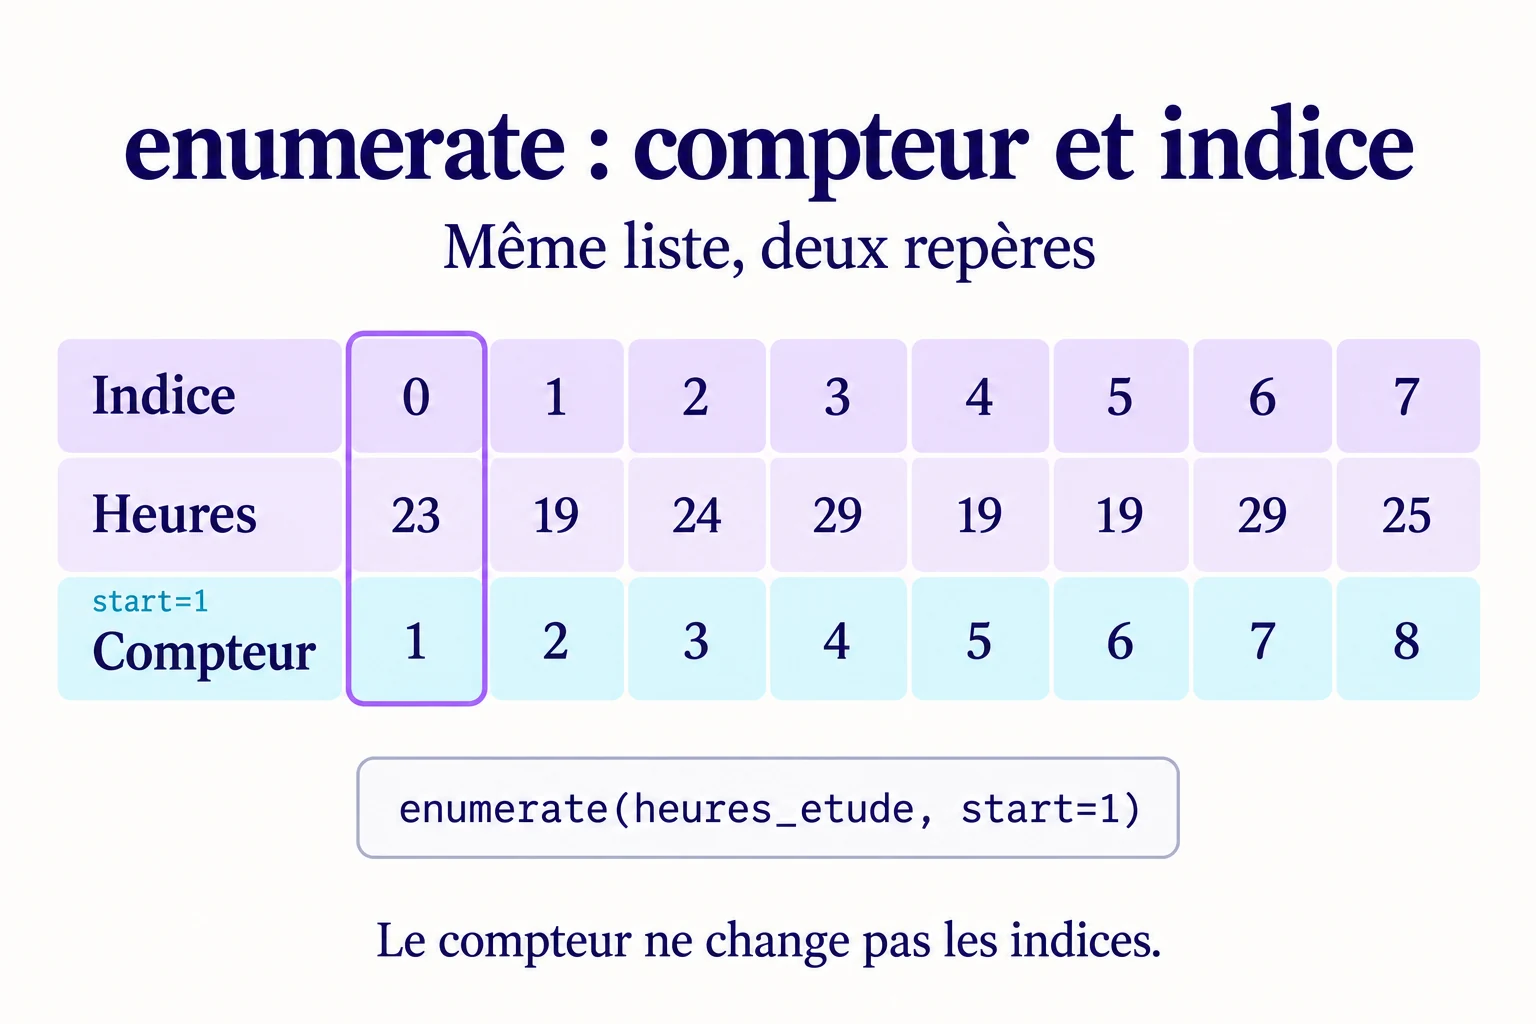
(1, 23) ; l’accès par indice reste heures_etude[0].Associer les valeurs de plusieurs colonnes avec zip
zip parcourt plusieurs itérables en parallèle et fournit un tuple composé des valeurs de même position. Il associe ici les heures à la présence correspondante. Vous pouvez décomposer ce tuple directement dans la boucle, sans créer d’abord une liste intermédiaire. La documentation de zip précise ses règles de parcours.
# Associer durée et présence de la même observation.
for heures, presence in zip(heures_etude, presences, strict=True):
print(f"{heures} h ; présence : {presence} %")23 h ; présence : 84 %
19 h ; présence : 64 %
24 h ; présence : 98 %
29 h ; présence : 89 %
19 h ; présence : 92 %
19 h ; présence : 88 %
29 h ; présence : 84 %
25 h ; présence : 78 %Les huit associations restent celles du tableau. Les trois occurrences de 19 heures sont ainsi associées à des présences différentes : 64, 92 et 88 %. La valeur seule ne suffit donc pas à retrouver une observation ; sa position dans l’extrait compte. Le rôle de zip est d’associer les positions ; il ne recherche pas de correspondance dans une colonne d’identifiants et ne trie pas les données.

Vérifier les longueurs avec strict=True
Par défaut, zip s’arrête à la collection la plus courte. Ce comportement peut être souhaité, mais il peut aussi masquer une colonne incomplète. Pour deux colonnes censées décrire les mêmes observations, strict=True demande des longueurs égales. Cette option a été introduite avec Python 3.10, comme l’explique la PEP 618.
Dans le bloc suivant, la tranche [:-1] enlève uniquement la dernière présence afin de rendre le problème visible. Le premier affichage ne contient plus que sept couples : la dernière observation, (25, 78), a disparu. Le second parcours signale la différence de longueur.
# Retirer la dernière présence uniquement pour montrer le contrôle.
presences_incompletes = presences[:-1]
print(list(zip(heures_etude, presences_incompletes)))

# Signaler la différence de longueur plutôt que perdre une observation.
try:
    list(zip(heures_etude, presences_incompletes, strict=True))
except ValueError as erreur:
print(f"{type(erreur).__name__} : {erreur}")[(23, 84), (19, 64), (24, 98), (29, 89), (19, 92), (19, 88), (29, 84)]
ValueError : zip() argument 2 is shorter than argument 1La vérification intervient pendant le parcours de l’itérateur. Créer simplement l’objet avec zip(..., strict=True) ne suffit donc pas à déclencher l’erreur. Ici, list() le consomme complètement. Une boucle qui s’arrête prématurément peut aussi ne pas atteindre l’endroit où la différence serait détectée.
Conserver un résultat si vous devez le relire
zip et enumerate renvoient des itérateurs : ils fournissent les éléments au fil du parcours, sans construire eux-mêmes une liste complète. Un itérateur épuisé ne recommence pas au début. Ce comportement explique un résultat vide lors d’un second affichage.
# Consommer le même itérateur deux fois.
paires = zip(heures_etude, presences, strict=True)
print(list(paires))
print(list(paires))[(23, 84), (19, 64), (24, 98), (29, 89), (19, 92), (19, 88), (29, 84), (25, 78)]
[]Si les couples doivent être parcourus plusieurs fois, stockez le résultat de list(zip(heures_etude, presences, strict=True)) et réutilisez cette liste. À partir des listes de départ, vous pouvez aussi recréer l’appel à zip à chaque parcours. Pour un seul parcours, utilisez directement zip dans la boucle.
Construire un dictionnaire ou un ensemble par compréhension
Les compréhensions Python ne concernent pas seulement les listes. Dans une compréhension de dictionnaire, les accolades encadrent une expression cle: valeur suivie du parcours. Dans notre conversion, nous pouvons utiliser la position comme clé et la durée en minutes comme valeur.
# Associer chaque numéro de position à sa durée en minutes.
minutes_par_position = {
    numero: heures * 60
    for numero, heures in enumerate(heures_etude, start=1)
}

print(minutes_par_position){1: 1380, 2: 1140, 3: 1440, 4: 1740, 5: 1140, 6: 1140, 7: 1740, 8: 1500}La clé 2 permet ainsi de retrouver 1140 minutes. Les clés générées par notre compteur sont distinctes. Si une compréhension produit plusieurs fois la même clé, le dictionnaire conserve la dernière valeur produite pour cette clé ; il ne stocke pas automatiquement plusieurs valeurs.
Dans une compréhension d’ensemble, une expression suivie du parcours est placée entre accolades, sans paire clé-valeur. Chaque valeur distincte n’est conservée qu’une fois. Les huit premiers niveaux de Access_to_Resources contiennent cinq occurrences de Medium, deux de High et une de Low. Nous gardons ces libellés tels qu’ils figurent dans les données.
# Reprendre les huit premiers niveaux d'accès aux ressources.
acces_ressources = [
    "High", "Medium", "Medium", "Medium",
    "Medium", "Medium", "Low", "High",
]
niveaux_distincts = {niveau for niveau in acces_ressources}

print(sorted(niveaux_distincts))['High', 'Low', 'Medium']Cette ligne crée un ensemble (set) : Un ensemble ne conserve qu’une seule occurrence de chaque valeur. Il reste donc trois niveaux : "High", "Medium" et "Low".
L’ensemble contient trois niveaux distincts, alors que la liste de départ comporte huit éléments. L’ordre des éléments d’un ensemble n’est pas garanti ; sorted() renvoie ici une liste triée pour rendre l’affichage prévisible. Attention : {} crée un dictionnaire vide ; pour créer un ensemble vide, utilisez set(). Choisissez donc la structure selon le résultat attendu : une liste pour la séquence produite, un dictionnaire pour des associations clé-valeur et un ensemble pour des valeurs distinctes.
Combiner enumerate et zip en conservant la position d’origine
Vous pouvez maintenant lire un numéro et les valeurs de deux colonnes dans le même parcours. zip fournit le couple (heures, presence) ; enumerate y associe un numéro. Les parenthèses autour de (heures, presence) indiquent comment décomposer le couple intérieur.
# Lire le numéro, la durée et la présence dans une même boucle.
for numero, (heures, presence) in enumerate(
    zip(heures_etude, presences, strict=True), start=1
):
print(f"{numero} : {heures} h ; {presence} %")1 : 23 h ; 84 %
2 : 19 h ; 64 %
3 : 24 h ; 98 %
4 : 29 h ; 89 %
5 : 19 h ; 92 %
6 : 19 h ; 88 %
7 : 29 h ; 84 %
8 : 25 h ; 78 %Cette écriture prépare la mise en pratique. Pour conserver la position d’origine après une sélection, il faut ajouter le compteur avant le filtre. Numéroter une liste déjà filtrée donnerait seulement la nouvelle position dans cette liste réduite.
Exercice : préparer des observations avec les compréhensions Python
Réutilisons les mêmes huit observations, toujours dans leur ordre d’origine. Écrivez une fonction preparer_observations(heures, presences, minimum_heures=20, minimum_presence=85) qui renvoie une liste de dictionnaires.
# Utiliser les huit premières observations, sans modifier leur ordre.
heures_exercice = [23, 19, 24, 29, 19, 19, 29, 25]
presences_exercice = [84, 64, 98, 89, 92, 88, 84, 78]

print(len(heures_exercice), len(presences_exercice))8 8- Parcourez les deux listes avec
zip(..., strict=True). - Conservez les observations dont les heures et la présence atteignent les deux seuils.
- Gardez le numéro de position d’origine, à partir de
1, dans la cléposition. - Enregistrez la durée convertie dans
minuteset la présence danspresence. - Préservez les listes reçues ; avec deux listes vides, renvoyez
[].
Les seuils servent uniquement à exercer la sélection. Les deux observations retenues doivent garder les positions 3 et 4. Essayez d’abord d’écrire le parcours, puis transformez-le en compréhension si l’ensemble reste lisible.
Afficher la correction et ses vérifications
La fonction renvoie une nouvelle collection ; l’affichage reste à l’extérieur. Le compteur est associé aux données avant le if, ce qui préserve les positions d’origine.
def preparer_observations(
    heures, presences, minimum_heures=20, minimum_presence=85
):
    """Renvoyer les observations retenues avec leur position d'origine."""
    return [
        {"position": numero, "minutes": h * 60, "presence": p}
        for numero, (h, p) in enumerate(
            zip(heures, presences, strict=True), start=1
        )
        if h >= minimum_heures and p >= minimum_presence
    ]

# Afficher chaque observation retenue sur une ligne.
selection = preparer_observations(heures_exercice, presences_exercice)
for observation in selection:
print(observation){'position': 3, 'minutes': 1440, 'presence': 98}
{'position': 4, 'minutes': 1740, 'presence': 89}Le résultat contient 1440 minutes et 98 % à la position 3, puis 1740 minutes et 89 % à la position 4. La première observation est exclue car sa présence vaut 84 %, même si sa durée atteint le seuil requis.
Les assertions suivantes vérifient le résultat, le cas vide et la conservation des listes. Le dernier appel abaisse les seuils pour garder les huit observations, y compris celle dont la présence vaut exactement 64 %.
# Vérifier les positions et les valeurs renvoyées.
assert selection == [
    {"position": 3, "minutes": 1440, "presence": 98},
    {"position": 4, "minutes": 1740, "presence": 89},
]
assert preparer_observations([], []) == []
assert heures_exercice == [23, 19, 24, 29, 19, 19, 29, 25]
assert presences_exercice == [84, 64, 98, 89, 92, 88, 84, 78]
assert len(preparer_observations(
    heures_exercice, presences_exercice,
    minimum_heures=19, minimum_presence=64
)) == 8

print("Résultat, cas vide et listes d'origine vérifiés.")Résultat, cas vide et listes d'origine vérifiés.Si la fonction devient plus complexe, vous pouvez conserver une boucle explicite et appeler de petites fonctions pour les transformations. L’objectif des compréhensions Python reste de rendre l’opération facile à comprendre, sans tout compacter à tout prix.
Éviter les pertes de correspondance et les expressions difficiles à lire
- Filtrer chaque colonne séparément. Si vous retirez
19de la liste des heures sans retirer la présence correspondante, les positions suivantes ne correspondent plus les mêmes observations. Associez d’abord les colonnes, puis filtrez les paires. - Faire confiance à la longueur seule. Deux listes de même longueur peuvent être mal alignées si l’une a été triée indépendamment.
strict=Truecontrôle la longueur, pas le sens des associations. - Réutiliser un itérateur déjà parcouru. Un second
list(paires)peut renvoyer[]. Recréez le parcours ou conservez les couples dans une liste si leur réutilisation est nécessaire. - Accumuler les conditions et les boucles imbriquées. Si vous devez décomposer chaque fragment pour comprendre le résultat, revenez à des étapes nommées et à une boucle explicite.
Une nouvelle collection ne garantit pas non plus une copie indépendante de tous les objets qu’elle contient. Si vous manipulez des listes ou des dictionnaires imbriqués, les règles de références restent celles expliquées dans la leçon sur la mutabilité et les copies.
Choisir l’outil selon le résultat à construire
Pour transformer ou filtrer une collection en une opération lisible, une compréhension fournit directement le nouvel objet. Pour conserver un repère de position, utilisez enumerate. Pour parcourir plusieurs colonnes correspondantes, utilisez zip et vérifiez leurs longueurs lorsque l’égalité est attendue. Ces outils se combinent, mais chaque étape doit rester compréhensible.
